我的二值向量搜索比你的 FP32 向量更强
在向量搜索领域,一项引人注目的技术进展正在兴起:二值向量搜索(binary vector search)。这种方法有望通过实现惊人的 30 倍内存缩减,攻克长期存在的内存消耗难题。然而,一个引发广泛讨论的关键问题是:它会对检索精度产生怎样的影响?
我们认为,将二值向量搜索与特定的优化技术相结合,完全可以保持相近的检索精度。为了阐明这一点,我们将在本文中展示一系列实验,演示该方法的实际效果及其重要意义。
什么是二值向量?
二值向量(binary vector)是一种将向量中的每个元素编码为二值(通常为 0 或 1)的向量表征形式。这种编码方案将原本包含实数值或高维浮点数据的原始向量转换为二值格式。
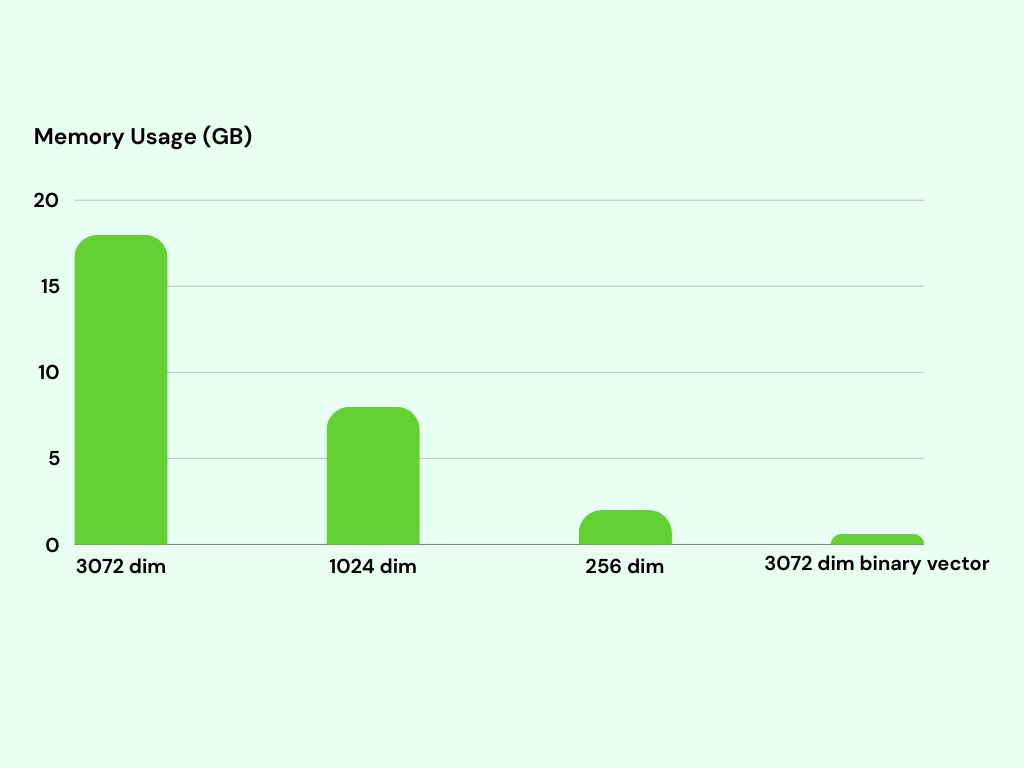
二值向量存储每个元素仅需 1 比特(bit)内存,而原始的 float32 向量存储每个元素则需要 4 字节(32 bit)。这意味着使用二值向量可以将内存占用减少高达 32 倍。此外,内存需求的下降还伴随着二值向量运算每秒请求数(RPS)的显著提升。
不妨看一个例子:假设我们有 100 万个向量,每个向量由 3072 维空间中的 float32 值表示。在这种情况下,原始的 float32 向量索引大约需要 20 GB 内存来存储这 100 万个向量。
现在,如果我们改用二值向量,内存占用将大幅下降:二值向量索引大约只需 600 MB 即可存储全部 100 万个向量。
不过,人们通常预计这种内存缩减会导致精度大幅下降,因为二值向量丢失了大量原始信息。
出乎意料的是,我们的实验表明,精度的下降幅度远没有预想的那么大。尽管二值向量丢失了一些具体细节,但它们依然能够捕捉到关键的模式与相似性特征,从而维持相当可观的准确率。
实验评估
为了评估其与原始向量方法相比的性能指标,我们使用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集进行了基准测试。测试运行在 Google Cloud 的 n2-standard-8 虚拟机(VM)上(配备 8 个 vCPU 和 32GB 内存),并使用 pgvecto.rs v0.2.1 作为向量数据库。
向数据库表中插入 100 万个向量后,我们分别为原始 float32 向量和二值向量构建了索引:
索引构建完成后,我们执行了向量搜索查询以评估性能。这些查询设置了不同的返回数量上限(limit 5、10、50、100)。
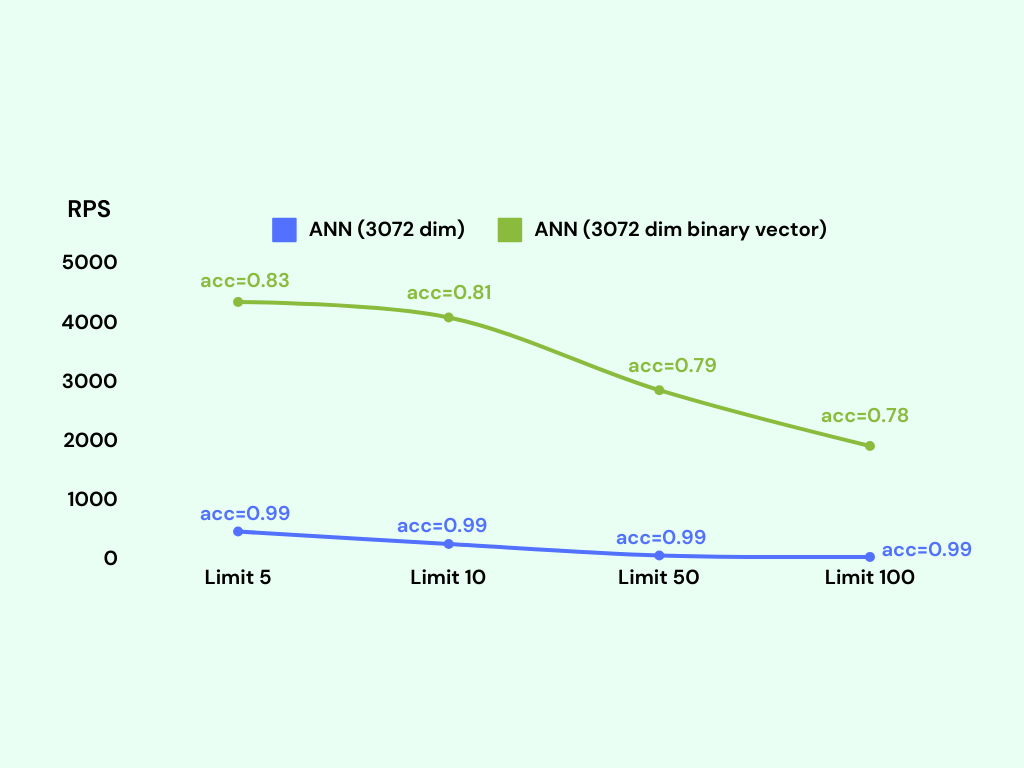
我们观察到,二值向量搜索的每秒请求数(RPS)约为 3000,而原始向量搜索的 RPS 仅为 300 左右。
RPS 指标代表系统每秒能够处理的请求或查询数量。更高的 RPS 值意味着更高的吞吐量和更快的响应速度。
不过,与原始向量搜索相比,二值向量搜索的准确率下降到了约 80%。虽然在某些场景下这种幅度的下降尚可接受,但在对高精度有严格要求的业务场景中,80% 的准确率显然是不够的。
优化:自适应检索(Adaptive Retrieval)
幸运的是,我们从 Matryoshka 表征学习(MRL)中借鉴了一种简单而有效的方法——自适应检索(adaptive retrieval),用以提升准确率。
名字听起来有些复杂,但自适应检索背后的核心思想非常直观。假设我们想要找出最佳的 100 个候选结果,可以分两步走:
-
查询二值向量索引,从 100 万个嵌入向量中快速召回一个更大的候选集(例如 200 个候选结果)。这一步操作极快。
-
使用全精度 KNN 查询对候选集进行重排序(rerank),从中选出最终的 Top 100 结果。请注意,这里我们运行的是精确的 KNN 而非近似的 ANN。KNN 非常适合在小规模集合上进行精确的相似度计算,因此是此处重排序的理想选择。
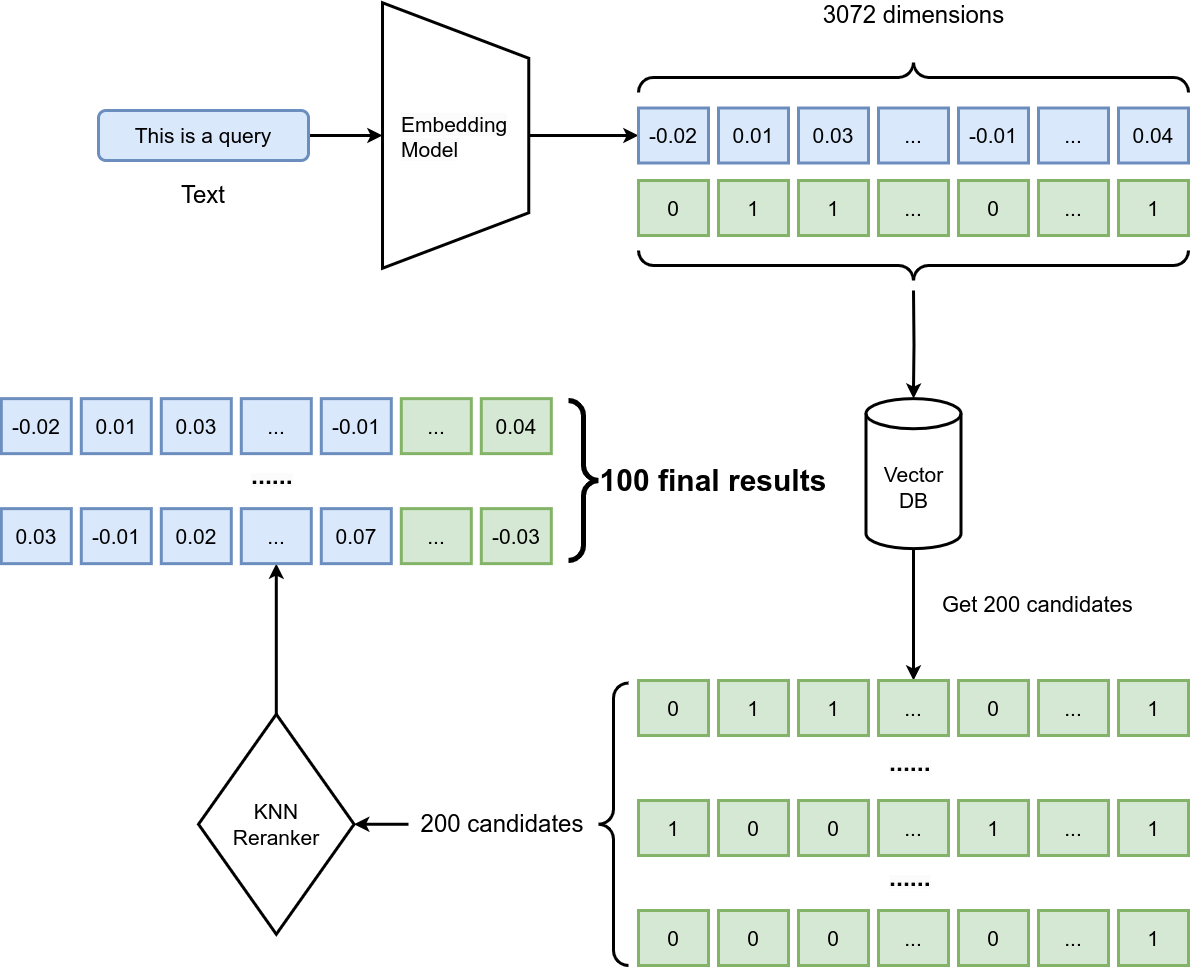
通过引入这一重排序步骤,我们可以实现准确率的显著跃升——最高可达 95%!与此同时,系统依然保持着约 1700 的高 RPS。更重要的是,尽管精度得到了大幅提升,索引的内存占用依然比原始向量表征小约 30 倍。
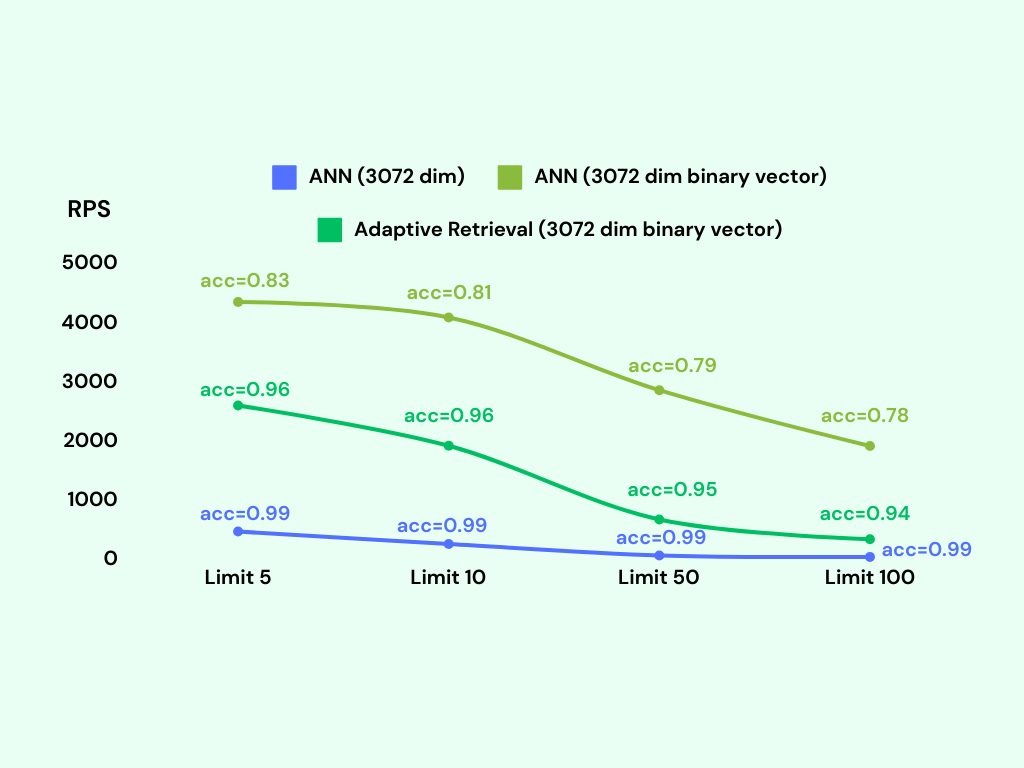
以下是用于执行自适应检索的 SQL 代码:
与截断降维向量(Shortening Vectors)的对比
OpenAI 最新的嵌入模型 text-embedding-3-large 提供了一项允许用户截断缩短向量(shorten vectors)的功能。

该模型默认生成 3072 维的嵌入向量,但你可以安全地移除序列末尾的一部分数值,同时仍然保留对文本的有效表征。例如,你可以将嵌入向量截断缩短至 1024 维。
这项功能同样可以帮助你节省内存并加快请求处理速度,效果与二值向量类似。因此,将两者的性能进行对比,看看哪一种更适合你的需求是一个很好的主意。
基于我们的测试结果,结论非常明确:二值向量的表现显著优于截断缩短后的向量。
我们执行了类似的基准测试以与二值向量进行对比:使用相同的数据集和机器配置创建了两个不同维度的索引,一个为 256 维,另一个为 1024 维。
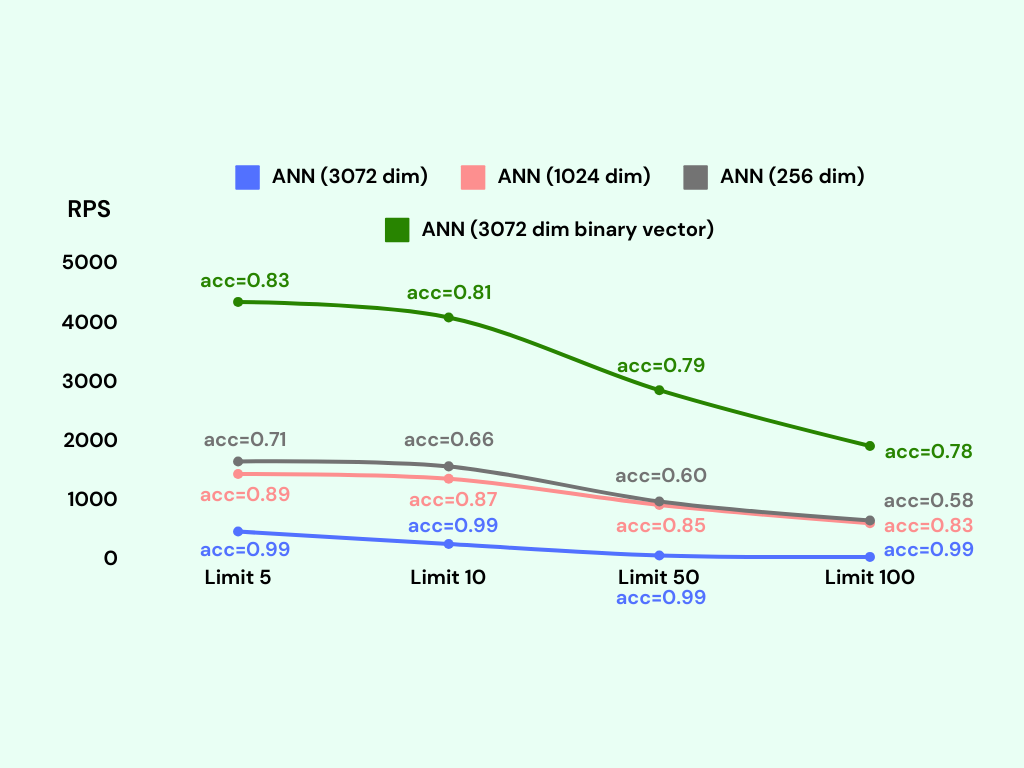
1024 维索引在 1000 RPS 的吞吐量下达到了约 85% 的准确率;而 256 维索引虽然达到了 1200 RPS 的更高吞吐量,但准确率仅有 60% 左右。
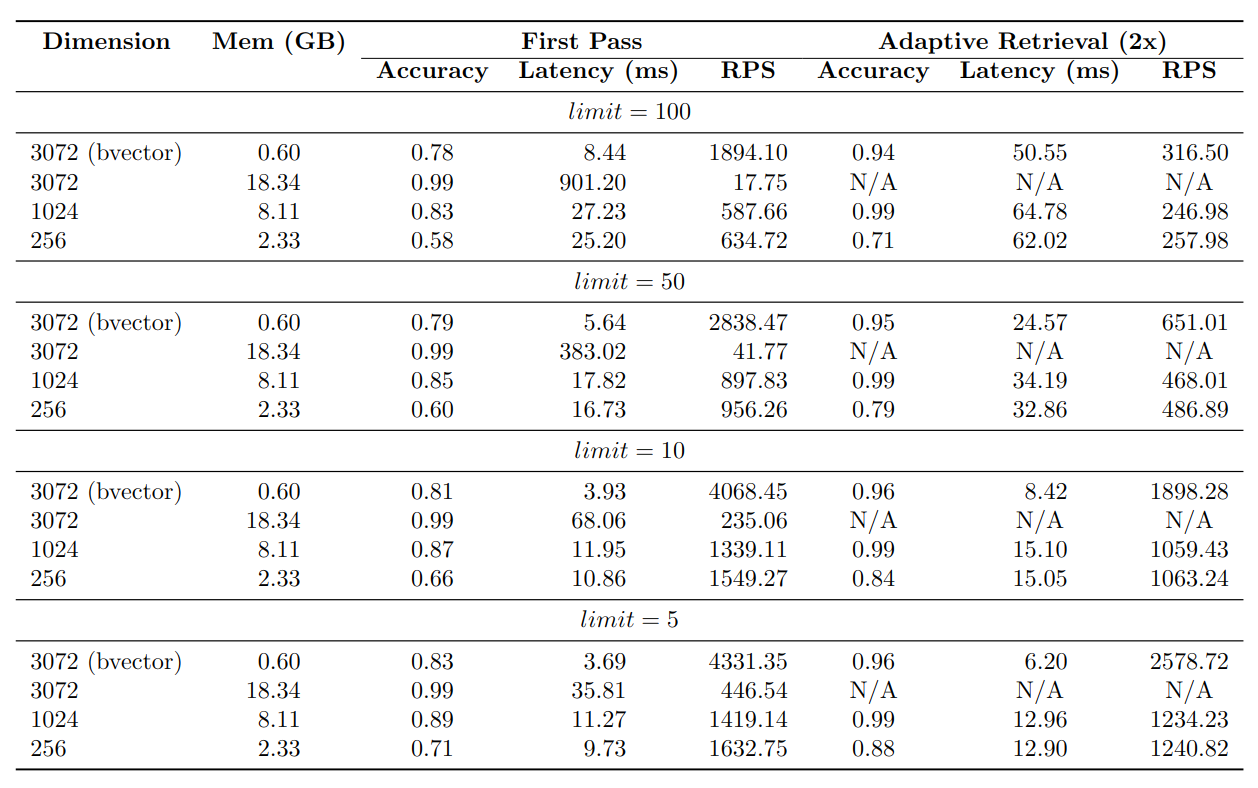
在内存占用方面,1024 维索引大约需要 8GB 内存,256 维索引大约需要 2GB 内存。相比之下,二值向量方法仅用约 600MB 内存,就在 3000 RPS 的吞吐量下达到了约 80% 的准确率。
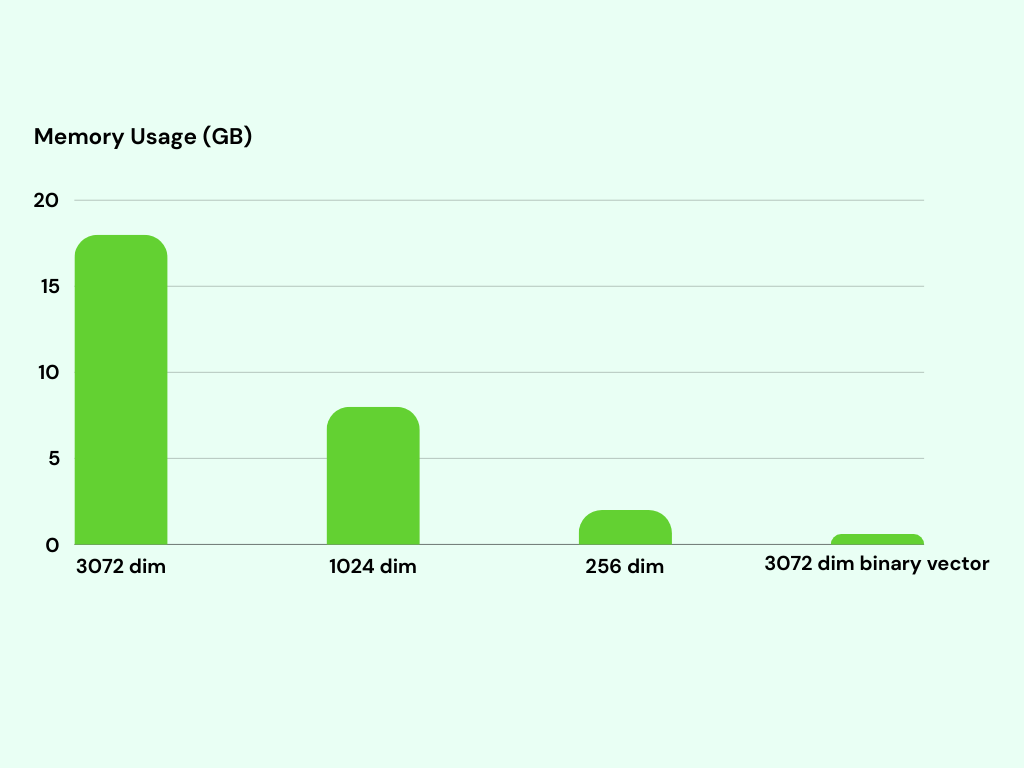
随后,我们又在低维索引上同样应用了自适应检索。结果显示,无论是在请求吞吐量(RPS)还是准确率上,二值向量索引依然全面优于 256 维索引,同时内存占用也更低。另一方面,结合自适应检索的 1024 维索引虽然达到了 99% 的更高准确率,但它的请求吞吐量相对较低,且消耗的内存是二值向量索引的 12 倍以上。
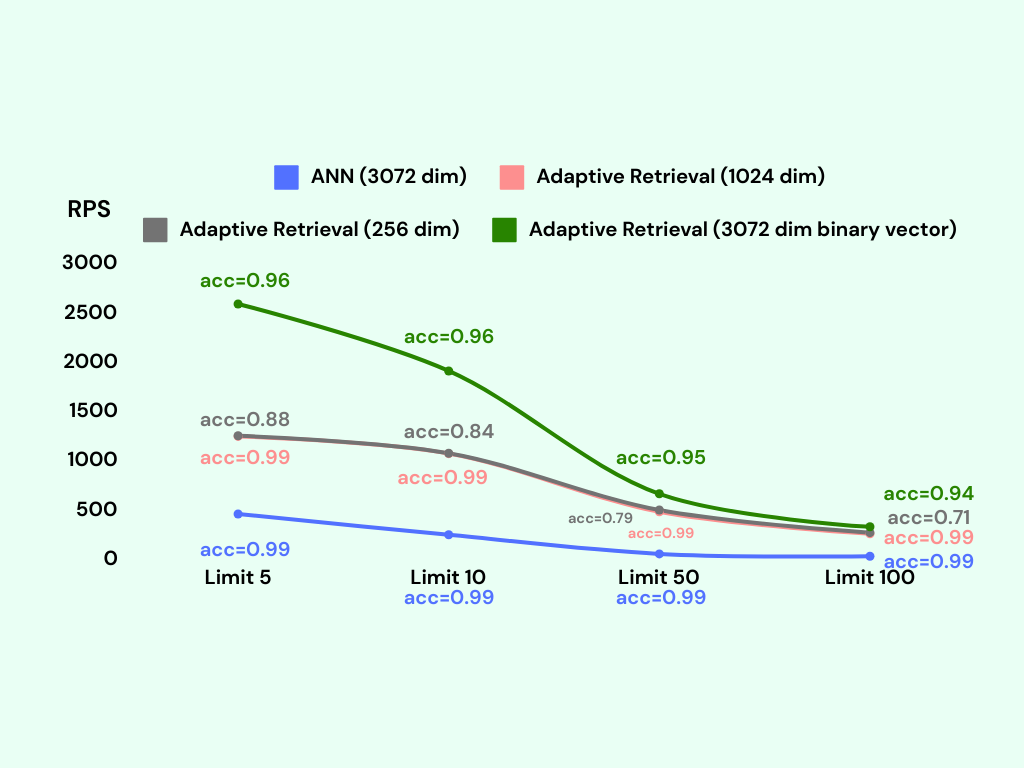
总结
通过采用自适应检索技术,二值向量能够在保持高水平准确率的同时,将内存占用大幅降低 30 倍。我们在下表中汇总了各项基准测试指标以直观展示结果。需要注意的是,上述实验结论针对的是具备这一特定表征性质的 OpenAI text-embedding-3-large 模型。