这是本节的多页打印视图。
.
返回本页常规视图.
向量类型
在前面的索引和搜索章节中,我们接触了 vector 类型。本节将探讨更多向量类型及其在向量搜索领域的应用。
在前面的索引和搜索章节中,我们已经接触了标准的 vector 类型。本节将探讨更多向量数据类型及其在向量搜索领域的应用:
低精度索引
since v0.3.0
为了提升在 vector 列上的查询速度并降低内存占用,可以考虑使用表达式索引,基于 vecf16、veci8 或 bvector 类型创建低精度索引,而非直接对 vector 类型创建全精度索引:
CREATE TABLE t (val vector(3));
INSERT INTO t (val) SELECT ARRAY[random(), random(), random()]::real[] FROM generate_series(1, 1000);

-- 在 vector 列上创建 bvector 二值向量索引
-- 注意:在构建索引时,Float32 向量会被截断为 0 或 1 的整数
CREATE INDEX lp_bin ON t USING vectors ((binarize(val)::bvector(3)) bvector_l2_ops);

-- 在 vector 列上创建 vecf16 半精度向量索引
CREATE INDEX lp_f16 ON t USING vectors ((val::vecf16(3)) vecf16_l2_ops);

-- 在 vector 列上创建 veci8 整数向量索引
-- 注意:在构建索引时,Float32 向量会被截断为 -128 到 127 之间的整数
CREATE INDEX lp_i8 ON t USING vectors ((val::veci8(3)) veci8_l2_ops);
缩短嵌入向量(Shortening Embedding)
since v0.3.0
部分嵌入模型(例如 OpenAI 的 text-embedding-3-small 和 text-embedding-3-large)支持缩短嵌入向量,即直接移除向量序列末尾的部分数值,而不会丢失嵌入向量的核心概念表达能力。
在某些场景下,可能需要在嵌入生成并入库之后再动态调整检索维度。pgvecto.rs 提供了通过数组切片语法直接使用缩短后的嵌入向量进行查询和建索引的方法:
CREATE TABLE t (val vector(3));
INSERT INTO t (val) SELECT ARRAY[random(), random(), random()]::real[] FROM generate_series(1, 1000);
CREATE INDEX ON t USING vectors (val vector_l2_ops);

-- 仅使用前两个维度计算距离
SELECT * from t ORDER BY (val[:2])::vector(2) <-> '[3, 2]'::vector;
自 v0.3.0 版本起,pgvecto.rs 中的所有向量数据类型均支持缩短嵌入向量切片操作。
类型转换
下图展示了不同向量数据类型之间的转换关系,由箭头连接的两个类型可以相互转换(Cast):
其中,ARRAY 是 PostgreSQL 的原生数组类型,其余均为 pgvecto.rs 定义的向量类型。
以下是向量类型转换的几个示例:
-- 合法:字符串 ⇒ vector
SELECT '{1,2,3}'::vector;

-- 合法:vector ⇒ ARRAY
SELECT '{1,2,3}'::vector::real[];

-- 合法:ARRAY ⇒ vector ⇒ bvector
SELECT ARRAY[1.0 ,0 ,0]::real[]::vector::bvector;

-- 报错:无法直接将类型 vecf16 转换为 veci8
SELECT '[3, 2]'::vecf16::veci8;

-- 合法:vecf16 ⇒ vector ⇒ veci8
SELECT '[3, 2]'::vecf16::vector::veci8;
1 - 半精度向量:`vecf16`
vecf16 以半精度浮点数格式存储,利用 16 位浮点数,与标准 vector 相比仅占用一半的内存和带宽。
vecf16 以半精度数值格式存储,充分利用了 16 位浮点数(FP16)的优势,与标准 32 位浮点数的 vector 相比,仅使用一半的内存和内存带宽。
以下是创建包含 vecf16 列的表并插入数据的示例:
CREATE TABLE items (
  id bigserial PRIMARY KEY,
  embedding vecf16(3) NOT NULL
);

INSERT INTO items (embedding) VALUES ('[0.1, 0.2, 0]'), ('[0, 0.1, 0.2]');
同样可以在 vecf16 类型上创建索引:
CREATE INDEX your_index_name ON items USING vectors (embedding vecf16_l2_ops);

SELECT * FROM items ORDER BY embedding <-> '[0.3,0.2,0.1]' LIMIT 1;
我们支持三种用于计算两个 vecf16 值之间距离的操作符:
<->(vecf16_l2_ops):平方欧氏距离,定义为 Σ(xi−yi)2。<#>(vecf16_dot_ops):负点积,定义为 −Σxiyi。<=>(vecf16_cos_ops):余弦距离,定义为 1−Σxi2Σyi2Σxiyi。
2 - 8 位整数向量:`veci8`
Int8 是用于表示有符号整数的数据类型,使用 8 位内存存储范围在 -128 到 127 之间的整数,显著降低向量存储的内存占用。
since v0.3.0
Int8 是一种用于表示有符号整数的数据类型,代表“8 位整数(integer 8-bit)”,使用 8 比特(1 字节)内存存储一个值,可表示范围为 -128 到 127 的整数。
由于向量中的每个元素仅需 8 比特(1 字节)内存,使用 veci8 可以大幅减少程序的整体内存占用。
以下是创建包含 veci8 列的表并插入数据的示例:
CREATE TABLE items (
  id bigserial PRIMARY KEY,
  embedding veci8(3) NOT NULL
);

INSERT INTO items (embedding) VALUES ('[1, 2, 0]'), ('[-1, 15, -2]');
同样可以在 veci8 类型上创建索引:
CREATE INDEX your_index_name ON items USING vectors (embedding veci8_l2_ops);

SELECT * FROM items ORDER BY embedding <-> '[0.3,0.2,0.1]' LIMIT 1;
我们支持三种用于计算两个 veci8 值之间距离的操作符:
<->(veci8_l2_ops):平方欧氏距离,定义为 Σ(xi−yi)2。<#>(veci8_dot_ops):负点积,定义为 −Σxiyi。<=>(veci8_cos_ops):余弦距离,定义为 1−Σxi2Σyi2Σxiyi。
3 - 稀疏向量:`svector`
与稠密向量不同,稀疏向量具有极高的维度,但仅包含少量非零值。
since v0.3.0
与稠密向量不同,稀疏向量(Sparse Vector)通常具有非常高的维度,但其中只包含极少数的非零值。
通常情况下,稀疏向量可以由以下方式生成:
- 词共现矩阵(Word co-occurrence matrices)
- 词频-逆文档频率(TF-IDF)向量或 SPLADE/BGE-M3 词法权重
- 用户-物品交互矩阵(User-item interaction matrices)
- 网络邻接矩阵(Network adjacency matrices)
在 pgvecto.rs 中,稀疏向量类型称为 svector。
以下是创建包含 svector 列的表并插入数据的示例:
CREATE TABLE items (
  id bigserial PRIMARY KEY,
  embedding svector(10) NOT NULL
);

INSERT INTO items (embedding) VALUES ('[0.1,0,0,0,0,0,0,0,0,0]'), ('[0,0,0,0,0,0,0,0,0,0.5]');
同样可以在 svector 类型上创建索引:
CREATE INDEX your_index_name ON items USING vectors (embedding svector_l2_ops);

SELECT * FROM items ORDER BY embedding <-> '[0.3,0,0,0,0,0,0,0,0,0]' LIMIT 1;
我们支持三种用于计算两个 svector 值之间距离的操作符:
<->(svector_l2_ops):平方欧氏距离,定义为 Σ(xi−yi)2。<#>(svector_dot_ops):负点积,定义为 −Σxiyi。<=>(svector_cos_ops):余弦距离,定义为 1−Σxi2Σyi2Σxiyi。
此外,还提供了 to_svector 函数用于构造 svector,它会在指定的下标位置设置对应的非零值:
F(index)={value[v]0∃v∈N:position[v]=indexelse
-- to_svector(dim: INTEGER, position: ARRAY, value: ARRAY) -> svector
SELECT to_svector(5, '{0, 4}', '{0.3, 0.5}');
-- [0.3, 0, 0, 0, 0.5]
4 - 二值向量:`bvector`
bvector 是 pgvecto.rs 中的二值向量类型,其每个分量仅取 0 或 1 两个可能值,并针对存储和距离计算进行了深度优化。
since v0.3.0
bvector 类型是 pgvecto.rs 中的二值向量(Binary Vector)类型。在二值向量中,每个分量只能取两个可能的值(通常为 0 和 1)。
以下是创建包含 bvector 列的表并插入数据的示例:
CREATE TABLE items (
  id bigserial PRIMARY KEY,
  embedding bvector(3) NOT NULL
);

INSERT INTO items (embedding) VALUES ('[1,0,1]'), ('[0,1,0]');
同样可以在 bvector 类型上创建索引:
CREATE INDEX your_index_name ON items USING vectors (embedding bvector_l2_ops);

SELECT * FROM items ORDER BY embedding <-> '[1,0,1]' LIMIT 5;
我们支持四种用于计算两个 bvector 值之间距离的操作符:
<->(bvector_l2_ops):平方欧氏距离,定义为 Σ(xi−yi)2。对于二值向量,汉明距离(Hamming distance)与平方欧氏距离完全等价。<#>(bvector_dot_ops):负点积,定义为 −Σxiyi。<=>(bvector_cos_ops):余弦距离,定义为 1−Σxi2Σyi2Σxiyi。<~>(bvector_jaccard_ops):杰卡德距离(Jaccard distance),定义为 1−∣X∪Y∣∣X∩Y∣。
此外,还提供了 binarize 函数用于从 vector 构造 bvector,它会将向量元素二值化为 0 或 1:
F(element)={01element≤0element>0
-- binarize(source: vector) -> bvector
SELECT binarize('[-2, -1, 0, 1, 2]'::vector);
-- [0, 0, 0, 1, 1]
bvector 类型针对存储和计算性能进行了深度优化。它采用按位紧缩(bit-packed)的表示方式存储二值向量,并且距离计算也专门针对位运算进行了加速优化。
以下是 bvector 类型的性能基准测试结果。测试使用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,运行在 Google Cloud 的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机上。
我们向表中插入了 100 万条二值向量并运行 KNN 查询。为 100 万条 3072 维二值向量建立索引仅需约 600MB 内存,而使用标准 vector 类型对相同数量的向量建立索引则需要约 18GB 内存。
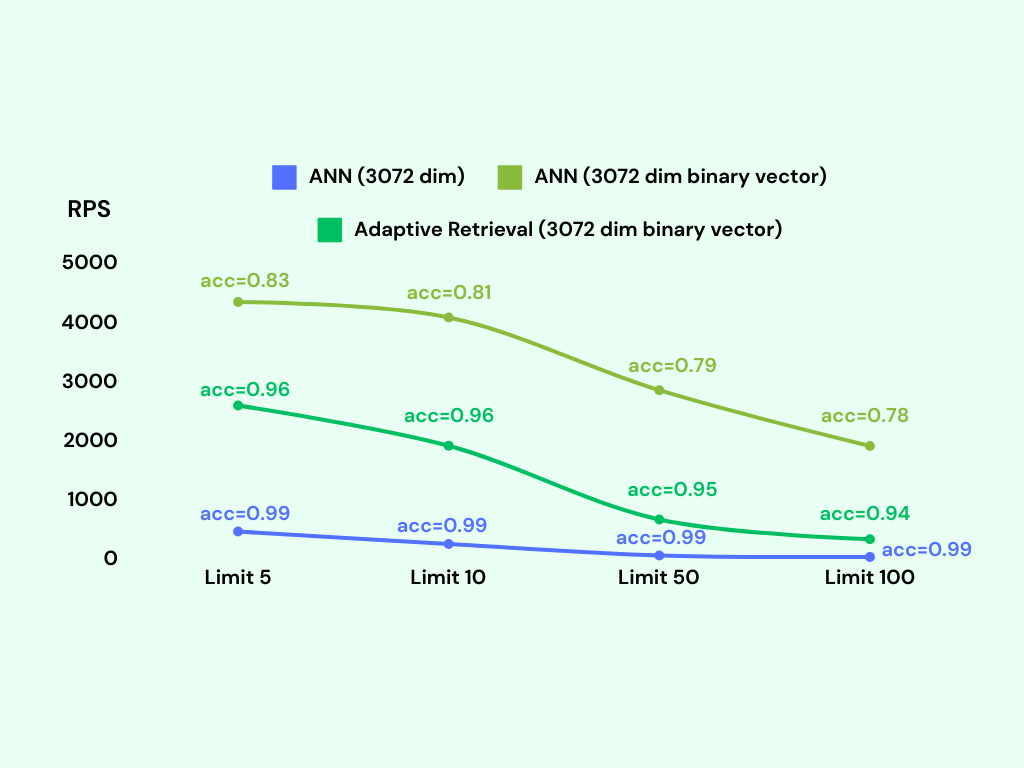
可以看到,单纯使用 bvector 的准确率虽不及 vector 类型,但如果结合采用自适应检索(Adaptive Retrieval),其准确率即可超过 95%。