这是本节的多页打印视图。 .
vchord 文档
-
1: 快速入门
- 1.1: 概览
- 1.2: 安装指南
- 1.3: Vchord 家族套件
- 2: 使用指南
- 3: 应用案例
-
4: 基准测试
- 4.1: 价格基准测试
- 4.2: 性能基准测试
- 4.3: 与 pgvector 的基准测试对比
- 4.4: 与 Elasticsearch 的基准测试对比
- 4.5: 与 pgvectorscale 的基准测试对比
-
5: 运维管理
- 5.1: 迁移指南
- 5.2: 可扩展性
- 5.3: Kubernetes
- 6: 客户案例
欢迎阅读 vchord 文档。请选择下方主题,开始了解安装部署、索引构建(vchordrq 与 vchordg)、多向量检索、混合检索、性能基准测试以及生产环境运维。
1 - 快速入门
1.1 - 概览
vchord 是一款专为可扩展、高性能且磁盘高效的向量相似性检索而设计的 PostgreSQL 扩展。
借助 vchord,您仅需 1 美元即可存储 400,000 个向量,从而显著节省成本:在同等价格下,可存储的向量数量是 Pinecone 优化型存储的 6 倍,是 pgvector/pgvecto.rs 的 26 倍1。欲了解更多详情,请参阅我们的发布博文。
核心特性
相较于 pgvecto.rs 和 pgvector,vchord 带来了显著的增强:
⚡ 性能大幅提升:与 pgvector 的 HNSW 实现相比,经过全面优化的操作可提供最高 5 倍的查询加速、16 倍的写入吞吐量提升,以及 16 倍的索引构建提速1。
💰 高性价比向量检索:仅需 32GB 内存即可查询 1 亿条 768 维向量,在保持 Top-10 召回率达 95% 的同时实现 35ms 的 P50 延迟,助您在保障高质量检索的同时大幅降低基础设施成本。
🔌 无缝集成:完全兼容 pgvector 的数据类型与语法,并提供开箱即用的最优默认配置——无需手动调优参数。只需直接引入 vchord,即可获得性能跃升。
🔧 加速索引构建:支持利用 IVF 在外部(例如 GPU 上)构建索引以加快 KMeans 聚类速度,并结合 RaBitQ2 压缩算法高效存储向量,同时通过自适应重排序(reranking)确保检索质量。
📏 超长向量支持:支持存储和检索最高达 60,0003 维的向量,让您轻松使用 text-embedding-3-large 等顶尖高维模型。
🌐 按需灵活扩展:基于水平扩展架构,针对 500 万或 1 亿条 768 维向量的查询可轻松扩展至 10,000+ QPS(Top-10 召回率达 90%),且具备极具竞争力的成本优势4。
快速开始
对于新用户,我们推荐使用 Docker 镜像快速上手。如果您倾向于不使用 Docker,请参阅安装指南了解其他安装方式。
除了包含 VectorChord 扩展的基础镜像外,我们还提供了全合一镜像
tensorchord/vchord-suite:pg18-latest。该综合镜像包含了所有官方 TensorChord 扩展。开发者应根据支持矩阵选择与所需扩展版本兼容的镜像标签。
随后,您可以使用 psql 命令行工具连接到数据库。默认用户名为 postgres,默认密码为 mysecretpassword。
现在,您可以开始体验 VectorChord 了!
VectorChord 依赖于 pgvector(包括其向量数据表示形式)。由于您可以直接使用它们,您的应用程序可以毫无痛点地轻松完成迁移!
与 pgvector 类似,您可以创建一张包含向量列的表,并向其中插入一些数据。
借助 VectorChord,您可以创建 vchordrq 索引:
然后使用 SELECT ... ORDER BY ... LIMIT ... 执行向量检索:
欲了解更多用法,请阅读:
开源许可
vchord 采用 GNU Affero 通用公共许可证 v3.0(AGPL-3.0-only) 发布。我们欢迎任何商业合作或支持咨询,如有任何问题或需求,请发送邮件至 rh@vonng.com。
-
基于 MyScale Benchmark 测试(768 维向量,95% 召回率)。更多详情请参阅我们的博文。 ↩︎ ↩︎
-
Gao, Jianyang, and Cheng Long. “RaBitQ: Quantizing High-Dimensional Vectors with a Theoretical Error Bound for Approximate Nearest Neighbor Search.” Proceedings of the ACM on Management of Data 2.3 (2024): 1-27. ↩︎
-
目前 pgvector 存在 16,000 维的限制。如果您确实需要处理更高维度的向量(
16,000<dim<60,000),可以考虑修改 VECTOR_MAX_DIM 并自行编译 pgvector。 ↩︎ -
更多详情请参阅我们的博文,其中 PostgreSQL 的水平扩展能力由 CloudNative-PG 提供支持。 ↩︎
1.2 - 安装指南
VectorChord 已在以下操作系统上通过测试:
- Ubuntu (x86_64, aarch64)
- macOS (x86_64, aarch64)
- Windows (x86_64)
- Alpine Linux (x86_64, aarch64) 1
- Debian (powerpc64le, s390x, riscv64) 2
如果您在上述任何操作系统上遇到问题,请提交 Bug 报告;如果您需要更多平台支持,欢迎提交功能请求。
Docker
VectorChord 镜像

体验 VectorChord 最简便的方式是直接运行开箱即用的 Docker 镜像。
- 在 Docker 中启动 VectorChord 容器。
- 使用
psql命令行工具连接到数据库。默认用户名为postgres。
- 执行以下 SQL 语句以确保扩展已启用。
为了充分发挥性能,请通过添加如下参数将数据卷挂载到 PostgreSQL 数据目录:
- 在 PostgreSQL 18 上:
-v $PWD/pgdata:/var/lib/postgresql/18/docker - 在 PostgreSQL 14、15、16 和 17 上:
-v $PWD/pgdata:/var/lib/postgresql/data
您可以参考基础父镜像的说明文档(https://hub.docker.com/_/postgres/)来配置 PostgreSQL。
VectorChord Suite 镜像

除了仅包含 VectorChord 扩展的基础镜像外,我们还提供了全合一镜像 tensorchord/vchord-suite:pg18-latest。该综合镜像包含了所有官方 TensorChord 扩展。开发者应根据支持矩阵选择与所需扩展版本兼容的镜像标签。
- 在 Docker 中启动 VectorChord 容器。
其余步骤与上文一致。
VectorChord Scratch 镜像

我们提供了一个仅包含 VectorChord 相关文件的 scratch 镜像。您可以使用 Docker 的 COPY 指令将 VectorChord 安装到任何镜像中,例如:
该镜像同样可以作为 CloudNativePG 的镜像卷扩展(Image Volume Extension)使用。另请参阅:
源码编译
编译环境要求:
- 任意版本的
make clang >= 16及libclangrust >= 1.93及cargo
在大多数平台上推荐使用 Rustup 安装 Rust,而在 Alpine Linux 上则建议使用系统包管理器安装。
您可以设置环境变量 CC 来为构建系统指定所需的 C 编译器。如果不设置该变量,构建系统会自动搜索 clang 和 gcc。若要使用 clang 编译所有 C 代码,请将 CC 设置为 clang 的路径;若要使用 gcc 编译所有 C 代码,请将 CC 设置为 gcc 的路径(注意:此时要求 gcc >= 14)。
Rust 版本要求并非长期不变的承诺;我们会在每次发布新版本时上调所需的最低 Rust 版本。
上述编译要求仅适用于 x86_64 和 aarch64 架构。对于包括 powerpc64le、s390x 和 riscv64 在内的所有其他架构,均需要使用 nightly 版本的 Rust 以及最新版本的 Clang。
如果您尚未安装 PostgreSQL,请先安装 PostgreSQL。如果您尚未安装 pgvector,可以在执行第 3 步之前安装 pgvector。
- 下载源码,并使用
make进行编译和安装。
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
编译调优
VectorChord 会针对 SIMD 代码执行运行时 CPU 指令集分发(runtime CPU dispatch)。如果您希望编译器针对特定 CPU 对整个程序进行优化,可以指示编译器为该特定 CPU 生成代码。
若要查看当前目标平台(target triple)支持的所有有效 CPU 选项及默认 CPU,请运行:
若要针对当前宿主机生成优化代码,请运行:
请注意,指定特定 target-cpu 生成的二进制文件与其他型号的 CPU 不兼容。
您也可以通过 Cargo 配置文件来完成此设置:
Debian
如果您尚未安装 PostgreSQL,请参照 https://www.postgresql.org/download/linux/debian/ 进行安装。如果您尚未安装 pgvector,可以在执行第 3 步之前通过 apt install postgresql-18-pgvector 进行安装。
VectorChord 的新版本发布托管于 github.com/pgsty/vchord/releases,而历史版本(1.1.1 及更早版本)仍可在 github.com/tensorchord/VectorChord/releases 获取。
- 在发布页面下载 Debian 软件包,并通过
apt进行安装。
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
Ubuntu
如果您尚未安装 PostgreSQL,请参照 https://www.postgresql.org/download/linux/ubuntu/ 进行安装。如果您尚未安装 pgvector,可以在执行第 3 步之前通过 apt install postgresql-18-pgvector 进行安装。
VectorChord 的新版本发布托管于 github.com/pgsty/vchord/releases,而历史版本(1.1.1 及更早版本)仍可在 github.com/tensorchord/VectorChord/releases 获取。
- 在发布页面下载 Debian 软件包,并通过
apt进行安装。
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
PGXN
编译环境要求请参阅源码编译。
如果您尚未安装 PostgreSQL,请先安装 PostgreSQL。如果您尚未安装 pgvector,可以在执行第 3 步之前通过 pgrxclient install vector 进行安装。
- 使用以下命令从 PostgreSQL Extension Network (PGXN) 安装 VectorChord:
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
PGXN 上的 VectorChord 0.4.1 软件包存在问题,请勿使用。请改用 0.4.2 或更高版本。
预编译二进制文件
deprecated预编译二进制文件可能与您机器上安装的 PostgreSQL 存在 ABI 不兼容,这可能会导致静默错误。在此情况下,我们强烈建议您从源码进行编译。
如果您尚未安装 PostgreSQL,请先安装 PostgreSQL。如果您尚未安装 pgvector,可以在执行第 3 步之前安装 pgvector。
- 在发布页面下载预编译二进制文件,并参考您所用发行版的文档重新打包,然后通过系统包管理器进行安装。虽然我们不建议这样做,但如果您需要,也可以直接将文件手动复制到系统目录中:
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
1.3 - Vchord 家族套件
检索增强生成(Retrieval-Augmented Generation,简称 RAG)正在彻底改变我们与海量数据集及大语言模型的交互方式。通过在生成回答前检索相关信息,RAG 系统能够提供更加精准、具备上下文感知且时效性更强的答案。然而,构建稳健、可扩展且高效的 RAG 流水线依然面临诸多挑战,在生产环境中尤为如此。
许多现有方案采用了复杂的架构,分别使用不同的专用数据库来处理向量检索、关键词检索和主数据存储。这往往会导致数据同步困难、基础设施复杂度上升以及运维成本居高不下。
如果能够直接在您信赖的 PostgreSQL 数据库中构建强大且达到生产级标准的 RAG 系统,会怎样呢?
为此,我们推出了 Vchord 家族套件(Vchord Suite)——这是一套专为将高性能向量检索、原生 BM25 排序以及灵活的分词能力直接引入 Postgres 而设计的 PostgreSQL 扩展套件。下面让我们一起探索其核心组件,以及它们如何赋能下一代 RAG 解决方案。
什么是 Vchord 家族套件?
该套件由三个协同工作的核心 PostgreSQL 扩展组成:
-
vchord(pgsty/vchord): 核心向量检索引擎,专为在 PostgreSQL 内部实现可扩展、高性能且高磁盘效率的向量相似性检索而设计。 -
vchord_bm25(pgsty/vchord_bm25): 该扩展利用高效的 Block-WeakAnd 算法,直接在 PostgreSQL 内部实现了成熟的 BM25 排序算法。BM25 是基于关键词词频与文档特征进行相关性排序的行业标准。 -
pg_tokenizer(pgsty/pg_tokenizer): 提供高效全文检索所需的核心文本分词能力,支持对全文检索中的文本处理流程进行细粒度控制。
通过组合这些扩展,您可以完全在 PostgreSQL 内部解锁构建高级 RAG 系统的强大能力。
如何使用 Vchord 家族套件
您可以使用 tensorchord/vchord-suite Docker 镜像来运行由 TensorChord 提供的多个扩展。该镜像基于 Docker 官方 PostgreSQL 镜像构建,并内置了以下扩展:
vchordpg_tokenizervchord_bm25vector
Vchord 家族套件的应用场景
场景 1:基于原生 BM25 与 vchord 的强大混合检索
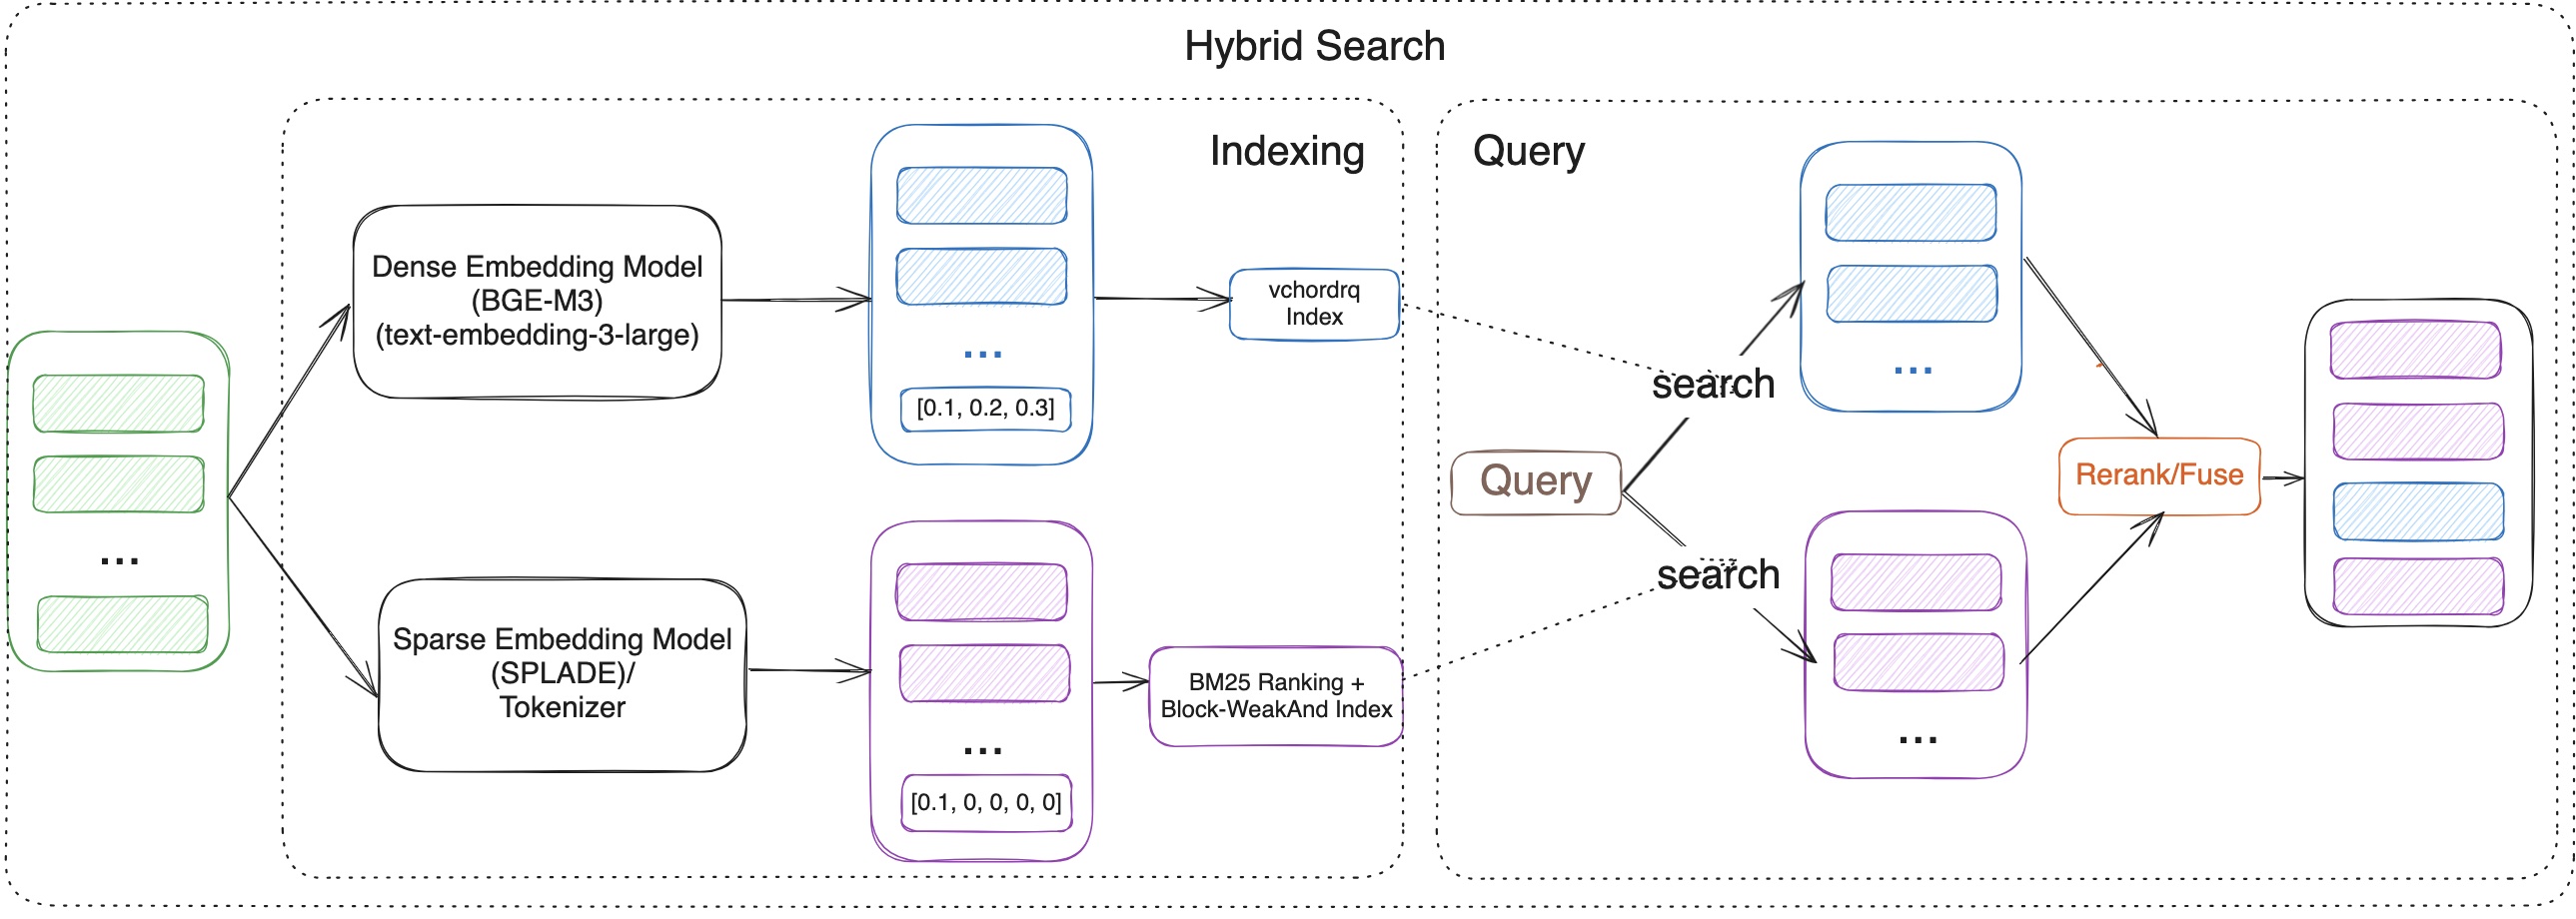
在 RAG 时代,高效的检索至关重要。无论是单纯的关键词检索还是单纯的向量检索,都并非完美无缺:
-
关键词检索(如 BM25): 擅长精确匹配,能够找出包含确切关键词的文档,非常适合结构化查询和特定术语检索。然而,它在处理同义词、改写表述以及理解潜在语义或意图方面表现欠佳。(基于
vchord_bm25与pg_tokenizer实现)。 -
向量检索: 能够捕捉深层语义信息及概念间的关联,即使查询中未出现完全一致的关键词,也能找到相关信息。但在面对要求精确匹配特定术语的查询时,其精度有时会略显不足。(基于
vchord实现)。
解决方案:混合检索(Hybrid Search)。 通过在 PostgreSQL 内部结合这两种方法的优势,Vchord 家族套件完美弥补了这一鸿沟。您可以在查询中同时利用:
-
vchord_bm25(由pg_tokenizer驱动)实现关键词精确匹配。 -
vchord实现深层语义理解。
随后,可以将两者的检索结果进行智能融合(例如使用倒数排序融合 RRF,或基于模型的重排序),从而生成比任何单一方法都更加准确、上下文相关且具备语义感知的最终排序。这将为您的 RAG 应用带来显著的检索性能提升。
场景 2:超越纯文本——基于 ColQwen2 与 vchord 的免 OCR RAG
为 PDF 或扫描图像等文档构建 RAG 系统通常涉及繁琐的预处理流水线。传统方法高度依赖光学字符识别(OCR)和版面分析来提取文本。这一过程往往存在以下弊端:
-
速度缓慢: OCR 的计算开销通常非常高昂。
-
容易出错: OCR 的准确率受文档质量影响极大。
-
信息有损: 表格、图表、排版格式以及相对位置等关键视觉上下文信息,往往会在文本提取过程中丢失。
解决方案:免 OCR、具备视觉感知的 RAG。 如果您无需显式执行 OCR,就能直接根据文档的视觉外观及其内容进行查询,会怎样呢?
现在,通过结合以下两项技术即可实现这一目标:
-
多模态视觉语言模型(VLM): 诸如 ColQwen2 等模型可以直接处理图像(文档页面),并生成同时捕捉文本内容与视觉版面信息的嵌入向量(Embeddings)。
-
vchord的多向量检索能力:vchord可以在 PostgreSQL 中高效地为每篇文档存储和检索多个向量——允许您存储代表文档不同维度的嵌入表示(例如文本内容与视觉布局)。
借助这一方案,您可以直接在 PostgreSQL 中使用提及视觉元素的提示词(如“查找包含对比销售数据的柱状图的文档”)或结合图文线索的查询来检索文档数据库。这不仅简化了您的 RAG 技术栈,还通过保留视觉上下文提升了检索准确率,并彻底消除了传统 OCR 流水线的性能瓶颈。
为什么在 PostgreSQL 中构建 RAG?
在 PostgreSQL 中使用 Vchord 家族套件具有显著优势:
-
数据统一: 将源数据、文本、元数据和向量嵌入统一保存在同一个数据库中。
-
降低复杂度: 无需维护独立的向量数据库及复杂的数据同步流水线。
-
复用现有基础设施: 充分利用您现有的 PostgreSQL 专业经验、工具链和运维体系。
-
事务完整性: 受益于 PostgreSQL 强大的 ACID 事务保障。
-
丰富的生态系统: 无缝接入 PostgreSQL 生态系统中种类繁多的工具与特性。
总结
Vchord 家族套件将 PostgreSQL 打造成了一个强大且达到生产级标准的平台,用于构建高级 RAG 解决方案。通过集成高性能向量检索(vchord)、成熟的关键词排序(vchord_bm25)以及灵活的文本处理(pg_tokenizer),您可以直接在数据库内部实现混合检索与免 OCR 多模态检索等前沿技术。在 PostgreSQL 中借助 Vchord 简化系统架构、提升检索精度,并充分释放 RAG 的全部潜能。
相关博文
在近期的博文中,我们分享了多个实际应用案例,其中所有的 Docker 镜像均可以直接替换为 VectorChord Suite 镜像:
参考资料
2 - 使用指南
2.1 - 索引构建
VectorChord 的索引类型 vchordrq 会将向量划分为多个列表(list),并仅搜索距离查询向量最近的一部分列表。它兼具极快的构建速度与低内存占用,同时在性能上显著优于 hnsw 和 ivfflat。
我们首先创建一个名为 items 的表,其中包含一个类型为 vector(n) 的 embedding 列,然后向其中填充示例数据。
要创建 vchordrq 索引,可以使用以下 SQL 语句:
索引构建完成后,您就可以使用它执行向量搜索,检索距离目标向量最近的 个近邻。
您还可以根据需要为向量搜索查询添加过滤条件。
调优
当表中的行数少于 时,通常不需要设置索引选项。
然而,随着行数的增长,对向量空间进行分区变得十分必要,这可以通过索引选项进行配置。options 使用 TOML(Tom’s Obvious Minimal Language) 格式的字符串指定。更多信息请参阅 #索引选项。
参数 lists 应根据表中的行数进行调优。下表提供了选择合适取值的指导建议。在执行查询时,请相应地选择 vchordrq.probes。
| 行数 | 推荐分区数 | lists 示例 |
|---|---|---|
| N/A | [] |
|
[2000] |
||
[10000] |
||
[80000] |
构建索引的过程包含两个步骤:首先对向量空间进行分区,然后将行插入到索引中。第一步(划分向量空间)可以使用多线程进行加速。
第二步(插入数据行)可以使用多进程并行执行。详情请参阅 PostgreSQL 调优。
对于大多数使用余弦相似度的数据集,启用 residual_quantization 和 build.internal.spherical_centroids 可以同时提升 QPS 和召回率(recall)。
为了提高构建速度,您可以选择将 build.pin 设置为 2,通过使用更多共享内存来加速构建过程。
对于大表而言,时间和内存开销主要由分区阶段主导。有关进一步的调优方法,请参阅分区调优。
您也可以参考外部构建,将分区阶段卸载到其他机器上执行。
参考
操作符类(vchordrq)
vchordrq
下表列出了 vchordrq 支持的所有可用操作符类(Operator Classes)。
| 操作符类 | 说明 | 操作符 1 | 操作符 2 |
|---|---|---|---|
vector_l2_ops |
适用于 vector 类型与欧氏距离 |
<->(vector,vector) |
<<->>(vector,vector) |
vector_ip_ops |
适用于 vector 类型与负内积 |
<#>(vector,vector) |
<<#>>(vector,vector) |
vector_cosine_ops |
适用于 vector 类型与余弦距离 |
<=>(vector,vector) |
<<=>>(vector,vector) |
halfvec_l2_ops |
适用于 halfvec 类型与欧氏距离 |
<->(halfvec,halfvec) |
<<->>(halfvec,halfvec) |
halfvec_ip_ops |
适用于 halfvec 类型与负内积 |
<#>(halfvec,halfvec) |
<<#>>(halfvec,halfvec) |
halfvec_cosine_ops |
适用于 halfvec 类型与余弦距离 |
<=>(halfvec,halfvec) |
<<=>>(halfvec,halfvec) |
rabitq8_l2_ops |
适用于 rabitq8 类型与欧氏距离 |
<->(rabitq8,rabitq8) |
<<->>(rabitq8,rabitq8) |
rabitq8_ip_ops |
适用于 rabitq8 类型与负内积 |
<#>(rabitq8,rabitq8) |
<<#>>(rabitq8,rabitq8) |
rabitq8_cosine_ops |
适用于 rabitq8 类型与余弦距离 |
<=>(rabitq8,rabitq8) |
<<=>>(rabitq8,rabitq8) |
rabitq4_l2_ops |
适用于 rabitq4 类型与欧氏距离 |
<->(rabitq4,rabitq4) |
<<->>(rabitq4,rabitq4) |
rabitq4_ip_ops |
适用于 rabitq4 类型与负内积 |
<#>(rabitq4,rabitq4) |
<<#>>(rabitq4,rabitq4) |
rabitq4_cosine_ops |
适用于 rabitq4 类型与余弦距离 |
<=>(rabitq4,rabitq4) |
<<=>>(rabitq4,rabitq4) |
vector_maxsim_ops |
适用于 vector[] 类型与可扩展的多向量相似度 |
@#(vector[],vector[]) |
N/A |
halfvec_maxsim_ops |
适用于 halfvec[] 类型与可扩展的多向量相似度 |
@#(halfvec[],halfvec[]) |
N/A |
rabitq8_maxsim_ops |
适用于 rabitq8[] 类型与可扩展的多向量相似度 |
@#(rabitq8[],rabitq8[]) |
N/A |
rabitq4_maxsim_ops |
适用于 rabitq4[] 类型与可扩展的多向量相似度 |
@#(rabitq4[],rabitq4[]) |
N/A |
<->、<#> 和 <=> 是由 pgvector 定义的操作符。
| 名称 | 说明 |
|---|---|
<-> |
欧氏距离的平方 |
<#> |
负点积 |
<=> |
余弦距离 |
<<->>、<<#>>、<<=>> 是由 VectorChord 定义的操作符。有关 <<->>、<<#>>、<<=>> 的更多信息,请参阅相似度过滤。
@# 是由 VectorChord 定义的操作符。有关 @# 的更多信息,请参阅多向量检索。
rabitq8、rabitq4 是由 VectorChord 定义的数据类型。有关 rabitq8、rabitq4 的更多信息,请参阅量化类型。
MaxSim 相关的操作符类自 0.3.0 版本起可用。rabitq8 和 rabitq4 相关的操作符类自 1.1.0 版本起可用。
索引选项(vchordrq)
vchordrq
residual_quantization
- 说明:该选项决定是否使用残差量化(Residual Quantization)。如果您不熟悉残差量化,可以阅读这篇博客了解更多信息。简而言之,残差量化是一种通过对向量的残差进行量化来提高向量搜索精度的技术。
- 类型:布尔值(boolean)
- 默认值:
false - 示例:
residual_quantization = false表示不使用残差量化。residual_quantization = true表示使用残差量化。
- 注意:该选项不支持
rabitq8和rabitq4。
degree_of_parallelism
since v1.0.0
- 说明:该选项是一个指定并行度的提示值。在大多数情况下,您无需更改它。如果您使用的 CPU 拥有超过
32个线程,并且希望在 PostgreSQL 中利用更多线程,可以将其设置为线程数量以获得更好的性能。 - 类型:整数(integer)
- 默认值:
32 - 取值范围:
[1, 256] - 示例:
degree_of_parallelism = 32提示索引最多可能有32个进程并发访问该索引。degree_of_parallelism = 64提示索引最多可能有64个进程并发访问该索引。
build.pin
since v0.2.1
- 说明:该选项决定构建索引时是否使用共享内存。对于大表,您可以选择启用此选项以加速构建过程。
- 类型:整数与布尔值的联合类型(union of integer and boolean)
- 默认值:
-1since v1.0.0falseuntil v0.5.3
- 取值范围:
{-1, 0, 1, 2, false, true}since v1.0.0{false, true}until v0.5.3
- 示例:
build.pin = 2表示将索引的热数据部分全部缓存在内存中。build.pin = 1表示将索引热数据部分的一个子集缓存在内存中,消耗较少内存。build.pin = 0表示启用该功能但实际上不缓存任何内容。此选项仅用于调试目的。build.pin = -1表示禁用该功能。build.pin = false是build.pin = -1的旧版写法。build.pin = true是build.pin = 1的旧版写法。
默认构建选项
since v0.5.3这是索引构建的默认设置。索引将不会进行分区。从语义上讲,build.default = {} 类似于 build.internal.lists = []。
内部构建选项(vchordrq)
vchordrq
build.internal.lists
- 说明:该选项决定向量空间分区的层次结构。
- 类型:整数列表(list of integers)
- 默认值:
[]since v0.3.0[1000]until v0.2.2: implicit behavior is not ideal
- 示例:
build.internal.lists = []表示不对向量空间进行分区。build.internal.lists = [4096]表示将向量空间划分为 个单元(cell)。build.internal.lists = [4096, 262144]表示将向量空间划分为 个单元,并进一步将这些单元细分为 个更小的单元。
- 注意:索引会基于质心(centroid)将向量空间划分为多个 Voronoi 单元,通过迭代构建出一棵层次化的空间分区树。树中的每个叶子节点代表一个区域,并关联一个存储该区域内向量的列表。在插入时,向量会被放入其对应叶子节点的列表中。在查询时,索引通过排除叶子节点距离查询向量较远的列表来优化搜索,从而有效剪枝搜索空间。如果
lists的长度为 ,则lists选项的值不应小于 ,其中 是表中的向量数量。
build.internal.spherical_centroids
- 说明:该选项决定是否执行球面 K-means(spherical K-means)——即在每次迭代后对质心进行 L2 归一化,您可以参考此处的
spherical选项。 - 类型:布尔值(boolean)
- 默认值:
false - 示例:
build.internal.spherical_centroids = false表示不执行球面 K-means。build.internal.spherical_centroids = true表示执行球面 K-means。
- 注意:如果您的模型生成的嵌入向量使用余弦相似度作为度量标准,请将此项设置为
true。
build.internal.sampling_factor
since v0.2.0
- 说明:该选项决定 K-means 算法为每个聚类采样的向量数量。该值越高,构建速度越慢,构建时的内存消耗越大,但搜索性能越好。
- 类型:整数(integer)
- 取值范围:
[0, 1024] - 默认值:
256 - 示例:
build.internal.sampling_factor = 256表示 K-means 算法采样 个向量,其中 是build.internal.lists中的最大值。build.internal.sampling_factor = 32表示 K-means 算法采样 个向量,其中 是build.internal.lists中的最大值。这会将 K-means 的时间和内存开销降低至默认值256时的约 。
build.internal.kmeans_iterations
since v0.2.2
- 说明:该选项决定 K-means 算法的迭代次数。该值越高,构建速度越慢。
- 类型:整数(integer)
- 取值范围:
[0, 1024] - 默认值:
10 - 示例:
build.internal.kmeans_iterations = 10表示 K-means 算法执行 次迭代。build.internal.kmeans_iterations = 100表示 K-means 算法执行 次迭代。
build.internal.build_threads
- 说明:该选项决定 K-means 算法使用的线程数。该值越高,构建速度越快,同时构建期间服务器的负载也越高。
- 类型:整数(integer)
- 取值范围:
[1, 255] - 默认值:
1 - 示例:
build.internal.build_threads = 1表示 K-means 算法使用 个线程。build.internal.build_threads = 4表示 K-means 算法使用 个线程。
build.internal.kmeans_algorithm
since v1.0.0
- 说明:该选项决定所使用的 K-means 算法。
- 类型:对象(object)
- 示例:
build.internal.kmeans_algorithm.lloyd = {}:使用劳埃德算法(Lloyd’s algorithm)。这是默认值。build.internal.kmeans_algorithm.hierarchical = {}:使用层次聚类(hierarchical clustering)。与劳埃德算法相比,这种方法速度要快得多,但可能会导致一定的精度损失。
build.internal.kmeans_dimension
since v1.0.0
- 说明:该选项决定用于 K-means 输入和输出的维度。该特性通过重采样实现降维与升维,从而有效降低 K-means 的时间和内存消耗,但可能会导致一定的精度损失。
- 类型:整数与空值的联合类型(union of integer and null)
- 默认值:null
- 示例:
- 如果未设置此选项,则禁用该特性。
build.internal.kmeans_dimension = 100表示 K-means 将处理 维的向量。对于原始维度为 的向量,这会将 K-means 的时间和内存开销降低至未启用该特性时的约 。
搜索参数(vchordrq)
vchordrq
vchordrq.enable_scan
since v0.5.0
- 说明:启用或禁用查询规划器对
vchordrq索引扫描的使用。该参数仅用于测试目的。 - 类型:布尔值(boolean)
- 默认值:
on - 示例:
vchordrq.enable_scan = off禁用查询规划器使用vchordrq索引扫描。vchordrq.enable_scan = on启用查询规划器使用vchordrq索引扫描。
vchordrq.probes
- 说明:GUC 参数
vchordrq.probes控制如何利用向量空间分区来辅助查询剪枝。探测数(probes)越多,搜索结果越精确,但速度也越慢。 - 类型:整数列表(list of integers)
- 默认值:
10until v0.2.2: the default value was 10 before `lists` defaulted to empty- 该参数支持回退参数(fallback)。
- 示例:
SET vchordrq.probes = 1表示仅使用 1 个探测分区。SET vchordrq.probes = 10表示使用 10 个探测分区。
- 注意:默认值为空列表。该选项的长度必须与
lists的长度相匹配。- 如果
lists = [],则 probes 必须为 - 如果
lists = [11, 22],则 probes 可以是2,4或4,8。其形状不能不匹配,例如不能是3、7,8,9或5,5,5,5。
- 如果
vchordrq.epsilon
- 说明:即使经过剪枝,检索出的候选向量数量依然可观。索引采用 RaBitQ 算法将向量量化为位向量(bit vector),其内存占用仅为单精度浮点向量的 。由于大部分计算基于整数完成,处理速度得以大幅提升。与传统量化算法不同,RaBitQ 不仅估算距离,还会估算距离的下界(lower bound)。索引会计算每个向量的距离下界,并根据查询需求动态调整需要重新计算精确距离的向量数量,从而在性能与精度之间取得平衡。GUC 参数
vchordrq.epsilon控制距离下界估算的保守程度。该值越高,精度越高,但性能越差。对于大多数应用场景而言,默认值倾向于提供高于实际所需的精度,因此您可以尝试调低此参数以获得更好的性能。 - 类型:实数(real)
- 默认值:
1.9- 该参数支持回退参数(fallback)。
- 取值范围:
[0.0, 4.0] - 示例:
SET vchordrq.epsilon = 0.1表示您正在使用非常乐观的下界估算。这样设置是因为在您所需的精度下,您的数据集对下界估算不敏感。SET vchordrq.epsilon = 4.0表示您正在使用非常悲观的下界估算。这样设置是因为在您所需的精度下,您的数据集对下界估算较为敏感。
vchordrq.prewarm_dim
removed in v0.4.0
- 说明:GUC 参数
vchordrq.prewarm_dim用于为指定维度预计算 RaBitQ 投影矩阵。这有助于降低 PostgreSQL 集群启动后首次查询的延迟。 - 类型:整数列表(list of integers)
- 默认值:
64,128,256,384,512,768,1024,1536 - 示例:
ALTER SYSTEM SET vchordrq.prewarm_dim = '64,128'表示将为维度 64 和 128 预计算投影矩阵。
- 注意:
- 此设置需要重启数据库才能生效。
- 自
v0.4.0起,新算法已使该选项不再需要。
vchordrq.max_scan_tuples
since v0.2.0
- 说明:GUC 参数
vchordrq.max_scan_tuples控制在一次向量搜索中最多可以扫描的元组(tuple)数量。在大多数情况下,您不需要设置此参数,因为LIMIT子句起到了类似的作用。然而,当存在WHERE子句时,LIMIT子句在过滤之后生效,而此 GUC 参数在过滤之前生效。该参数旨在防止过滤选择率极低时出现性能下降。 - 类型:整数(integer)
- 默认值:
-1 - 取值范围:
[-1, 2147483647] - 示例:
SET vchordrq.max_scan_tuples = 999表示索引扫描最多返回 个元组。SET vchordrq.max_scan_tuples = -1表示对元组数量没有限制。
- 注意:当设置为
-1时,此参数不起作用。
2.2 - 多向量检索
多向量检索(Multi-Vector Retrieval)是检索增强生成(RAG)系统中使用的一项高级技术,通过为每个文档关联多个向量来增强文档检索效果。
与单向量检索不同,使用 MaxSim 操作符的多向量检索能够捕捉细粒度的语义关系。
关于如何构建端到端的多向量检索应用,请参阅我们的博客了解更多细节。
快速上手
晚期交互(Late interaction)模型会将文档和查询分别嵌入为向量数组,并通过名为 MaxSim 的操作符计算相似度。MaxSim 操作符的定义为 ,即对于查询向量数组中的每个向量,在文档向量数组中找到最接近的向量,计算它们的点积,最后将所有结果求和。
在 VectorChord 中,该操作符的符号为 @#。左操作数是文档向量数组,右操作数是查询向量数组。原始的 MaxSim 操作符基于相似度,而 VectorChord 中的操作符则基于距离:VectorChord 的实现通过对相似度得分取反,将其解释为一种距离度量。
要为向量数组构建索引,首先创建一个名为 items 的表,其中包含一个类型为 vector(n)[] 的 embeddings 列,然后向表中填充生成的数据。
与其他向量操作符一样,使用 MaxSim 操作符的查询也可以通过索引进行加速。
随后,您便可以使用该索引执行向量搜索。
参考
vchordg 不支持此功能。
操作符类
请参阅:
搜索参数(vchordrq)
vchordrq
MaxSim 操作符的索引机制与其他向量操作符类似。当在向量数组列上构建索引时,数组中的每个向量都会被单独插入到索引数据结构中。在查询期间,索引会对查询数组中的每个向量分别执行一次独立的向量搜索。默认情况下,索引不会对结果进行重排序(rerank),而是使用 RaBitQ 的估算距离代替实际距离。随后,索引会将所有独立向量搜索的结果进行合并,以生成最终输出。
MaxSim 索引还使用了以下几个额外参数:
vchordrq.maxsim_refine
since v0.3.0
- 说明:GUC 参数
vchordrq.maxsim_refine会让索引对结果进行重排序,用实际距离替换 RaBitQ 的估算距离,直到前 k 个(top-k)最近向量的距离全部重新计算完毕。 - 类型:整数(integer)
- 取值范围:
[0, 2147483647] - 默认值:
0- 该参数支持回退参数(fallback)。
- 示例:
SET vchordrq.maxsim_refine = 0表示索引始终使用 RaBitQ 的估算距离。SET vchordrq.maxsim_refine = 1024表示索引会对结果进行重排序,用实际距离替换 RaBitQ 的估算距离,直到前 1024 个最近向量的距离全部重新计算完毕。
vchordrq.maxsim_threshold
since v0.3.0
- 说明:GUC 参数
vchordrq.maxsim_threshold启用对缺失值更激进的估算策略。启用该设置后,索引会在最底层列表中找到累积大小达到或超过vchordrq.maxsim_threshold的第一个聚类(cluster),并使用其与查询向量的距离来估算缺失值。 - 类型:整数(integer)
- 取值范围:
[0, 2147483647] - 默认值:
0- 该参数支持回退参数(fallback)。
- 示例:
SET vchordrq.maxsim_threshold = 0表示不启用更激进的估算策略。SET vchordrq.maxsim_threshold = 1024表示索引会在最底层列表中找到累积大小达到或超过1024的第一个聚类,并使用其与查询向量的距离来估算缺失值。
2.3 - 图索引
VectorChord 的索引类型 vchordg 是一种基于磁盘的图索引,具有低内存占用的特点。
我们首先创建一个名为 items 的表,其中包含一个类型为 vector(n) 的 embedding 列,然后向其中填充示例数据。
要创建 vchordg 索引,可以使用以下 SQL 语句:
该功能目前处于预览阶段。
调优
在构建索引时,通常需要对两个选项进行调优:m 和 ef_construction。m 是每个顶点的最大邻居数,ef_construction 是插入期间包含最近邻的动态列表大小。
在搜索时,需要对 ef_search 进行调优。ef_search 是搜索期间包含最近邻的动态列表大小。
作为一种基于磁盘的索引,vchordg 通常只需要将量化后的向量保存在缓冲池(buffer pool)中即可维持良好性能。默认情况下,vchordg 会将一个 维向量量化为 比特。设行数为 ,则该索引所需的总内存为 比特。如果您的内存非常有限且正在使用超高维向量,可以考虑将向量量化为 比特,此时索引所需的总内存为 比特。
索引构建可以通过使用多进程来加速。详情请参阅 PostgreSQL 调优。
参考
操作符类(vchordg)
vchordg
下表列出了 vchordg 支持的所有可用操作符类。
| 操作符类 | 说明 | 操作符 1 | 操作符 2 |
|---|---|---|---|
vector_l2_ops |
适用于 vector 类型与欧氏距离 |
<->(vector,vector) |
<<->>(vector,vector) |
vector_ip_ops |
适用于 vector 类型与负内积 |
<#>(vector,vector) |
<<#>>(vector,vector) |
vector_cosine_ops |
适用于 vector 类型与余弦距离 |
<=>(vector,vector) |
<<=>>(vector,vector) |
halfvec_l2_ops |
适用于 halfvec 类型与欧氏距离 |
<->(halfvec,halfvec) |
<<->>(halfvec,halfvec) |
halfvec_ip_ops |
适用于 halfvec 类型与负内积 |
<#>(halfvec,halfvec) |
<<#>>(halfvec,halfvec) |
halfvec_cosine_ops |
适用于 halfvec 类型与余弦距离 |
<=>(halfvec,halfvec) |
<<=>>(halfvec,halfvec) |
rabitq8_l2_ops |
适用于 rabitq8 类型与欧氏距离 |
<->(rabitq8,rabitq8) |
<<->>(rabitq8,rabitq8) |
rabitq8_ip_ops |
适用于 rabitq8 类型与负内积 |
<#>(rabitq8,rabitq8) |
<<#>>(rabitq8,rabitq8) |
rabitq8_cosine_ops |
适用于 rabitq8 类型与余弦距离 |
<=>(rabitq8,rabitq8) |
<<=>>(rabitq8,rabitq8) |
rabitq4_l2_ops |
适用于 rabitq4 类型与欧氏距离 |
<->(rabitq4,rabitq4) |
<<->>(rabitq4,rabitq4) |
rabitq4_ip_ops |
适用于 rabitq4 类型与负内积 |
<#>(rabitq4,rabitq4) |
<<#>>(rabitq4,rabitq4) |
rabitq4_cosine_ops |
适用于 rabitq4 类型与余弦距离 |
<=>(rabitq4,rabitq4) |
<<=>>(rabitq4,rabitq4) |
<<->>、<<#>>、<<=>> 是由 VectorChord 定义的操作符。有关 <<->>、<<#>>、<<=>> 的更多信息,请参阅相似度过滤。
rabitq8、rabitq4 是由 VectorChord 定义的数据类型。有关 rabitq8、rabitq4 的更多信息,请参阅量化类型。
前 6 个操作符类自 0.5.0 版本起可用,后 6 个操作符类自 1.1.0 版本起可用。
索引选项(vchordg)
vchordg
bits
since v0.5.0
- 说明:RaBitQ 量化后比特数与维度的比值。
bits = 2可提供更好的召回率和 QPS,而bits = 1则消耗更少的内存。 - 类型:整数(integer)
- 默认值:
2 - 示例:
bits = 2表示将 维向量量化为 比特。bits = 1表示将 维向量量化为 比特。
m
since v0.5.0
- 说明:每个顶点的最大邻居数。
m越大,性能越好,但存储需求也越高。m对应于 HNSW 中的 和 DiskANN 中的 。 - 类型:整数(integer)
- 默认值:
32 - 示例:
m = 32表示每个顶点最多有 个邻居。m = 64表示每个顶点最多有 个邻居。
ef_construction
since v0.5.0
- 说明:插入期间包含最近邻的动态列表大小。
ef_construction越大,搜索性能越好,但插入速度越慢。ef_construction对应于 HNSW 中的 和 DiskANN 中的 。 - 类型:整数(integer)
- 默认值:
64 - 示例:
ef_construction = 64表示在插入期间包含最近邻的动态列表大小为 。ef_construction = 128表示在插入期间包含最近邻的动态列表大小为 。
alpha
since v0.5.0
- 说明:剪枝期间所选用的
alpha值。alpha对应于 DiskANN 中的 。该选项必须是一个升序列表,其中第一个元素为1.0,最后一个元素小于2.0。 - 类型:浮点数列表(list of floats)
- 默认值:
[1.0, 1.2] - 示例:
alpha = [1.0, 1.2]等价于在 DiskANN 中设置alpha = 1.2。alpha = [1.0]等价于 HNSW 中的默认剪枝策略。
- 注意:当距离度量为负内积时,此选项无效。
beam_construction
since v0.5.0
- 说明:插入期间使用的束宽(beam width)。束宽是指一次同时访问的顶点数量。由于从 SSD 随机读取少量扇区的时间与读取单个扇区几乎相同,较大的束宽可以有效减少对 SSD 的往返访问次数,从而获得更好的性能。但由于它会增加计算量,因此对于完全放入内存的索引而言反而不利。
- 类型:整数(integer)
- 默认值:
1 - 示例:
beam_construction = 8表示索引在插入期间一次同时访问 8 个顶点。beam_construction = 1表示索引在插入期间一次访问 1 个顶点。
搜索参数(vchordg)
vchordg
vchordg.enable_scan
since v0.5.0
- 说明:启用或禁用查询规划器对
vchordg索引扫描的使用。该参数仅用于测试目的。 - 类型:布尔值(boolean)
- 默认值:
on - 示例:
vchordg.enable_scan = off禁用查询规划器使用vchordg索引扫描。vchordg.enable_scan = on启用查询规划器使用vchordg索引扫描。
vchordg.ef_search
since v0.5.0
- 说明:搜索期间包含最近邻的动态列表大小。
vchordg.ef_search越大,召回率越好,但 QPS 越低。vchordg.ef_search对应于 HNSW 和 DiskANN 中的 。 - 类型:整数(integer)
- 默认值:
64- 该参数支持回退参数(fallback)。
- 取值范围:
[1, 65535] - 示例:
SET vchordg.ef_search = 64表示在搜索期间包含最近邻的动态列表大小为 。SET vchordg.ef_search = 128表示在搜索期间包含最近邻的动态列表大小为 。
vchordg.beam_search
since v0.5.0
- 说明:搜索期间使用的束宽(beam width)。束宽是指一次同时访问的顶点数量。由于从 SSD 随机读取少量扇区的时间与读取单个扇区几乎相同,较大的束宽可以有效减少对 SSD 的往返访问次数,从而获得更好的性能。但由于它会增加计算量,因此对于完全放入内存的索引而言反而不利。
- 类型:整数(integer)
- 默认值:
1 - 取值范围:
[1, 65535] - 示例:
SET vchordg.beam_search = 8表示索引在搜索期间一次同时访问 8 个顶点。SET vchordg.beam_search = 1表示索引在搜索期间一次访问 1 个顶点。
vchordg.max_scan_tuples
since v0.5.0
- 说明:GUC 参数
vchordg.max_scan_tuples控制在一次向量搜索中最多可以扫描的元组数量。在大多数情况下,您不需要设置此参数,因为LIMIT子句起到了类似的作用。然而,当存在WHERE子句时,LIMIT子句在过滤之后生效,而此 GUC 参数在过滤之前生效。该参数旨在防止过滤选择率极低时出现性能下降。 - 类型:整数(integer)
- 默认值:
-1 - 取值范围:
[-1, 2147483647] - 示例:
SET vchordg.max_scan_tuples = 999表示索引扫描最多返回 个元组。SET vchordg.max_scan_tuples = -1表示对元组数量没有限制。
- 注意:当设置为
-1时,此参数不起作用。
2.4 - 量化类型
量化不仅可以应用于索引,还可以直接应用于向量本身。为此,VectorChord 提供了专门用于量化向量的数据类型。
rabitq8 是量化向量的数据类型。在相同维度下,它的存储开销约为全精度向量(vector)的 ,半精度向量(halfvec)的 。该类型以其所使用的量化算法命名。1
与普通向量类型一样,也可以在 rabitq8 类型的列上创建索引。
通过使用 rabitq8,表大小和索引大小都将缩小为使用 vector 类型时的 。其代价是量化会明显折损性能与精度。因此,它适用于检索大量候选结果的场景。
此外,VectorChord 还提供了 rabitq4 类型。rabitq8 量化向量在每个维度上使用 比特,而 rabitq4 量化向量在每个维度上仅使用 比特。它专为在受限环境下优先追求低存储开销而非高精度的场景而设计。
参考
操作符类
请参阅:
数据类型
rabitq8
since v1.1.0
- 说明:使用
uint8进行内部存储的量化向量数据类型。基于扩展版 RaBitQ 算法。1 - 文本表示:与
vector/halfvec不同,rabitq8的文本表示更为复杂。假设维度为 ,它由括在圆括号中的 个浮点数数组与括在方括号中的 个uint8整数数组拼接而成。例如(2.999999, 160.63234, 647, 2.8498733)[255, 205, 187]。其内部解释无需手动处理,但您可以通过dequantize_to_vector(rabitq8)/dequantize_to_halfvec(rabitq8)获取它所代表的近似向量。
rabitq4
since v1.1.0
- 说明:使用
uint4进行内部存储的量化向量数据类型。基于扩展版 RaBitQ 算法。1 - 文本表示:与
vector/halfvec不同,rabitq4的文本表示更为复杂。假设维度为 ,它由括在圆括号中的 个浮点数数组与括在方括号中的 个uint4整数数组拼接而成。例如(2.999999, 9.420722, 38, 2.8498733)[15, 12, 11]。其内部解释无需手动处理,但您可以通过dequantize_to_vector(rabitq4)/dequantize_to_halfvec(rabitq4)获取它所代表的近似向量。
函数
quantize_to_rabitq8(vector)
since v1.1.0
- 说明:将向量量化为
rabitq8。请注意,在不同的 VectorChord 版本或不同的机器上,该函数对相同输入可能会产生略有差异的结果。 - 返回值:
rabitq8,量化后的向量 - 参数:
vector,待量化的向量
- 示例:
SELECT quantize_to_rabitq8('[1,1,1]'::vector)
- 注意:该函数没有对应的默认类型转换(
CAST)。如有需要,您可以使用CREATE CAST (vector AS rabitq8) WITH FUNCTION quantize_to_rabitq8(vector) AS ASSIGNMENT手动创建。
quantize_to_rabitq8(halfvec)
since v1.1.0
- 说明:将半精度向量量化为
rabitq8。请注意,在不同的 VectorChord 版本或不同的机器上,该函数对相同输入可能会产生略有差异的结果。 - 返回值:
rabitq8,量化后的向量 - 参数:
halfvec,待量化的向量
- 示例:
SELECT quantize_to_rabitq8('[1,1,1]'::halfvec)
- 注意:该函数没有对应的默认类型转换(
CAST)。如有需要,您可以使用CREATE CAST (halfvec AS rabitq8) WITH FUNCTION quantize_to_rabitq8(halfvec) AS ASSIGNMENT手动创建。
dequantize_to_vector(rabitq8)
since v1.1.1
- 说明:将量化向量反量化为
vector。请注意,在不同的 VectorChord 版本或不同的机器上,该函数对相同输入可能会产生略有差异的结果。使用此函数无法精确重建原始向量。 - 返回值:
vector,反量化后的向量 - 参数:
rabitq8,待反量化的量化向量
- 示例:
SELECT dequantize_to_vector(quantize_to_rabitq8('[1,1,1]'::vector))
- 注意:该函数没有对应的默认类型转换(
CAST)。如有需要,您可以使用CREATE CAST (rabitq8 AS vector) WITH FUNCTION dequantize_to_vector(rabitq8) AS ASSIGNMENT手动创建。
dequantize_to_halfvec(rabitq8)
since v1.1.1
- 说明:将量化向量反量化为
halfvec。请注意,在不同的 VectorChord 版本或不同的机器上,该函数对相同输入可能会产生略有差异的结果。使用此函数无法精确重建原始向量。 - 返回值:
halfvec,反量化后的向量 - 参数:
rabitq8,待反量化的量化向量
- 示例:
SELECT dequantize_to_halfvec(quantize_to_rabitq8('[1,1,1]'::halfvec))
- 注意:该函数没有对应的默认类型转换(
CAST)。如有需要,您可以使用CREATE CAST (rabitq8 AS halfvec) WITH FUNCTION dequantize_to_halfvec(rabitq8) AS ASSIGNMENT手动创建。
quantize_to_rabitq4(vector)
since v1.1.0
- 说明:将向量量化为
rabitq4。请注意,在不同的 VectorChord 版本或不同的机器上,该函数对相同输入可能会产生略有差异的结果。 - 返回值:
rabitq4,量化后的向量 - 参数:
vector,待量化的向量
- 示例:
SELECT quantize_to_rabitq4('[1,1,1]'::vector)
- 注意:该函数没有对应的默认类型转换(
CAST)。如有需要,您可以使用CREATE CAST (vector AS rabitq4) WITH FUNCTION quantize_to_rabitq4(vector) AS ASSIGNMENT手动创建。
quantize_to_rabitq4(halfvec)
since v1.1.0
- 说明:将半精度向量量化为
rabitq4。请注意,在不同的 VectorChord 版本或不同的机器上,该函数对相同输入可能会产生略有差异的结果。 - 返回值:
rabitq4,量化后的向量 - 参数:
halfvec,待量化的向量
- 示例:
SELECT quantize_to_rabitq4('[1,1,1]'::halfvec)
- 注意:该函数没有对应的默认类型转换(
CAST)。如有需要,您可以使用CREATE CAST (halfvec AS rabitq4) WITH FUNCTION quantize_to_rabitq4(halfvec) AS ASSIGNMENT手动创建。
dequantize_to_vector(rabitq4)
since v1.1.1
- 说明:将量化向量反量化为
vector。请注意,在不同的 VectorChord 版本或不同的机器上,该函数对相同输入可能会产生略有差异的结果。使用此函数无法精确重建原始向量。 - 返回值:
vector,反量化后的向量 - 参数:
rabitq4,待反量化的量化向量
- 示例:
SELECT dequantize_to_vector(quantize_to_rabitq4('[1,1,1]'::vector))
- 注意:该函数没有对应的默认类型转换(
CAST)。如有需要,您可以使用CREATE CAST (rabitq4 AS vector) WITH FUNCTION dequantize_to_vector(rabitq4) AS ASSIGNMENT手动创建。
dequantize_to_halfvec(rabitq4)
since v1.1.1
- 说明:将量化向量反量化为
halfvec。请注意,在不同的 VectorChord 版本或不同的机器上,该函数对相同输入可能会产生略有差异的结果。使用此函数无法精确重建原始向量。 - 返回值:
halfvec,反量化后的向量 - 参数:
rabitq4,待反量化的量化向量
- 示例:
SELECT dequantize_to_halfvec(quantize_to_rabitq4('[1,1,1]'::halfvec))
- 注意:该函数没有对应的默认类型转换(
CAST)。如有需要,您可以使用CREATE CAST (rabitq4 AS halfvec) WITH FUNCTION dequantize_to_halfvec(rabitq4) AS ASSIGNMENT手动创建。
操作符
<->(rabitq8, rabitq8)
since v1.1.0
- 说明:计算两个量化向量之间的 L2 距离。
- 返回值:
real,两个量化向量的 L2 距离 - 参数:
rabitq8rabitq8
<#>(rabitq8, rabitq8)
since v1.1.0
- 说明:计算两个量化向量之间的负点积距离。
- 返回值:
real,两个量化向量的负点积距离 - 参数:
rabitq8rabitq8
<=>(rabitq8, rabitq8)
since v1.1.0
- 说明:计算两个量化向量之间的余弦距离。
- 返回值:
real,两个量化向量的余弦距离 - 参数:
rabitq8rabitq8
<->(rabitq4, rabitq4)
since v1.1.0
- 说明:计算两个量化向量之间的 L2 距离。
- 返回值:
real,两个量化向量的 L2 距离 - 参数:
rabitq4rabitq4
<#>(rabitq4, rabitq4)
since v1.1.0
- 说明:计算两个量化向量之间的负点积距离。
- 返回值:
real,两个量化向量的负点积距离 - 参数:
rabitq4rabitq4
<=>(rabitq4, rabitq4)
since v1.1.0
- 说明:计算两个量化向量之间的余弦距离。
- 返回值:
real,两个量化向量的余弦距离 - 参数:
rabitq4rabitq4
-
Jianyang Gao, Yutong Gou, Yuexuan Xu, Yongyi Yang, Cheng Long, Raymond Chi-Wing Wong, “Practical and Asymptotically Optimal Quantization of High-Dimensional Vectors in Euclidean Space for Approximate Nearest Neighbor Search”, SIGMOD 2025, available at https://arxiv.org/abs/2409.09913. ↩︎ ↩︎ ↩︎
2.5 - 相似度过滤
通常,我们会使用 ORDER BY 和 LIMIT 子句来执行向量搜索。但在某些情况下,您可能希望使用 WHERE 子句过滤掉距离查询向量太远的向量。很自然地,您可能会写出如下 SQL:
返回的结果虽然符合预期,但这种写法的性能却很差。这是因为如果落在距离阈值内的向量少于 个,PostgreSQL 会强制索引继续搜索以凑够 条结果,从而遍历耗尽整个搜索空间。
为了避免这种情况,您可以使用特定语法将过滤条件直接下推(push down)到向量索引中,使索引一旦发现搜索区域超出指定距离便立即停止搜索。我们将这种可以下推到索引中的基于距离的过滤条件称为相似度过滤(similarity filter)。
当且仅当两个向量之间的 L2 距离小于 0.1 时,embedding <<->> sphere('[0, 0, 0]'::vector, 0.1) 的求值结果为 true。对于负内积请使用 <<#>> 操作符,对于余弦距离请使用 <<=>> 操作符。
此外,如果您只指定 WHERE 子句而不使用 ORDER BY,索引依然能够被有效利用。
参考
操作符类
请参阅:
数据类型
sphere_vector
- 说明:球体(Sphere)。
- 定义:
(center vector, radius REAL)。
sphere_halfvec
- 说明:球体(Sphere)。
- 定义:
(center halfvec, radius REAL)。
sphere_rabitq8
since v1.1.0
- 说明:球体(Sphere)。
- 定义:
(center rabitq8, radius REAL)。
sphere_rabitq4
since v1.1.0
- 说明:球体(Sphere)。
- 定义:
(center rabitq4, radius REAL)。
函数
sphere(vector, real)
- 说明:通过球心和半径创建一个球体。
- 定义:
SELECT ROW($1, $2)。 - 返回值:
sphere_vector - 参数:
vector,球体的球心real,球体的半径
- 示例:
SELECT sphere('[0,0,0]'::vector, 1.0)
sphere(halfvec, real)
- 说明:通过球心和半径创建一个球体。
- 定义:
SELECT ROW($1, $2)。 - 返回值:
sphere_halfvec - 参数:
halfvec,球体的球心real,球体的半径
- 示例:
SELECT sphere('[0,0,0]'::halfvec, 1.0)
sphere(rabitq8, real)
since v1.1.0
- 说明:通过球心和半径创建一个球体。
- 定义:
SELECT ROW($1, $2)。 - 返回值:
sphere_rabitq8 - 参数:
rabitq8,球体的球心real,球体的半径
- 示例:
SELECT sphere(quantize_to_rabitq8('[0,0,0]'::vector), 1.0)
sphere(rabitq4, real)
since v1.1.0
- 说明:通过球心和半径创建一个球体。
- 定义:
SELECT ROW($1, $2)。 - 返回值:
sphere_rabitq4 - 参数:
rabitq4,球体的球心real,球体的半径
- 示例:
SELECT sphere(quantize_to_rabitq4('[0,0,0]'::vector), 1.0)
操作符
<<->>(vector, sphere_vector)
- 说明:使用 L2 度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
vector,待检测的向量sphere_vector,球体
<<#>>(vector, sphere_vector)
- 说明:使用负点积度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
vector,待检测的向量sphere_vector,球体
<<=>>(vector, sphere_vector)
- 说明:使用余弦度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
vector,待检测的向量sphere_vector,球体
<<->>(halfvec, sphere_halfvec)
- 说明:使用 L2 度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
halfvec,待检测的向量sphere_halfvec,球体
<<#>>(halfvec, sphere_halfvec)
- 说明:使用负点积度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
halfvec,待检测的向量sphere_halfvec,球体
<<=>>(halfvec, sphere_halfvec)
- 说明:使用余弦度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
halfvec,待检测的向量sphere_halfvec,球体
<<->>(rabitq8, sphere_rabitq8)
since v1.1.0
- 说明:使用 L2 度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
rabitq8,待检测的向量sphere_rabitq8,球体
<<#>>(rabitq8, sphere_rabitq8)
since v1.1.0
- 说明:使用负点积度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
rabitq8,待检测的向量sphere_rabitq8,球体
<<=>>(rabitq8, sphere_rabitq8)
since v1.1.0
- 说明:使用余弦度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
rabitq8,待检测的向量sphere_rabitq8,球体
<<->>(rabitq4, sphere_rabitq4)
since v1.1.0
- 说明:使用 L2 度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
rabitq4,待检测的向量sphere_rabitq4,球体
<<#>>(rabitq4, sphere_rabitq4)
since v1.1.0
- 说明:使用负点积度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
rabitq4,待检测的向量sphere_rabitq4,球体
<<=>>(rabitq4, sphere_rabitq4)
since v1.1.0
- 说明:使用余弦度量检测向量是否位于球体内部。
- 返回值:布尔值(boolean)
- 参数:
rabitq4,待检测的向量sphere_rabitq4,球体
2.6 - PostgreSQL 调优
索引构建可以并行化执行。由于并行化会增加服务器负载,PostgreSQL 默认并未启用。如需启用并行构建,请参考以下 SQL 配置:
并行工作进程的数量还取决于表本身的配置。默认情况下,该值由 PostgreSQL 自动计算决定。如果 PostgreSQL 判定不启用并行,那么并行索引构建就不会生效。您可以通过调整表的 parallel_workers 存储参数来覆盖 PostgreSQL 的默认行为,强制启用并行索引构建。
您还需要调整以下几个设置以提升 I/O 性能:
我们观察到在某些情况下,工作异常的 JIT(即时编译)可能会对性能产生负面影响。如果您并不依赖它,可以选择将其禁用。
最后,您需要设置 PostgreSQL 共享缓冲区(shared buffers)的大小。
异步 I/O
PostgreSQL 17 首次引入了流式 I/O(streaming I/O)API。在此基础上,PostgreSQL 18 引入了异步 I/O(Asynchronous I/O)。借助异步 I/O,PostgreSQL 可以同时发起多个读取操作,并在等待结果返回的同时继续处理其他任务。这能够显著提升需要从磁盘读取大量数据的查询性能。PostgreSQL 提供了多种异步 I/O 方式,您可以根据需要进行调整。
本节内容仅适用于 PostgreSQL 18。
io_uring
io_uring 方式使用 Linux 内核的 io_uring 接口,能够减少上下文切换的开销。该接口在 Linux 内核 5.1 及更高版本中可用。您可以通过 GUC 参数 io_method 启用此方式。
由于 io_uring 会使用额外的文件描述符和锁定内存(locked memory),PostgreSQL 可能会触及系统的 RLIMIT_NOFILE 和 RLIMIT_MEMLOCK 限制。您可能需要在操作系统层面调高这些限制。另请参阅:
出于安全考虑,容器运行时、云服务商或系统管理员可能会禁用 io_uring。如果遇到此类情况,请向您的服务提供商咨询详情。另请参阅:
通常推荐使用 io_uring,但实际性能表现仍取决于您的具体工作负载。另请参阅:
本小节仅适用于 Linux 系统。
worker
这是 PostgreSQL 18 中的默认设置。PostgreSQL 通过将 I/O 请求发送到专门的进程池来避免阻塞后端进程。您可以通过 GUC 参数 io_method 显式启用此方式。
sync
sync 方式的工作机制与 PostgreSQL 17 相同:读取操作是同步且阻塞的,并使用 posix_fadvise 向操作系统提供即将发生的读取提示。通常只有在调试时才会使用此方式。您可以通过 GUC 参数 io_method 启用此方式。
2.7 - 监控
您可以通过查询 pg_stat_progress_create_index 视图来监控 PostgreSQL 索引的构建进度。
参考
构建阶段(vchordrq)
vchordrq
vchordrq 的索引构建过程包含 5 个步骤,每个步骤的阶段名称(phase)如下:
| 步骤 | 阶段消息 | 说明 | 耗时 |
|---|---|---|---|
| 1 | initializing |
开始构建索引 | 短 |
| 2 | initializing index, by default build |
该步骤仅用于默认构建(default build) | 短 |
| 2 | initializing index, by internal build |
该步骤仅用于内部构建:对表进行采样并执行分区以获取质心 | 长 |
| 2 | initializing index, by external build |
该步骤仅用于外部构建:从指定表中加载质心 | 短 |
| 3 | initializing index |
初始化索引的数据结构与存储空间 | 短 |
| 4 | inserting tuples from table to index |
将所有向量分配并插入到各自对应的列表中 | 长 |
| 5 | compacting tuples in index |
紧缩优化向量索引结构以提升查询性能 | 中等 |
第 4 步 inserting tuples from table to index 占据了索引构建过程中的大部分时间。tuples_done、blocks_done 和 blocks_total 列可用于指示该步骤的当前进度。
构建阶段(vchordg)
vchordg
vchordg 的索引构建过程包含 2 个步骤,每个步骤的阶段名称(phase)如下:
| 步骤 | 阶段消息 | 说明 | 耗时 |
|---|---|---|---|
| 1 | initializing |
开始构建索引 | 短 |
| 2 | inserting tuples from table to index |
将所有向量插入到图结构中 | 长 |
第 2 步 inserting tuples from table to index 占据了索引构建过程中的大部分时间。tuples_done、blocks_done 和 blocks_total 列可用于指示该步骤的当前进度。
2.8 - 回退参数
搜索参数通常通过 GUC 进行配置。VectorChord 还提供了另一种方式,允许将这些参数直接绑定到索引上,而不是绑定到会话(session)或事务(transaction)上。换句话说,您可以将它们作为索引存储参数(storage parameters)的一部分保存下来。
在构建索引时,您可以使用以下语法设置 probes:
现在,您无需设置 GUC 即可直接执行搜索:
如果索引已经构建完成,您可以像这样修改 probes:
您仍然可以通过 GUC 设置搜索参数。当设置了 GUC 时,GUC 的优先级高于索引存储参数。这使您能够在不锁定索引的情况下,在当前会话或事务中临时覆盖这些设置。
这种语法在以下场景中非常有用:
- 当存在多个索引且需要不同参数时。
- 当您不希望设置 GUC 时。
- 当您希望离线配置搜索参数时。
只要设置了 GUC(哪怕是在系统级别或数据库级别设置的),它都会覆盖索引上的存储参数设置。因此,为了避免难以排查的问题,我们建议仅使用一种方式来设置搜索参数:要么统一通过 GUC 设置,要么统一通过索引存储参数设置。
并非所有参数都支持此功能。有关支持此功能的全部参数,请参阅参考。
参考
索引存储参数(vchordrq)
vchordrq
probes
since v1.1.0
- 说明:
vchordrq.probes的回退值。 - 类型:整数列表(list of integers)
- 默认值:
epsilon
since v1.1.0
- 说明:
vchordrq.epsilon的回退值。 - 类型:实数(real)
- 默认值:
1.9 - 取值范围:
[0.0, 4.0]
maxsim_refine
since v1.1.0
- 说明:
vchordrq.maxsim_refine的回退值。 - 类型:整数(integer)
- 默认值:
0 - 取值范围:
[0, 2147483647]
maxsim_threshold
since v1.1.0
- 说明:
vchordrq.maxsim_threshold的回退值。 - 类型:整数(integer)
- 默认值:
0 - 取值范围:
[0, 2147483647]
索引存储参数(vchordg)
vchordg
ef_search
since v1.1.0
- 说明:
vchordg.ef_search的回退值。 - 类型:整数(integer)
- 默认值:
64 - 取值范围:
[1, 65535]
2.9 - 评估召回率
在向量搜索中,召回率(recall)是指索引返回的近似最近邻中真实最近邻所占的比例。例如,如果索引检索出 个近似最近邻,其中有 个属于真实最近邻,那么召回率就是 。
该功能目前处于预览阶段。
召回率评估
since v0.5.0召回率衡量的是搜索返回的相关结果占全部应返回真实结果的比例。在使用索引时,您通常希望了解不同参数配置所对应的召回率和 QPS。vchordrq_evaluate_query_recall 函数正是为评估召回率而设计的:它接收一条返回行标识符的查询语句,并返回对应的召回率。
vchordrq_evaluate_query_recall 函数内部依赖 ctid 将查询结果与基准真相(ground truth)进行比对。因此,传入的 query 参数必须以 SELECT ctid 开头。
默认情况下,该函数通过执行另一次高精度索引扫描来生成估算的基准真相,并据此评估召回率。如果您希望通过全表扫描(table scan)生成精确的基准真相来评估召回率,请将函数参数 exact_search 设置为 true。
查询采样
since v0.5.2为了方便评估生产或测试中的查询召回率,VectorChord 内置了查询采样方法。
假设您已经执行了一条示例向量搜索:SELECT * FROM items ORDER BY embedding <-> '[3,1,2]' LIMIT 10。
在查询执行并被采样后,您可以检查捕获到的查询要素,包括模式名(schema)、索引名、表名、列名、操作符以及目标向量。
要测量已记录查询的平均召回率,您可以构造目标查询语句并调用评估函数:
如果您正在使用包含主库(primary)和备库(standby)的流复制(replication)功能,请注意:采样到的查询不会通过复制或备份进行同步。相反,每台服务器都会根据自己实际处理的查询独立维护各自的采样查询集合。
参考
vchordg 和多向量检索不支持此功能。
搜索参数(vchordrq)
vchordrq
vchordrq.query_sampling_enable
since v0.5.2
- 说明:启用或禁用
vchordrq索引扫描的查询采样。 - 类型:布尔值(boolean)
- 默认值:
off
vchordrq.query_sampling_max_records
since v0.5.2
- 说明:控制每个索引最多记录的查询数量。该设置仅在
vchordrq.query_sampling_enable开启时生效。 - 类型:整数(integer)
- 默认值:
0 - 取值范围:
[0, 10000] - 示例:
vchordrq.query_sampling_max_records = 0将为每个索引保留 0 条查询。vchordrq.query_sampling_max_records = 1000将为每个索引最多保留最近 1000 条查询。
vchordrq.query_sampling_rate
since v0.5.2
- 说明:控制记录查询的采样率。该设置仅在
vchordrq.query_sampling_enable开启时生效。 - 类型:实数(real)
- 默认值:
0 - 取值范围:
[0, 1] - 示例:
vchordrq.query_sampling_rate = 0不记录任何查询。vchordrq.query_sampling_rate = 0.01记录约 1% 的查询。vchordrq.query_sampling_rate = 1记录每一条查询(仅用于测试目的)。
函数(vchordrq)
vchordrq
vchordrq_sampled_queries
since v0.5.2
- 说明:检索指定
vchordrq索引已记录的查询集合。 - 返回值:
tableschema_name: text,查询中表的模式名index_name: text,查询中使用的索引名称table_name: text,查询中的表名column_name: text,参与索引扫描的列名operator: text,查询中使用的距离操作符value: text,查询中目标向量的文本表示
- 参数:
regclass,vchordrq索引的对象标识符
- 示例:
SELECT vchordrq_sampled_queries('items_embedding_idx');
vchordrq_sampled_values
since v0.5.2
- 说明:检索指定
vchordrq索引已记录查询中的目标向量。 - 返回值:
text,查询中目标向量的文本表示。 - 参数:
regclass,vchordrq索引的对象标识符
- 示例:
SELECT vchordrq_sampled_values('items_embedding_idx');
- 注意:该函数仅用于调试目的。
vchordrq_evaluate_query_recall
since v0.5.0
- 说明:评估给定
vchordrq查询的召回率。 - 返回值:
real - 参数:
query: text,待评估召回率的查询语句exact_search: boolean,是否使用精确基准真相代替估算的基准真相accu_probes: text,用于生成估算基准真相的vchordrq.probesaccu_epsilon: real,用于生成估算基准真相的vchordrq.epsilon
- 示例:
SELECT vchordrq_evaluate_query_recall(query => $$ SELECT ctid FROM t ORDER BY val <-> '[0.5, 0.25, 1.0]' LIMIT 10 $$);SELECT vchordrq_evaluate_query_recall(query => $$ SELECT ctid FROM t ORDER BY val <-> '[0.5, 0.25, 1.0]' LIMIT 10 $$, exact_search => true);SELECT vchordrq_evaluate_query_recall(query => $$ SELECT ctid FROM t ORDER BY val <-> '[0.5, 0.25, 1.0]' LIMIT 10 $$, accu_probes => '9999', accu_epsilon => 4.0);
视图(vchordrq)
vchordrq
vchordrq_sampled_queries
since v0.5.2
- 说明:检索所有
vchordrq索引已记录的查询集合。 - 示例:
SELECT * from vchordrq_sampled_queries;
- 注意:该视图仅用于调试目的。
2.10 - 预热
PostgreSQL 启动后,表和索引只有在首次被访问时才会从存储加载到缓冲池(buffer pool)中。随着查询的不断执行,索引中被频繁访问的部分会自然地缓存在缓冲池里。然而,在执行最初的几批查询时,由于缓冲池为空,查询速度往往较慢。
PostgreSQL 扩展 pg_prewarm 提供了 pg_prewarm 函数,可以在一定程度上解决这一问题。在 PostgreSQL 启动后,您只需向该函数传入索引名称,它就会将索引从存储加载到缓冲池中。
不过,这种方法只有在缓冲池远大于索引大小时才有效。对于向量索引而言,索引大小往往远超内存容量。向量索引在设计上将索引数据分为两部分:体量较小的热数据部分(hot portion)和体量庞大的冷数据部分(cold portion)。向量索引只需要将热数据部分保留在内存中即可获得理想的性能。因此,VectorChord 提供了专用的预热函数,仅将索引的热数据部分加载到内存中。
即使索引大小远大于内存容量,该函数依然能够很好地发挥作用。
参考
函数(vchordrq)
vchordrq
vchordrq_prewarm
- 说明:该函数通过将
vchordrq索引的热数据加载到缓冲池中来预热索引。 - 返回值:
text - 参数:
regclass,vchordrq索引的对象标识符
- 示例:
SELECT vchordrq_prewarm('items_embedding_idx')
函数(vchordg)
vchordg
vchordg_prewarm
since v0.5.0
- 说明:该函数通过将
vchordg索引的热数据加载到缓冲池中来预热索引。 - 返回值:
text - 参数:
regclass,vchordg索引的对象标识符
- 示例:
SELECT vchordg_prewarm('items_embedding_idx')
2.11 - 预过滤
在带过滤条件的索引扫描中,通常索引会先执行扫描,然后由 PostgreSQL 检查返回行是否满足过滤条件。在本页中,“过滤条件(filter)”是指 PostgreSQL 查询计划中索引扫描节点上的 Filter,它通常由 SQL 语句中的 WHERE 子句构造而成,并且不需要具备特定的形式。
然而,对于向量搜索而言,这种方式并不总是最高效的。请看下面这个查询:
为了检索出 个满足过滤条件的向量,索引大约返回了 行数据。这意味着索引执行了大量冗余计算。如果索引能够利用过滤条件进行剪枝,计算量将会大幅减少。为此,向量索引提供了 GUC 参数 vchordrq.prefilter,允许根据过滤条件对搜索空间进行剪枝。
预过滤(Prefilter)使向量索引能够在搜索过程中结合过滤条件进行判断,从而剪枝搜索空间;更小的搜索空间意味着更高的搜索效率。不过,检查过滤条件是否满足本身也会引入额外开销。因此,仅当过滤条件严格(能够排除大量行)且轻量(计算开销远低于计算向量距离)时,才推荐使用预过滤。为了便于理解,这里给出两个不适合使用预过滤的反例:
id % 97 > 0:该过滤条件过于宽松email ~ '^([a-zA-Z]+)*$':该过滤条件计算开销过高
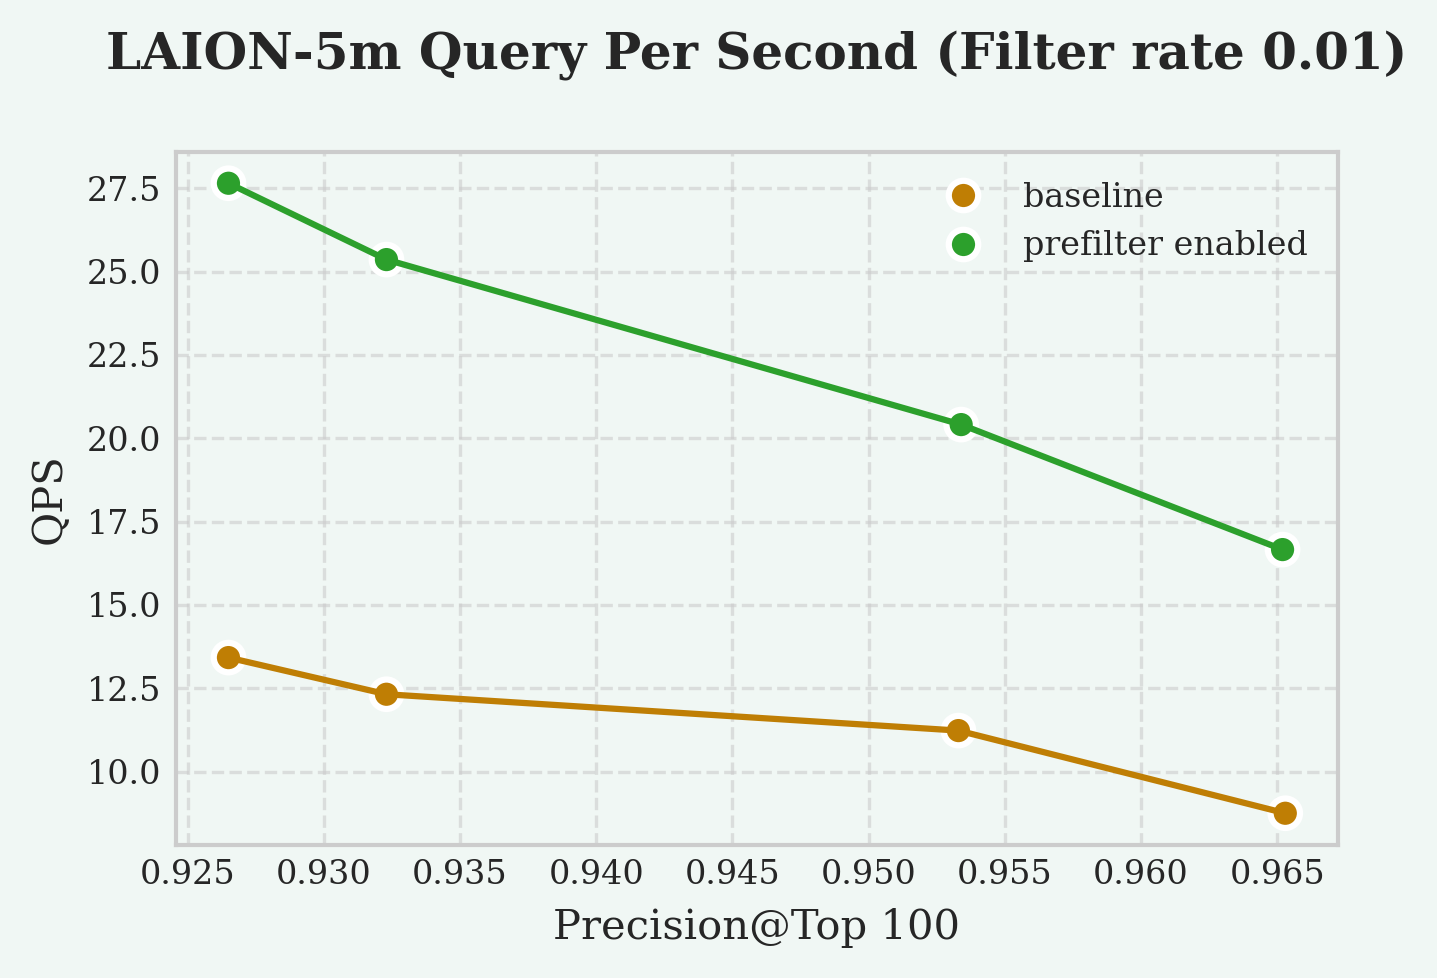
根据我们的实验结果,在不同选择率(selectivity)下启用预过滤带来的 QPS 加速比如下:
- 在 1% 选择率下,QPS 提升 200%
- 在 10% 选择率下,QPS 提升 5%
参考
vchordg 不支持此功能。
搜索参数(vchordrq)
vchordrq
vchordrq.prefilter
since v0.4.0
- 说明:GUC 参数
vchordrq.prefilter允许在计算距离之前先对过滤条件进行求值。例如,在查询SELECT * FROM items WHERE id % 2 = 0 ORDER BY embedding <-> '[3,1,2]' LIMIT 5中,正常情况下索引会先计算所有候选行的embedding <-> '[3,1,2]'距离,然后将行传递给 PostgreSQL,由 PostgreSQL 过滤掉id % 2 != 0的行。启用该参数后,索引可以在计算距离之前预先评估过滤条件并丢弃不匹配的行,从而提高查询效率。 - 类型:布尔值(boolean)
- 默认值:
false
2.12 - 预取
预取(Prefetch)能够大幅加速涉及 I/O 操作的查询。它的工作原理是根据索引的实际访问需求,主动将缓冲区预读到操作系统页缓存(page cache)或 PostgreSQL 的缓冲池(buffer pool)中。
预取有助于将 I/O 与计算重叠执行,以及将不同的 I/O 操作相互重叠执行,从而显著减少查询执行期间等待缓冲区的时间,进而提升整体查询性能。
该功能默认启用。在 VectorChord 0.4.0 及更高版本中,任何查询都能从预取机制中受益。
在 0.4.0 版本之前,VectorChord 使用 PostgreSQL 的同步 I/O 接口。从 0.4.0 版本开始,VectorChord 在较新版本的 PostgreSQL 上使用异步 I/O 接口。VectorChord 所使用的 I/O 接口可以通过 GUC 参数进行控制。
在 GUC 参数中,同步 I/O 接口被称为 read_buffer,异步 I/O 接口被称为 read_stream,而 VectorChord 的模拟异步接口被称为 prefetch_buffer。
对于远小于内存大小的索引,这三种预取模式之间几乎没有差异。read_stream 可以加速所有基于磁盘的索引,但它仅在 PostgreSQL 17 和 18 上可用。为了解决这个问题,VectorChord 提供了一个名为 prefetch_buffer 的模拟异步 I/O 接口,在所有 PostgreSQL 版本上均可用,作为旧版本 PostgreSQL 的回退方案。prefetch_buffer 的效果略逊于 read_stream。
| 预取模式 | 说明 | 支持的 PostgreSQL 版本 |
|---|---|---|
read_stream |
PostgreSQL 中的异步 I/O 接口 | PostgreSQL 17, 18 |
prefetch_buffer |
VectorChord 的模拟异步 I/O 接口,在旧版本 PostgreSQL 上作为回退方案使用 | PostgreSQL 13, 14, 15, 16, 17, 18 |
read_buffer |
PostgreSQL 中的同步 I/O 接口 | PostgreSQL 13, 14, 15, 16, 17, 18 |
要在 PostgreSQL 18 上通过 read_stream 充分发挥此功能的威力,您需要启用异步 I/O。另请参阅 PostgreSQL 调优。
参考
搜索参数(vchordrq)
vchordrq
vchordrq.io_search
since v0.4.0
- 说明:该 GUC 参数控制在向量搜索中读取位向量(bit vector)时的 I/O 预取策略,会影响基于磁盘向量的搜索性能。
- 类型:字符串(string)
- 取值范围:取决于 PostgreSQL 版本
- PostgreSQL 13, 14, 15, 16:
{"read_buffer", "prefetch_buffer"} - PostgreSQL 17, 18:
{"read_buffer", "prefetch_buffer", "read_stream"}
- PostgreSQL 13, 14, 15, 16:
- 默认值:取决于 PostgreSQL 版本
- PostgreSQL 13, 14, 15, 16:
prefetch_buffer - PostgreSQL 17, 18:
read_stream
- PostgreSQL 13, 14, 15, 16:
- 注意:
read_buffer表示优先使用ReadBuffer。prefetch_buffer表示优先结合使用PrefetchBuffer和ReadBuffer。read_stream表示优先使用read_stream。
vchordrq.io_rerank
since v0.4.0
- 说明:该 GUC 参数控制在向量搜索中读取全精度向量时的 I/O 预取策略,会显著影响基于磁盘向量的搜索性能。
- 类型:字符串(string)
- 取值范围:取决于 PostgreSQL 版本
- PostgreSQL 13, 14, 15, 16:
{"read_buffer", "prefetch_buffer"} - PostgreSQL 17, 18:
{"read_buffer", "prefetch_buffer", "read_stream"}
- PostgreSQL 13, 14, 15, 16:
- 默认值:取决于 PostgreSQL 版本
- PostgreSQL 13, 14, 15, 16:
prefetch_buffer - PostgreSQL 17, 18:
read_stream
- PostgreSQL 13, 14, 15, 16:
- 注意:
read_buffer表示优先使用ReadBuffer。prefetch_buffer表示优先结合使用PrefetchBuffer和ReadBuffer。read_stream表示优先使用read_stream。
搜索参数(vchordg)
vchordg
vchordg.io_search
since v0.5.0
- 说明:该 GUC 参数控制在向量搜索中读取位向量(bit vector)时的 I/O 预取策略,会影响基于磁盘向量的搜索性能。
- 类型:字符串(string)
- 取值范围:取决于 PostgreSQL 版本
- PostgreSQL 13, 14, 15, 16:
{"read_buffer", "prefetch_buffer"} - PostgreSQL 17, 18:
{"read_buffer", "prefetch_buffer", "read_stream"}
- PostgreSQL 13, 14, 15, 16:
- 默认值:取决于 PostgreSQL 版本
- PostgreSQL 13, 14, 15, 16:
prefetch_buffer - PostgreSQL 17, 18:
read_stream
- PostgreSQL 13, 14, 15, 16:
- 注意:
read_buffer表示优先使用ReadBuffer。prefetch_buffer表示优先结合使用PrefetchBuffer和ReadBuffer。read_stream表示优先使用read_stream。
vchordg.io_rerank
since v0.5.0
- 说明:该 GUC 参数控制在向量搜索中读取全精度向量时的 I/O 预取策略,会显著影响基于磁盘向量的搜索性能。
- 类型:字符串(string)
- 取值范围:取决于 PostgreSQL 版本
- PostgreSQL 13, 14, 15, 16:
{"read_buffer", "prefetch_buffer"} - PostgreSQL 17, 18:
{"read_buffer", "prefetch_buffer", "read_stream"}
- PostgreSQL 13, 14, 15, 16:
- 默认值:取决于 PostgreSQL 版本
- PostgreSQL 13, 14, 15, 16:
prefetch_buffer - PostgreSQL 17, 18:
read_stream
- PostgreSQL 13, 14, 15, 16:
- 注意:
read_buffer表示优先使用ReadBuffer。prefetch_buffer表示优先结合使用PrefetchBuffer和ReadBuffer。read_stream表示优先使用read_stream。
2.13 - 表内重排序
PostgreSQL 索引会存储行标识符(row identifier)以及被索引列的值。通常情况下,被索引的列具有简单的数据类型,例如整数或长度有限的短字符串。
然而,如果被索引的列是向量类型,那么表和索引都会存储向量,这意味着您需要为这些向量支付双倍的存储成本。如果您希望降低这部分开销,可以在构建索引时启用 rerank_in_table。启用后,索引将采用一种巧妙的方式:它自身不再存储原始向量,而是在需要时直接从表中读取它们。
启用该选项会导致查询性能下降,并且在启用 rerank_in_table 时,预取(prefetch)功能将无法生效。
这是一种以时间换空间的折中方案,通常不推荐使用,仅适用于需要解决磁盘存储空间极度紧张的特定场景。
参考
vchordg 不支持此功能。
索引选项(vchordrq)
vchordrq
rerank_in_table
since v0.2.1
- 说明:该选项决定是否从表中读取向量进行重排序。如果启用,索引所需的存储空间将减少,但查询延迟会显著增加。仅当磁盘空间极其有限时才应启用此选项。
- 类型:布尔值(boolean)
- 默认值:
false - 示例:
rerank_in_table = false表示向量同时存储在索引和表中,搜索时从索引中读取向量。rerank_in_table = true表示向量仅存储在表中,搜索时从表中读取向量。
2.14 - 分区调优
对于大表而言,分区阶段主导了整个索引构建的时间与内存消耗。
分区阶段的时间复杂度为 ,内存消耗(以字节为单位)可以近似表示为 ,
其中:
- 是向量维度(如果设置了
build.internal.kmeans_dimension,则为该参数的值)。 - 是
build.internal.sampling_factor。 - 是
build.internal.lists[-1]。 - 是
build.internal.build_threads。 - 是
build.internal.kmeans_iterations。
本页介绍几种用于优化构建时间和内存消耗的调优技巧。
层次 K-means
层次 K-means(Hierarchical K-means)是一种比劳埃德算法(Lloyd’s algorithm)更快的聚类算法。应用该算法后,渐近时间复杂度将降低至 。作为折中,它会对搜索性能和召回率产生轻微的负面影响。
用法:
降低采样因子
降低采样因子(sampling factor)可以线性地改善构建时间和内存消耗。作为折中,它会对搜索性能和召回率产生中等程度的负面影响。
用法:
降维
降维功能使用快速约翰逊-林登施特劳斯变换(Fast Johnson–Lindenstrauss transform),将参与聚类的向量维度降低至原始维度以下,从而线性地改善构建时间和内存消耗。作为折中,它会对搜索性能和召回率产生轻微的负面影响。
用法:
参考配置
LAION 100M
数据集:
- 来源:https://sisap-challenges.github.io/2024/datasets/
- 度量方式:内积(Inner Product)
- 维度:768
- 向量数量:100,000,000
- 测试向量数量:1,000
测试机器(AWS EC2 i7i.4xlarge):
- CPU:Intel Xeon Platinum 8559C
- vCPU 数量:16
- 内存:128 GiB
- 存储:3750 GiB NVMe SSD
测试结果:
- 总构建时间:18 分钟
- 峰值内存:6 GiB
- 测试用例 1
- 参数
vchordrq.probes = '40,140'vchordrq.epsilon = 1.4
- QPS @ Top10:120
- Recall @ Top10:0.949
- 参数
DEEP 1B
数据集:
- 来源:https://big-ann-benchmarks.com/neurips21.html
- 度量方式:欧氏距离(Euclidean)
- 维度:96
- 向量数量:1,000,000,000
- 测试向量数量:10,000
测试机器(AWS EC2 i7ie.6xlarge):
- CPU:Intel Xeon Platinum 8559C
- vCPU 数量:24
- 内存:192 GiB
- 存储:7500 GiB NVMe SSD
测试结果:
- 总构建时间:107 分钟
- 峰值内存:64 GiB
- 测试用例 1
- 参数
vchordrq.probes = '40,250'
- QPS @ Top10:68
- Recall @ Top10:0.951
- 参数
2.15 - 外部构建
除了使用分区调优中的方法(以牺牲一定 QPS 和召回率为代价来缩短构建时间并降低内存消耗)之外,您还可以选择在其他机器或 GPU 上离线运行分区阶段。由于 vchordg 没有分区阶段,因此该特性不支持 vchordg。
假设表名为 t,待建索引的列名为 val。
具体而言,您需要先对待建索引的列进行采样。
基于这些样本,您可以将向量空间划分为多个 Voronoi 单元(Voronoi cells)。完成划分后,创建一张表并将分区质心插入其中。
随后可以使用以下语法创建索引:
表结构格式
存储分区信息的表必须严格遵循以下表结构(Schema):
- 第一列必须为
id,类型为integer,不可为 null(NOT NULL),且必须唯一(UNIQUE)。 - 第二列必须为
parent,类型为integer,允许为 null(根节点为NULL)。 - 第三列必须为
vector,类型为vector,不可为 null(NOT NULL)。目前尚不支持halfvec或其他类型。
在逻辑上,这些数据构成了一棵树。从根节点到每个叶子节点的距离(深度)必须完全相同。
如果上述任何属性未得到满足,系统都会报错。
分区示例
为了帮助您快速上手,下面给出一个使用 faiss 执行向量空间分区的最小代码示例。
这段代码会计算出不同层级上所有 Voronoi 单元的生成元(质心)。树中的父子关系可通过计算最短距离来确定,此处省略具体细节。您可以使用任何能够生成多级 Voronoi 单元的算法,例如球面 K-means(spherical K-means)、平衡 K-means(balanced K-means)或 GPU K-means。
3 - 应用案例
| 标题 | 描述 | 链接 | 代码 |
|---|---|---|---|
| 基于 Postgres 原生 BM25 与 VectorChord 的混合检索 | 本文探讨如何在 Postgres 中结合使用 VectorChord-bm25(关键词检索)与 VectorChord(语义检索)来实现混合检索。 | 混合检索 | GitHub 仓库 |
| 在 PostgreSQL 中使用 ColBERT 重排序为向量检索加速 | 本文演示如何结合使用 PostgreSQL 扩展 VectorChord、pgvector 以及 ColBERT 重排序技术。 | ColBERT 重排序 | GitHub 仓库 |
| 超越纯文本:使用 Modal 与 VectorChord 在 PostgreSQL 中实现免 OCR RAG | 本文将指导您直接在熟悉的 PostgreSQL 数据库中构建一套免 OCR 的 RAG 系统。我们将结合 ColQwen2 视觉语言模型的强大能力、VectorChord 在 Postgres 中的高效多向量检索能力,以及 Modal 的可扩展 GPU 嵌入生成服务。 | 免 OCR RAG | GitHub 仓库 |
3.1 - 基于 Postgres 原生 BM25 与 VectorChord 的混合检索
在检索增强生成(RAG)时代,从海量数据集中高效检索相关数据对于企业和开发者而言至关重要。传统的基于关键词的检索方法(例如使用 BM25 作为评分机制的方法)擅长根据词频和精确关键词匹配对文档进行排序,因此在处理结构化查询和关键词密集型内容时非常高效。然而,它们在理解同义词、上下文细微差别以及深层语义意图方面往往力不从心。相反,基于向量的检索能够捕捉深层语义信息,面对多样化的查询具备更好的泛化能力,但有时会在精确关键词匹配上牺牲精度。混合检索(Hybrid Search)通过将 BM25 的精确性与向量检索的上下文理解能力相结合,弥补了这一差距,从而提供更快、更准确且具备语义感知的检索结果。
本文将探讨如何在 Postgres 中使用 VectorChord-bm25 进行关键词检索,并使用 VectorChord 进行语义检索,从而实现混合检索。通过结合 VectorChord-bm25 基于 Block-WeakAnd 算法的 BM25 排序能力与 VectorChord 先进的向量相似性检索能力,您可以构建一个将关键词精度与语义理解无缝融合的稳健检索系统。无论您是在构建推荐引擎、文档检索系统还是企业级搜索解决方案,本指南都将带您逐步解锁混合检索的全部潜能。
所有相关的基准测试代码均可在此处获取。
混合检索原理解析
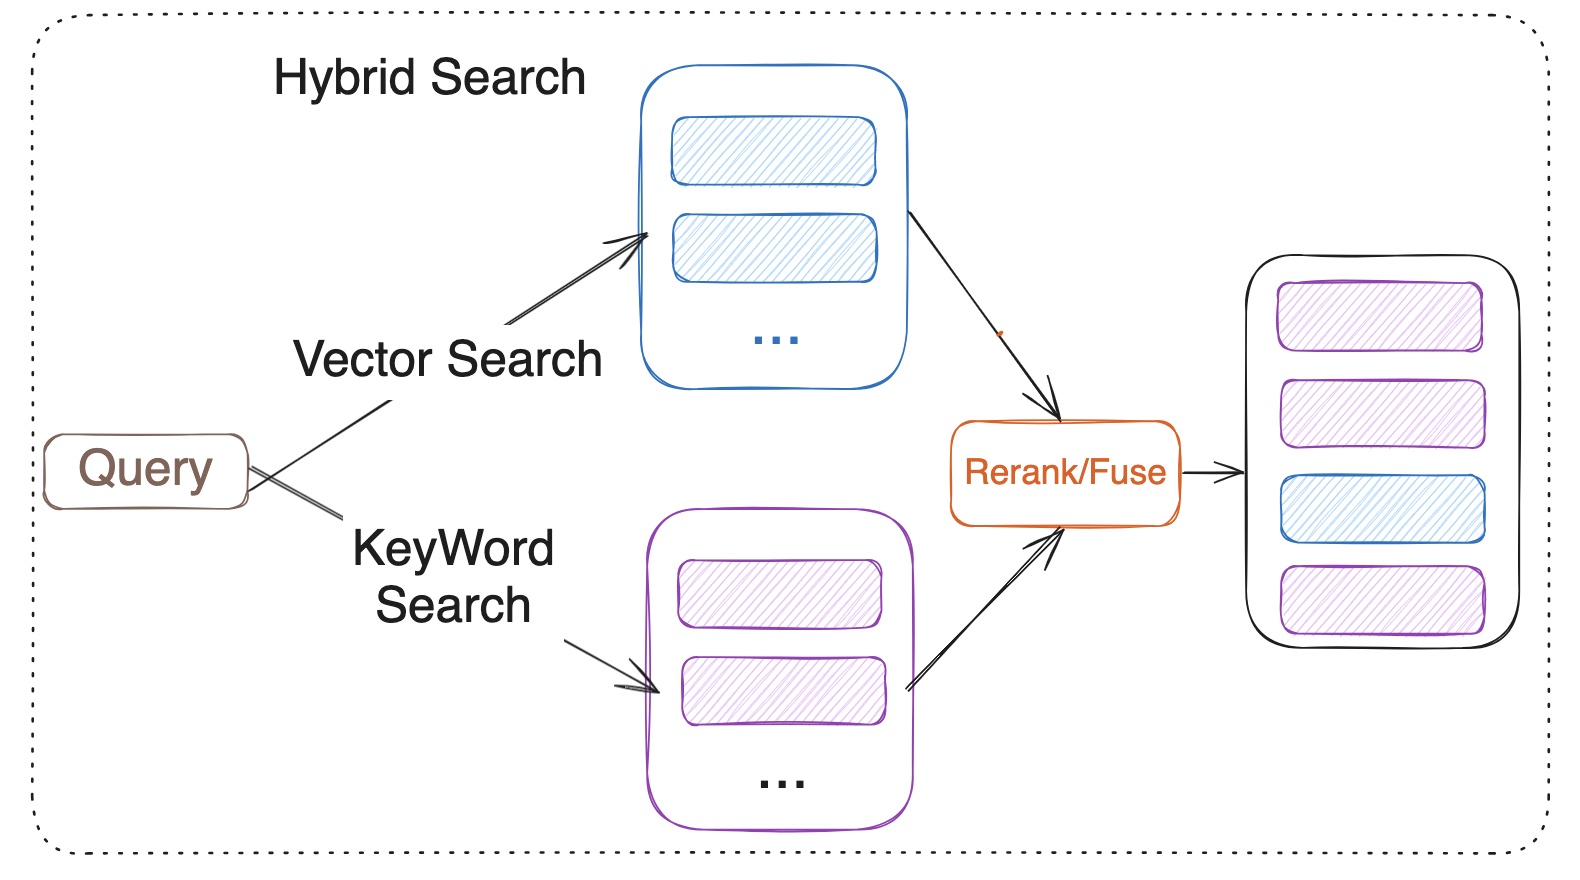
混合检索会将向量检索与关键词检索的结果进行合并。向量检索基于查询与文档之间的语义相似度,而关键词检索则依赖于 BM25 排序算法。不过需要注意的是,BM25 本身仅负责对文档进行打分,而完整的关键词检索流程还包括分词(Tokenization)、**索引构建(Indexing)和查询解析(Query Parsing)**等步骤。混合检索会利用重排序器(Reranker)或结果融合(Fusion)技术来整合两种方法的结果。融合方法包括针对多路召回策略的倒数排序融合(RRF,Reciprocal Rank Fusion)或加权评分;基于模型的重排序则包括诸如 bge-reranker-v2-m3 等交叉编码器(Cross-Encoder)模型,以及多向量表示模型 ColBERT。
什么是 VectorChord?
您可能已经熟悉 pgvector——一款面向 Postgres 的开源向量相似性检索扩展。然而,面对大规模或性能敏感型场景,往往需要更先进的向量检索解决方案,而 VectorChord 正是一个绝佳的选择。
欢迎阅读博文《VectorChord:在 PostgreSQL 中仅需 1 美元存储 400k 向量》,深入了解其设计动机与架构原理。
什么是 VectorChord-BM25
VectorChord-BM25 是一款用于关键词检索的 PostgreSQL 扩展。它不仅实现了 BM25 排序,还内置了分词器(Tokenizer)以及用于加速检索的 Block-WeakAnd 索引。
什么是 BM25?
BM25(Best Matching 25)是信息检索领域常用的一种概率排序函数,用于评估文档与查询之间的匹配程度。它基于词频(TF,Term Frequency)和逆文档频率(IDF,Inverse Document Frequency)计算相关性得分,同时引入了文档长度归一化机制。该公式确保在单篇文档中频繁出现的词(TF)以及在整个语料库中较为罕见的词(IDF)都能获得合理的权重,从而提升搜索的准确性与相关性。其中,IDF 衡量一个词在整个文档集合中出现的频率——出现次数越少,其权重越高;TF 则表示查询中的特定词在目标文档中出现的频率——TF 越高,说明查询与该文档之间的相关性越强。
为什么需要 Postgres 原生的 BM25 排序实现?
在我们此前的博文《VectorChord-BM25:以比 Elasticsearch 快 3 倍的 BM25 排序彻底革新 PostgreSQL 搜索》中,我的同事 Allen 已经给出了详尽且充分的解释,欢迎参考阅读。
教程:使用 VectorChord-BM25 与 VectorChord 实现混合检索
在本教程中,我们将指导您逐步在 PostgreSQL 中使用 VectorChord-BM25 和 VectorChord 实现混合检索。我们将涵盖以下内容:
-
使用 VectorChord 进行语义检索
-
使用 VectorChord-BM25 进行关键词检索
-
重排序(Rerank)
前置条件
- 安装包含 VectorChord-BM25 与 VectorChord 的 Postgres
如果您希望快速复现本教程,可以使用 tensorchord/vchord-suite 镜像来运行由 TensorChord 提供的多个扩展。
您可以运行以下命令来启动包含 VectorChord-BM25 与 VectorChord 的 Postgres 容器:
- 准备嵌入模型与数据
在嵌入生成方面,我们可以使用如 BGE-M3 这样的预训练嵌入模型为文档生成向量。BGE-M3 是一款高质量的嵌入模型,以其多功能性、多语言支持和多粒度表征能力而闻名。
在验证评估方面,我们使用 BEIR 数据集——这是一个异构的信息检索基准测试集。它非常易于使用,支持在 15 个以上的多样化信息检索数据集上评估模型表现。
首先,您需要将数据加载到 PostgreSQL 中,然后可以使用以下代码为文档生成嵌入向量并写入数据库:
生成嵌入向量的代码如下:
数据处理与嵌入生成的完整代码可在此处查看。
使用 VectorChord 进行语义检索
在语义检索部分,我们使用了在 VectorChord PostgreSQL 扩展中经过深度优化的 RaBitQ 算法。RaBitQ 是一种面向高维空间的量化算法,旨在提升嵌入向量等高维数据的存储与检索效率。
它通过将高维向量映射到低维离散空间,同时保留原始向量的相似性信息来实现这一目标。这一过程在大幅降低存储需求与计算开销的同时,依然能够保持极高的检索精度。
如果您发现在自己的数据集上构建索引速度较慢,可以利用外部构建(External Build)功能来加速这一过程。更多详情请参阅我们此前的博文:VectorChord 外部质心构建的优势与操作步骤。
索引构建完成后,您可以使用以下 SQL 查询来检索相似文档:
使用 VectorChord-BM25 进行关键词检索
对于关键词检索,我们需要使用**分词器(Tokenizer)**将文本转换为 BM25 向量——它类似于一种记录词汇 ID 及其出现频次的稀疏向量。
下面详细解释一下这一操作:tokenize 函数用于按照指定的分词器对文本进行分词。在本例中,我们使用了 Unicode 分词器。tokenize 函数的输出是一个 BM25 向量,即存储文本中每个词的词汇表 ID 及其出现次数的稀疏向量。例如,1035:7 表示词汇表 ID 为 1035 的词在该文本中出现了 7 次。
创建索引后,您就可以计算查询与各个文档向量之间的 BM25 得分了。请注意,这里的 BM25 得分是负数,意味着数值越小(绝对值越大),文档的相关性越高。我们之所以特意将其设计为负数,是为了让您能够直接使用默认的升序 ORDER BY 优先检索出最相关的文档。
重排序与融合(Rerank/Fuse)
当您分别获取到语义检索和关键词检索的结果后,可以通过**融合(Fuse)或重排序(Rerank)**流程将两部分结果合并。
- 结果融合(倒数排序融合,Reciprocal Rank Fusion (RRF))
RRF 的优势在于它不依赖于具体的得分量纲,而是基于排名位置进行融合,因此非常适合将采用不同评分标准的排序系统结合起来。
其中:
-
d表示文档。 -
n表示参与融合的排序系统数量。 -
rank表示文档在对应排序系统中的排名。 -
k为调节参数,通常取值为 60(经验值),用于控制排名位置对最终得分的影响程度。
- 交叉编码器(Cross-Encoder)模型重排序
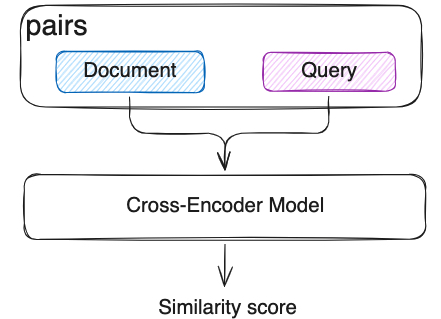
在语义检索阶段,我们已经使用双编码器(Bi-Encoder)分别将文档和查询编码为向量。但这种独立编码的方式导致查询与文档之间缺乏深层交互。交叉编码器(Cross-Encoder)模型则会将查询和文档作为一个整体同时输入模型,使模型能够同时看到两者的内容,并通过 Transformer 层捕捉它们之间细粒度的语义关联。与 RRF 相比,Cross-Encoder 模型能够更细腻地捕捉查询与文档之间的语义关系,准确率更高,但计算速度相对较慢。
评估结果
我们在多个 BEIR 数据集上测试了上述方法的 NDCG@10 指标,Top-10 评估结果如下:
| 数据集 | 语义检索 | BM25 | Cross-Encoder 重排序 | RRF |
|---|---|---|---|---|
| FiQA-2018 | 0.40343 | 0.25301 | 0.42706 | 0.37632 |
| Quora | 0.88433 | 0.78687 | 0.89069 | 0.87014 |
| SCIDOCS | 0.16055 | 0.15584 | 0.17942 | 0.17299 |
| SciFact | 0.57631 | 0.68495 | 0.74635 | 0.67855 |
从上表可以得出以下几点结论:
-
与单一的 BM25 或语义检索相比,使用 Cross-Encoder 模型进行重排序能够在不同数据集上显著提升检索性能。
-
在部分数据集上,RRF 可能会导致性能有所下降。因此,在决定是否采用 RRF 之前,请务必针对您的实际数据进行验证测试。如果验证有效,选择 RRF 将是一个非常经济高效的方案——因为它的计算速度比 Cross-Encoder 模型重排序快得多,且几乎不消耗额外计算资源。
所有相关的基准测试代码均可在此处获取。如果您有任何疑问,欢迎随时在 Discord 上与我们交流,或发送邮件至 rh@vonng.com。
未来规划
上述测试结果充分展示了混合检索方法的巨大潜力。未来,我们将重点围绕以下几个方向进一步推进 RAG 技术:
- 改进重排序方法:探索其他基于模型的重排序方案(例如 ColBERT 或 ColPali),以进一步提升重排序性能。
- 融合图检索(Graph Search):研究使用 Apache AGE 扩展进行图检索,并将其与混合检索方法相结合,从而更进一步提升检索效果。
参考资料
- https://github.com/pgsty/vchord
- https://github.com/pgsty/vchord_bm25
- https://techcommunity.microsoft.com/blog/adforpostgresql/introducing-the-graphrag-solution-for-azure-database-for-postgresql/4299871
- https://www.pinecone.io/learn/hybrid-search-intro/
- https://www.pinecone.io/learn/series/rag/rerankers/
- https://blog.vespa.ai/improving-zero-shot-ranking-with-vespa-part-two/
3.2 - 在 PostgreSQL 中使用 ColBERT 重排序为向量检索加速
传统的向量检索方法通常采用句级别嵌入(Sentence Embeddings)来查找相似内容。然而,通过对词元嵌入(Token Embeddings)进行池化(Pooling)来生成句嵌入,可能会损失词元层级中蕴含的细粒度信息。ColBERT 通过将文本表示为词元级的多向量(Multi-vectors)而非单个聚合向量,有效克服了这一缺陷。这种方法利用词元级的上下文晚期交互(Contextual Late Interaction),使 ColBERT 能够比仅依赖句嵌入的方法保留更丰富的细微语义信息,从而显著提高检索精度。
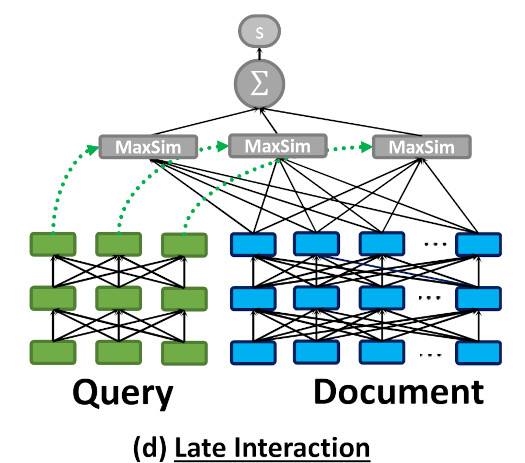
如上图所示,ColBERT 会将每篇文档和每个查询编码为一组词元向量列表,并在查询时计算最大相似度(MaxSim)。
词元级的晚期交互需要消耗更多的计算资源和存储空间。这使得在大规模数据集上直接使用 ColBERT 检索充满挑战,尤其是在对低延迟有严格要求的场景下。
一种行之有效的解决方案是将句级别的向量检索与词元级的晚期交互重排序相结合——这样既能利用近似向量检索的高效性,又能兼顾多向量相似性检索的高质量。
此外,多向量方法并不仅限于纯文本检索任务,它同样适用于视觉文档理解。在多模态检索模型领域,诸如 ColPali 和 ColQwen 等前沿模型能够直接将文档图像编码为多向量表示,展现出比传统“OCR 转文本”方案更强大的性能。
本文将演示如何结合使用 PostgreSQL 扩展 VectorChord、pgvector 以及 ColBERT 重排序技术。
实战教程
假设我们已经准备好了文档数据,首先创建一张表来存储所有文档:
在这里,我们创建了一张同时包含句级别嵌入(emb)和词元级别嵌入数组(embs)的表。
市面上有许多嵌入 API 和开源模型,您可以根据实际业务场景选择合适的句向量模型。
对于词元级嵌入,我们使用 ColBERT 进行编码:
ColBERT 模型默认生成 128 维的向量。
插入数据的代码如下:
在向量检索部分,我们可以使用 VectorChord 构建高性能的 RaBitQ 索引:
为了加快索引构建速度,我们可以利用外部质心构建功能。更多详情请参阅《VectorChord 外部质心构建的优势与操作步骤》。
现在,我们可以在 PostgreSQL 中执行初步向量查询:
为了支持 MaxSim 重排序,我们需要在数据库中创建一个自定义函数:
接下来,我们就可以对向量检索召回的候选文档进行重排序了:
评估结果
我们在多个 BEIR 数据集上测试了该方法,结果如下:
| 数据集 | 初始检索 NDCG@10 | 重排序后 NDCG@10 |
|---|---|---|
| fiqa | 0.23211 | 0.3033 |
| quora | 0.31599 | 0.3934 |
结果表明,ColBERT 重排序能够显著提升向量检索的结果质量。
所有相关的基准测试代码均可在此处获取。
未来规划
将向量检索、全文检索与 ColBERT 重排序相结合,可以进一步提升整体检索性能。我们目前也在积极开发 PostgreSQL BM25 扩展,敬请期待。
参考资料
3.3 - 超越纯文本:使用 Modal 与 VectorChord 在 PostgreSQL 中实现免 OCR RAG
为复杂文档构建高效的检索增强生成(RAG)系统,往往让人感觉像是在与混乱而繁琐的数据流水线搏斗。尤其是在处理 PDF 或扫描图像时,传统方法高度依赖光学字符识别(OCR)和版面分析。这些步骤不仅速度缓慢、容易出错,而且常常会丢失表格、图表和排版格式等至关重要的视觉上下文信息。但是,如果您可以直接根据文档的视觉外观(而不仅仅是提取出的纯文本)来检索文档,会怎样呢?
本文将手把手指导您直接在熟悉的 PostgreSQL 数据库中构建这样一套免 OCR 的 RAG 系统。我们将结合 ColQwen2 视觉语言模型的强大理解能力、VectorChord 在 Postgres 中的高效多向量检索能力,以及 Modal 用于 GPU 加速嵌入生成的弹性扩展能力。准备好简化您的 RAG 技术栈,在免去复杂预处理的同时大幅提升检索准确率吧!
本文将涵盖以下内容:
-
什么是 ColQwen2,以及为什么它会带来颠覆性变革。
-
VectorChord 如何在 Postgres 中实现高级多向量检索。
-
从零构建并评估该系统的分步实战教程。
什么是 ColQwen2?视觉理解的强大力量
要理解 ColQwen2,我们首先需要了解它的基石:ColPali。正如论文《ColPali: Efficient Document Retrieval with Vision Language Models》中所介绍的,ColPali 提出了一种利用视觉语言模型(VLM)的全新文档检索范式。它不再依赖充满缺陷的 OCR,而是直接利用文档丰富的视觉特征(包括文本、图像、表格、版面布局等肉眼可见的一切信息)来建立索引。
不妨回想一下传统 OCR 的局限性:复杂的排版被拆得支离破碎,表格变成一堆乱码,而图像往往被完全忽略。这就好比试图仅凭一份漏洞百出的速记稿去理解整本书。ColPali 则另辟蹊径,使用强大的 VLM(最初基于 PaliGemma)直接生成能够捕捉文档整体视觉特征的嵌入向量。其核心优势源于两大关键设计:
-
融合上下文的视觉嵌入(Contextualized Vision Embeddings): 使用 VLM 直接从文档页面图像生成信息丰富的嵌入向量。
-
晚期交互(Late Interaction): 这一巧妙的技术允许查询的文本语义在检索时直接与文档的细粒度视觉特征进行交互。它不再仅仅是匹配文本摘要,而是将查询概念与文档页面内的视觉证据进行直接比对。

ColPali 架构图(图片引自 ColPali 论文)
ColQwen2 建立在这一强大的 ColPali 架构之上,并将底层 VLM 替换为了更新的 Qwen2-VL-2B 模型。它能够生成 ColBERT 风格的多向量表示,同时从文本和图像中捕捉细粒度细节。正如在 vidore-leaderboard 榜单上所展示的那样,ColQwen2 以实用的模型体积实现了令人惊艳的检索表现。
VectorChord 如何在 Postgres 中赋能 ColQwen2?
这正是 VectorChord 发挥关键作用的地方——它将这一前沿的 VLM 能力无缝引入您的 PostgreSQL 数据库。ColQwen2(以及 ColPali)高度依赖**多向量表示(Multi-vector Representations)和晚期交互(Late Interaction)**机制,尤其需要高效的 **MaxSim(最大相似度)**运算支持。
计算 MaxSim(即找出查询向量集合中任意向量与文档向量集合中任意向量之间的最高相似度得分并求和)在计算上极其繁重,当面对数百万个文档向量时更是如此。VectorChord 正面攻克了这一难题:
-
原生多向量支持: 从底层架构设计上便支持在 Postgres 内部高效处理多向量数据。
-
深度优化的 MaxSim: 借鉴 WARP 论文的思想,VectorChord 采用动态相似度插补(Dynamic Similarity Imputation)等技术大幅加速 MaxSim 计算,使大规模视觉文档检索成为可能。
-
支持混合检索: 除了多向量检索外,它还支持稠密向量、稀疏向量及混合检索(欢迎参阅我们的往期博文!)。
-
可扩展且磁盘友好: 专为高性能检索而设计,无需消耗高昂的内存资源。
简而言之,VectorChord 将 PostgreSQL 打造成了一个能够轻松驾驭 ColQwen2 或 ColPali 等模型所需高级向量检索技术的强大引擎。
教程:构建您的免 OCR RAG 系统
理论介绍完毕,现在让我们挽起袖子动手构建这套系统!我们将逐步完成环境配置、使用 Modal 进行可扩展的嵌入生成、在 Postgres 中通过 VectorChord 建立索引,最后对我们全新的免 OCR RAG 系统进行评估。
前置条件
在开始之前,请确保您已准备好:
-
一个安装了 VectorChord 扩展的 PostgreSQL 实例(推荐使用 Docker),或者一个 VectorChord Cloud 集群。
-
一个 Modal 账号(提供免费额度)。Modal 快速的 GPU 调配与弹性扩缩容能力非常适合嵌入生成阶段。为了使用 ColQwen2 模型高效处理海量文档,充分利用 Modal 的快速启动和 GPU 扩展特性至关重要,这将大幅缩短本地处理所需的时间。
如果您希望快速复现本教程,可以使用 tensorchord/vchord-suite 镜像来运行由 TensorChord 提供的多个扩展。
您可以运行以下命令来启动包含 VectorChord-BM25 与 VectorChord 的 Postgres 容器:
配置 Modal:
步骤 1:加载数据(使用 Modal Volume)
我们将使用 ViDoRe Benchmark 数据集。为了在可能分布式运行的 Modal 函数之间高效共享这些数据,我们将其下载到一个 Modal Volume 中。Volume 提供了持久化的共享存储,非常适合这种“一次下载,多次处理”的场景。
Modal 提供了直观的 Python API 来与其云平台交互。通过 modal.Image,您可以为 Modal App 设置基础镜像,而 function 装饰器则用于定义将在 Modal 应用中执行的函数。要将数据集下载到 Modal Volume,只需执行以下命令,Modal 便会自动构建 Docker 镜像并迅速启动容器来运行您的函数。
运行下载函数:
Modal 会在云端自动完成环境构建与脚本执行。
步骤 2:处理数据并生成嵌入(使用 Modal 与 ColQwen2)
接下来是计算最密集的环节:将文档图像转换为 ColQwen2 多向量嵌入。如果在本地处理大量文档,速度会非常慢。而 Modal 在这里大显身手:
-
便捷的 GPU 调配与自动扩缩容:在 Modal 上启动 ColQwen2 模型服务,并用它为数据集生成图像嵌入和查询嵌入。之所以选择实现 HTTP 服务而非直接调用 SDK,是为了确保在大规模嵌入生成过程中实现无缝的自动扩缩容。如果您希望将该嵌入服务部署为持久化的 Web 端点,可以直接将
ColPaliServer的modal.cls改为modal.web_server并运行modal deploy。 -
断点恢复(Recovery): 我们将处理进度保存(Checkpoint)到另一个独立的 Modal Volume 中,从而支持在任务中断后从断点处继续生成嵌入。
运行嵌入生成任务:
步骤 3:在 VectorChord 中创建索引(使用 Vechord SDK)
当嵌入向量生成完毕并保存在 Modal Volume 中后,我们首先需要将其下载到本地:
接下来,我们将使用 vechord SDK 将这些嵌入向量加载到 PostgreSQL 数据库中,并创建所需的多向量索引。vechord 提供了一种符合 Python 习惯、类似 ORM 的方式来与 Postgres 中的 VectorChord 进行交互。
%[https://github.com/tensorchord/vechord]
运行索引构建脚本,vechord 会自动完成建表、建索引以及数据插入操作。
步骤 4:评估——效果如何?
最后一步至关重要:评估检索性能。这套免 OCR 系统能否提供准确的检索结果?速度是否足够快?我们将使用 vechord 对已建索引的数据运行查询,并重点考察 NDCG@10 和 Recall@10 指标。同时,我们还将测试 VectorChord 的 WARP 优化(用于加速 MaxSim 计算)所带来的性能影响。在本教程中,我们将使用 vidore/arxivqa_test_subsampled 数据集作为评估查询,数据示例如下图所示:
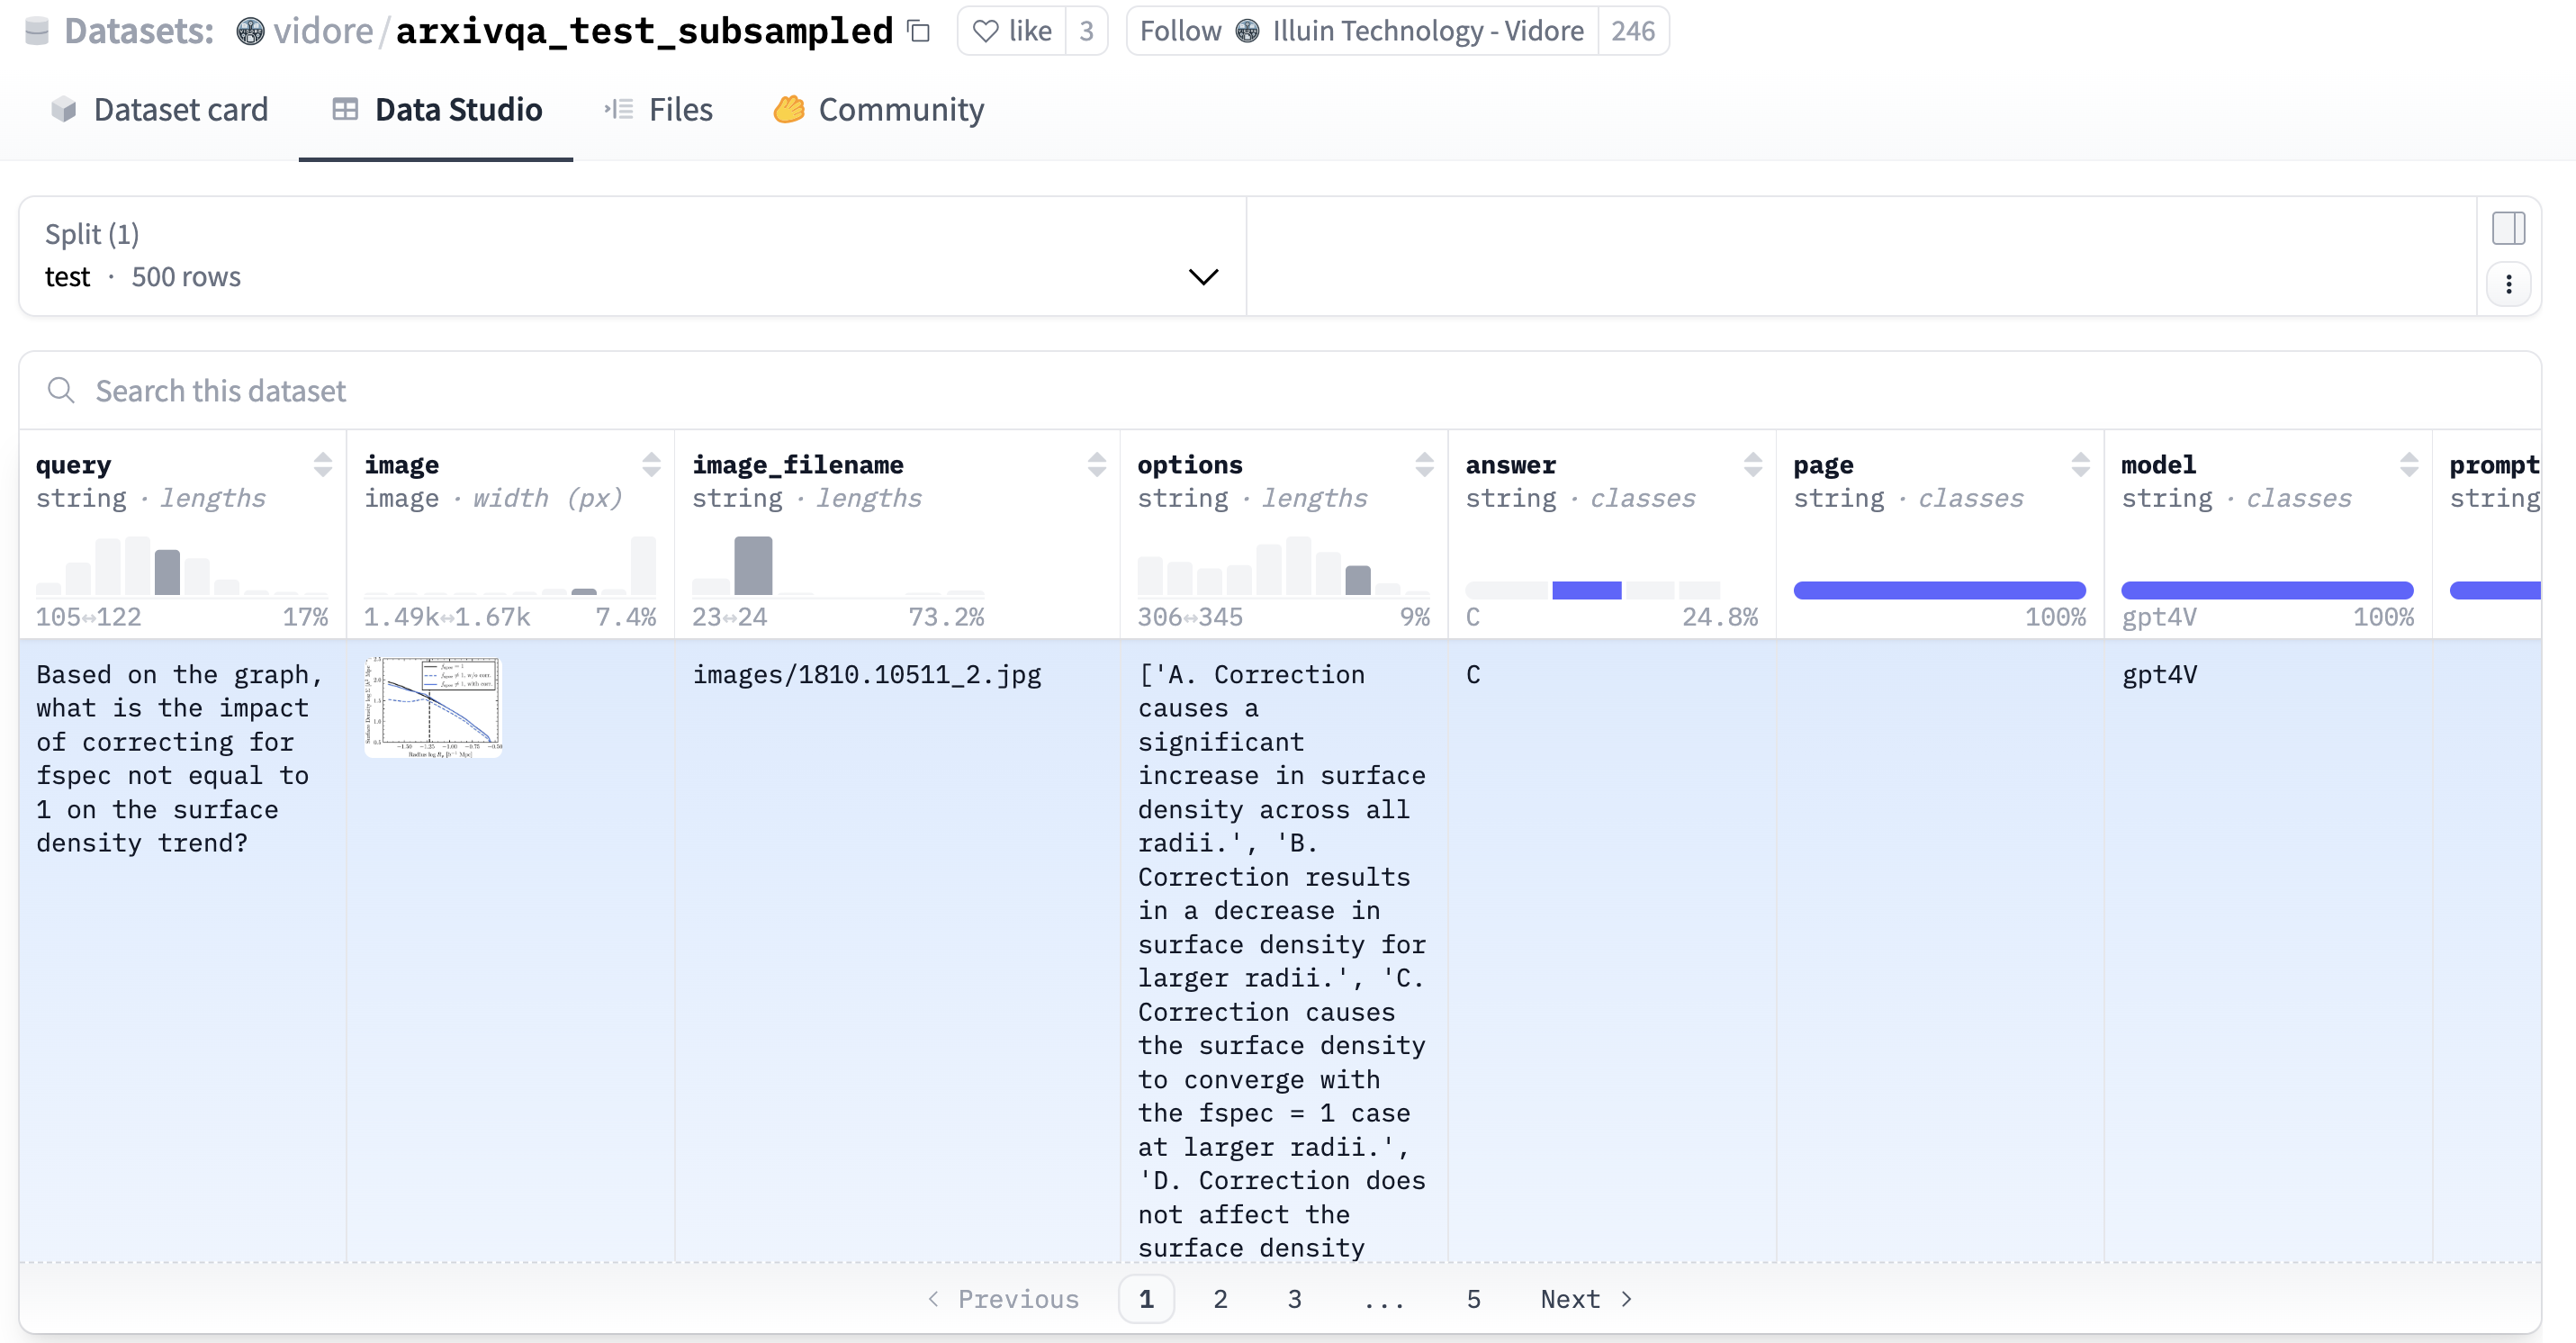
运行评估脚本后,我们得到了令人印象深刻的结果:
结果分析:
-
极高的基线准确率: 首先来看未启用 WARP 优化时的基线表现。系统取得了 0.8615 的优异 NDCG@10 和 0.92 的 Recall@10。这证实了 ColQwen2 嵌入结合 VectorChord 精确 MaxSim 检索的核心有效性——即使不启用速度优化,也能在视觉文档检索任务上取得业界领先的效果。
-
WARP 带来的显著加速: 接下来观察启用 VectorChord WARP 优化后的效果。总执行时间从 810 秒骤降至仅需 41 秒!这意味着在评估查询集上实现了高达 约 18.7 倍的加速。这充分证明了 WARP 在加速 ColQwen2 等晚期交互模型所需的计算密集型 MaxSim 运算方面的强大能力。
-
微乎其微的精度折衷: 令人赞叹的是,如此巨大的速度提升仅以极小的检索精度下降为代价。NDCG@10 仅微降至 0.8353(差距不到 0.03),而 Recall@10 仅轻微下降至 0.90(差距仅为 0.02)。
总结:在 Postgres 中让视觉 RAG 更简单
在本教程中,我们通过结合 ColQwen2 的视觉理解能力、PostgreSQL 中 VectorChord 的可扩展多向量检索能力,以及 Modal 的高效 GPU 处理能力,成功构建了一套高性能的免 OCR RAG 系统。我们看到了这一技术栈如何让我们能够直接基于视觉内容检索文档,从而绕过传统 OCR 流水线的重重陷阱。
将这一视觉维度直接无缝集成到 Postgres 内部的 RAG 系统中,为处理富含视觉信息的文档应用(如科研论文、发票单据、产品手册、历史档案等)打开了令人振奋的全新可能。
准备好亲自尝试了吗?
-
深入了解 VectorChord: 查阅 VectorChord 文档 或体验省心的托管服务 VectorChord Cloud。
-
动手实验: 尝试接入不同的视觉语言模型(VLM)或数据集。
-
分享您的想法: 欢迎与我们交流您的使用体验或任何问题!
这一方案向着更简洁、更稳健且具备视觉感知能力的文档检索系统迈出了重要一步。
参考资料
4 - 基准测试
4.1 - 价格基准测试
使用 VectorChord,您可以在单台机器上对 1 亿条 768 维向量执行 Top-10 查询,在保持 0.95 召回率(Precision/Recall)的同时实现 131 的 QPS,而整套配置的月度成本仅为 250 美元。如果您对我们的技术实现细节感兴趣,请参阅我们的博文《VectorChord:在 PostgreSQL 中仅需 1 美元存储 400k 向量》。
这意味着您只需花费 1 美元即可存储 400k(40 万)条向量,从而实现显著的成本节约:在同等价格下,可存储的向量数量是 Pinecone(存储优化型实例)的 6 倍,是 pgvector/pgvecto.rs 的 26 倍。
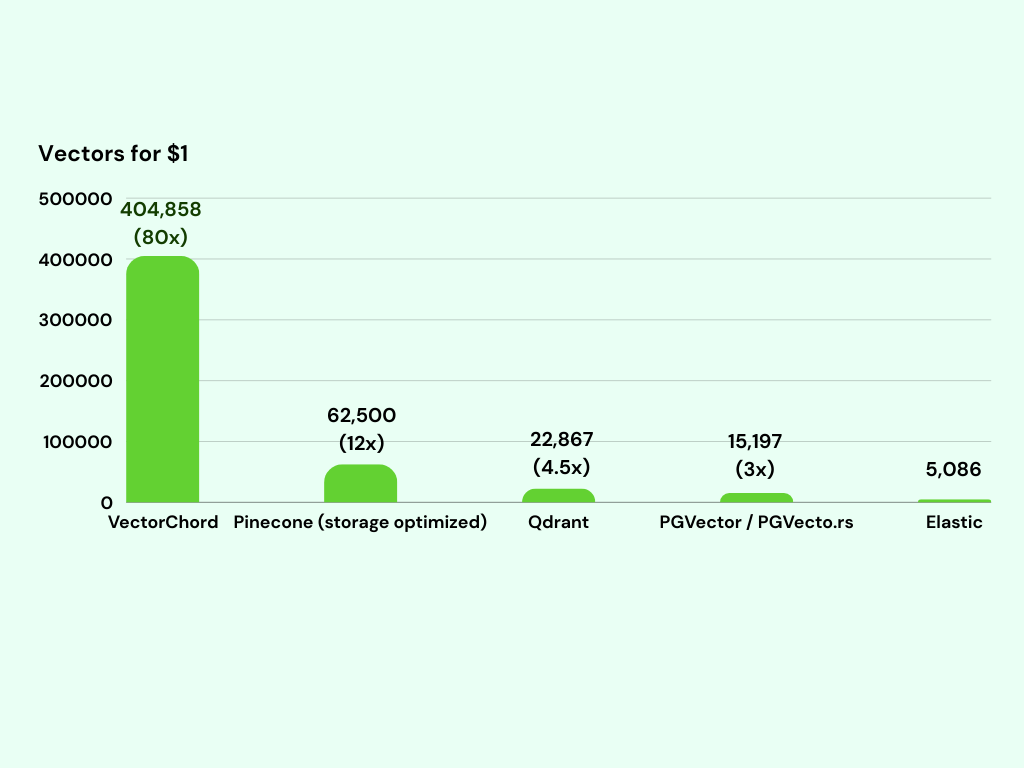
在基于 MyScale 基准测试数据的向量存储月度成本对比中,下图清晰地展示了 VectorChord 极具竞争力的性价比——存储 1 亿条向量的月均成本仅需 247 美元。相比之下,尽管 Pinecone 采用了优化型存储,其月成本仍高达 1,600 美元;Qdrant 的月成本为 4,374 美元;而 pgvector/pgvecto.rs 的成本则更高,达到每月 6,580 美元。
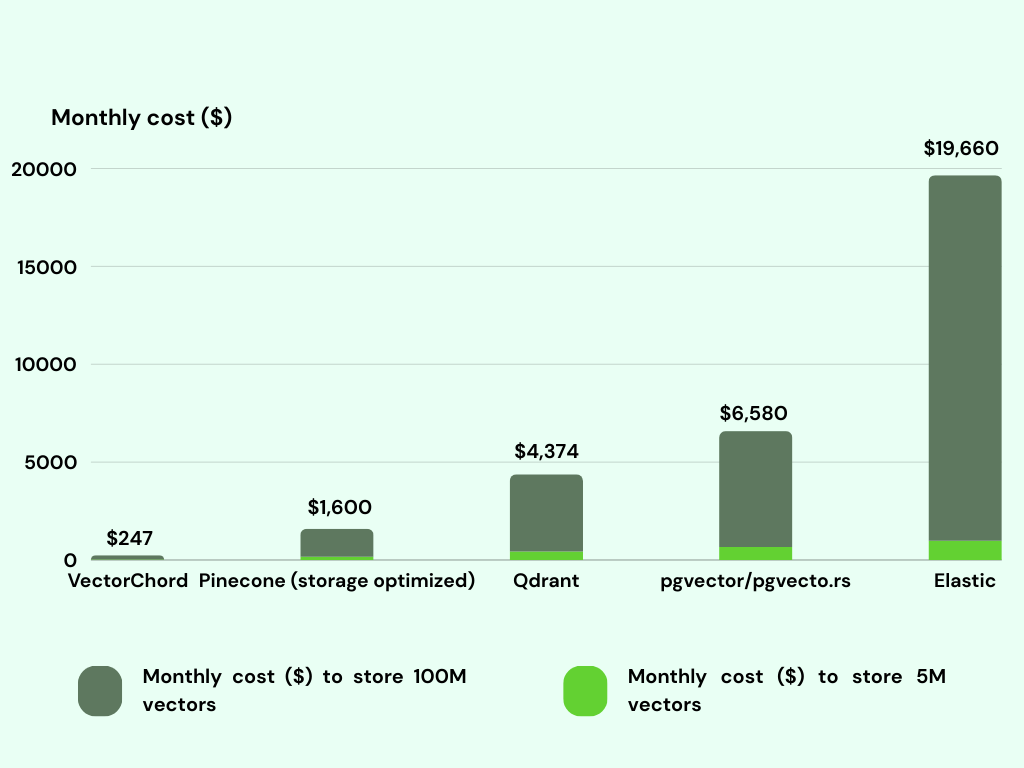
上述价格基准测试于 2024 年 12 月 5 日执行。我们正在持续提升性能并优化成本。例如,VectorChord 0.2 在前代版本的基础上将索引体积缩减了 30%,并将索引构建速度提升了 50%。如果您想了解最新的基准测试数据,欢迎通过 Discord 联系我们。
4.2 - 性能基准测试
本文展示了我们将 VectorChord 实现与其他主流向量数据库进行全面对比的基准测试结果,重点考察 QPS(每秒查询数)与可扩展性。如果您对我们的技术实现细节感兴趣,请参阅我们的博文《VectorChord:在 PostgreSQL 中仅需 1 美元存储 400k 向量》。
QPS
LAION 5M
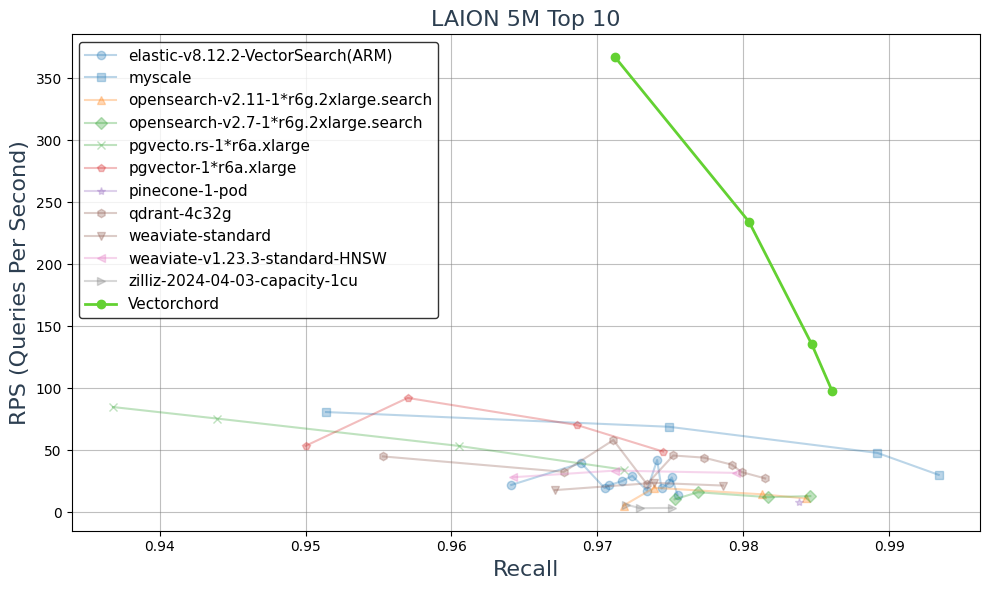
在 LAION 5M 数据集上,在达到 0.95 召回率的前提下,VectorChord 取得了比 MyScale、pgvector、Pinecone、Weaviate、Qdrant 和 Zilliz(Milvus)等各类向量数据库高出 3 倍以上的 QPS。
i4i.xlarge 上的 LAION 100M
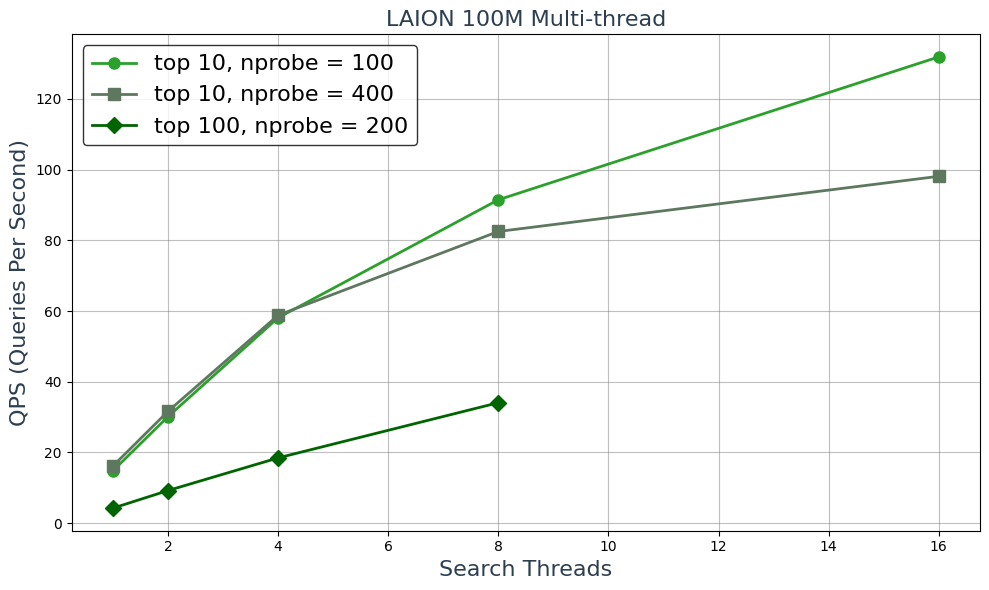
该测试环境配置为 4 核 CPU、32 GB 内存,并使用 937 GB 的 SSD 存储来容纳 1 亿条向量。在单线程查询下,我们在 Top-10 召回率达到 0.95 时实现了 16.2 的 QPS,在 Top-100 召回率达到 0.95 时实现了 4.3 的 QPS。这一表现令人印象深刻。
可扩展性
如果您对 VectorChord 的水平扩展能力感兴趣,请参阅我们的博文《使用 VectorChord 在 PostgreSQL 中实现 10,000 QPS 的向量检索》。
LAION 100M 与 LAION 5M
| 数据集 | 达到 10,000+ QPS 的最低硬件配置 | vCPU 数量 | 预估月度成本 |
|---|---|---|---|
| LAION-5m | r7i.xlarge × 7 | 4 × 7 = 28 vcpu | $0.2646 × 7 × 720 = $1334 |
| LAION-100m | r7i.16xlarge × 2 | 64 × 2 = 128 vcpu | $4.2336 × 2 × 720 = $6096 |
上述价格基准测试于 2024 年 12 月 5 日执行。我们正在持续提升性能并优化成本。例如,VectorChord 0.2 在前代版本的基础上将索引体积缩减了 30%,并将索引构建速度提升了 50%。如果您想了解最新的基准测试数据,欢迎通过 Discord 联系我们。
4.3 - 与 pgvector 的基准测试对比
在本节中,我们将 VectorChord 与提供向量相似性检索能力的 PostgreSQL 扩展 pgvector 进行对比。我们将重点关注四个核心指标:QPS(每秒查询数)、Recall@100(Top-100 召回率)、索引构建时间(Index Building Time)以及数据插入时间(Insertion Time)。如果您对我们的实现细节感兴趣,请参阅我们的博文《PostgreSQL 上的向量检索:内存与磁盘方案的对比分析》。
QPS 与召回率
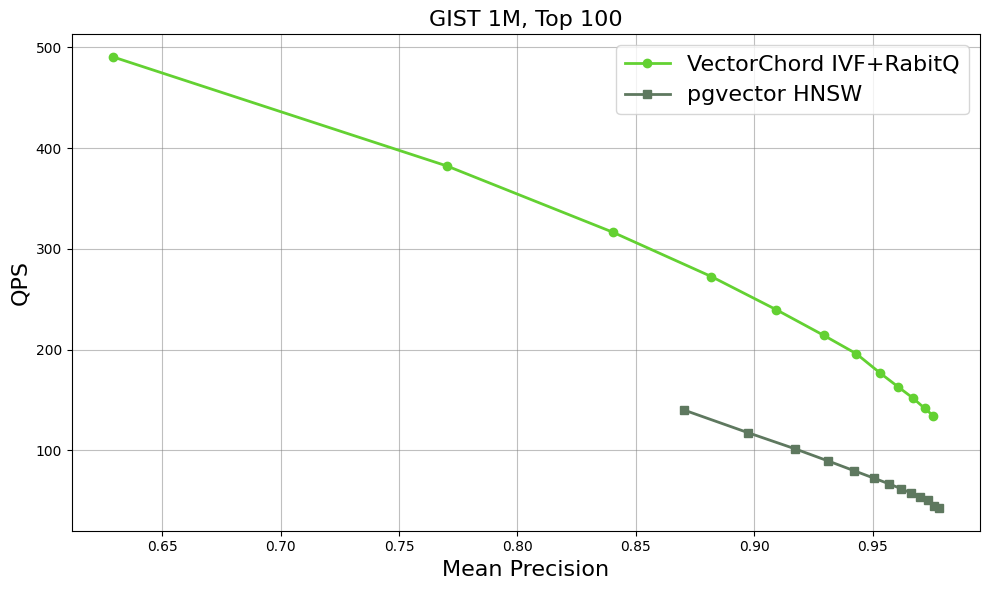
上方展示了在 GIST 数据集(包含 100 万条 960 维向量)上的初步基准测试结果。在相同的召回率水平下,VectorChord 的 QPS 可达 pgvector 的两倍。更多详情将在基准测试章节中展开说明。
索引构建时间、插入时间与查询完成时间
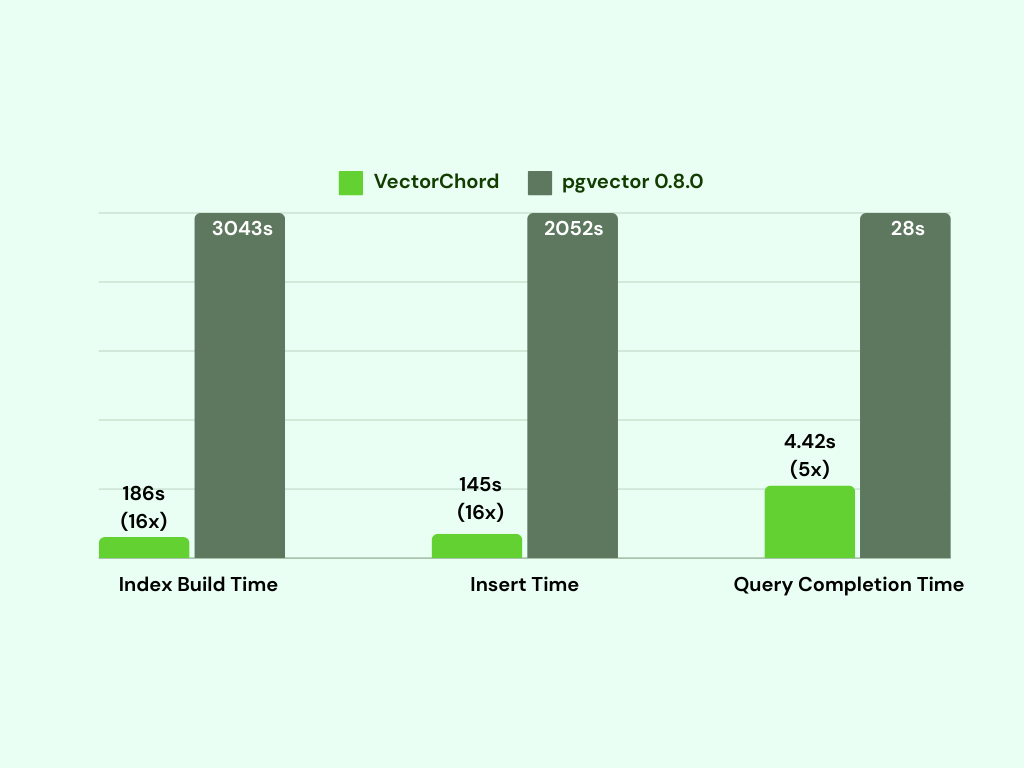
通过利用独立的机器执行 KMeans 聚类,VectorChord 仅需 186 秒即可完成索引构建,速度比 pgvector 快 16 倍。此外,其数据插入速度也比 pgvector 快 14 倍。众所周知,构建索引是向量数据库中资源消耗最密集的环节,需要大量的计算资源,并会显著推高对 CPU 和内存的需求。通过利用算力更强的机器在外部完成索引构建,再将其导入至小规格机器中提供查询服务,在单台机器上支撑数十亿级向量的检索将成为可能。
4.4 - 与 Elasticsearch 的基准测试对比
本文展示了我们将 VectorChord-BM25 实现与 Elasticsearch 进行全面对比的基准测试结果,重点考察两个核心指标:QPS(每秒查询数)与 NDCG@10(前 10 位结果的归一化折损累计增益)。如果您对我们的技术实现细节感兴趣,请参阅我们的博文《VectorChord-BM25:以比 Elasticsearch 快 3 倍的 BM25 排序彻底革新 PostgreSQL 搜索》。
RPS
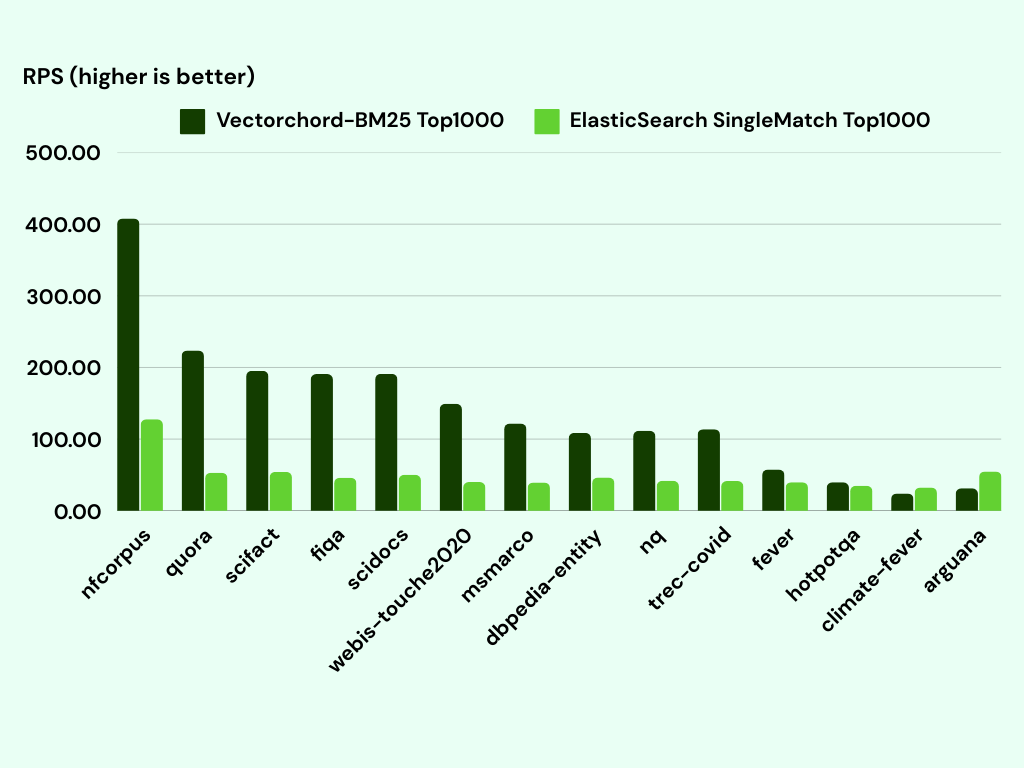
我们在来自 bm25-benchmarks 的多个数据集上,对比了我们的实现与 Elasticsearch 的 Top-1000 每秒查询数(QPS)——该指标衡量系统在为每次查询检索前 1000 条结果时每秒能够处理的查询数量。在所有测试数据集上,我们的实现平均取得了 比 Elasticsearch 高出 3 倍的 QPS,充分展现了其卓越的执行效率与可扩展性。
NDCG@10
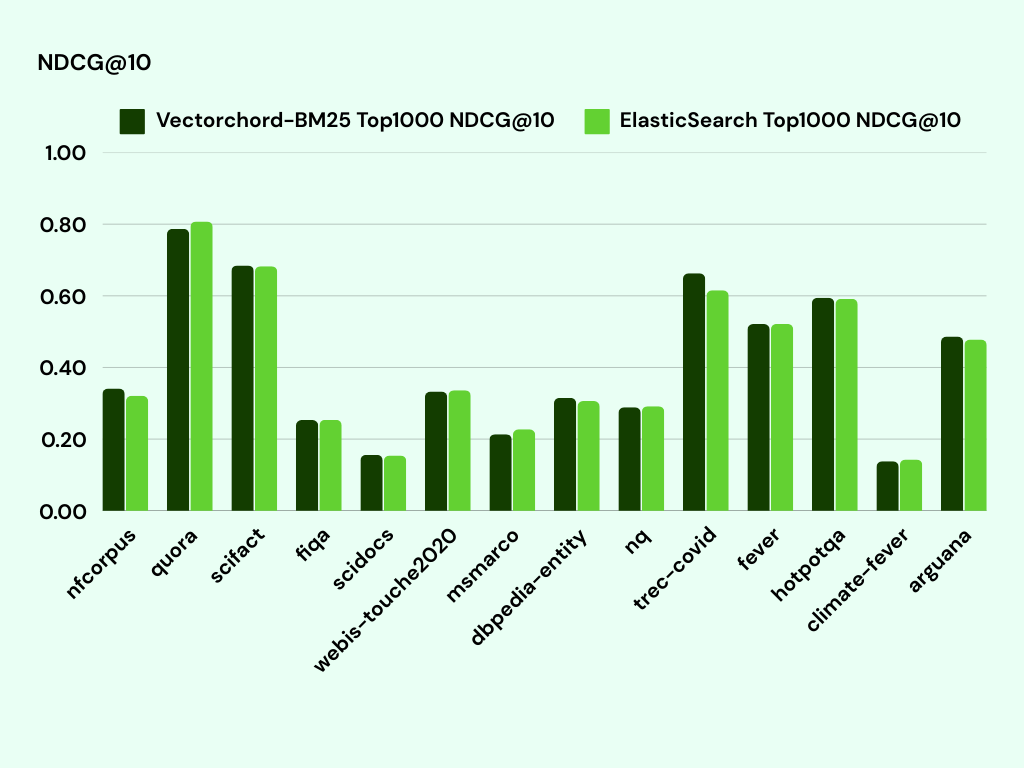
我们投入了大量精力使 VectorChord-BM25 的评分行为与 Elasticsearch 保持对齐,以确保对比的公平性与准确性。如上表所示,我们的实现在绝大多数数据集上均取得了与 Elasticsearch 相当的 NDCG@10 得分,甚至在部分数据集(如 trec-covid 和 scifact)上超越了 Elasticsearch。
4.5 - 与 pgvectorscale 的基准测试对比
在本节中,我们将 VectorChord 与提供向量相似性检索能力的 PostgreSQL 扩展 pgvectorscale 进行对比。我们将重点关注四个核心指标:QPS(每秒查询数)、Recall@10/100、索引构建时间(Index Building Time)以及数据插入时间(Insertion Time),并同时探讨内存与磁盘场景下的性能表现。如果您对我们的实现细节感兴趣,请参阅我们的博文《PostgreSQL 上的向量检索:内存与磁盘方案的对比分析》。
QPS 与召回率
内存表现
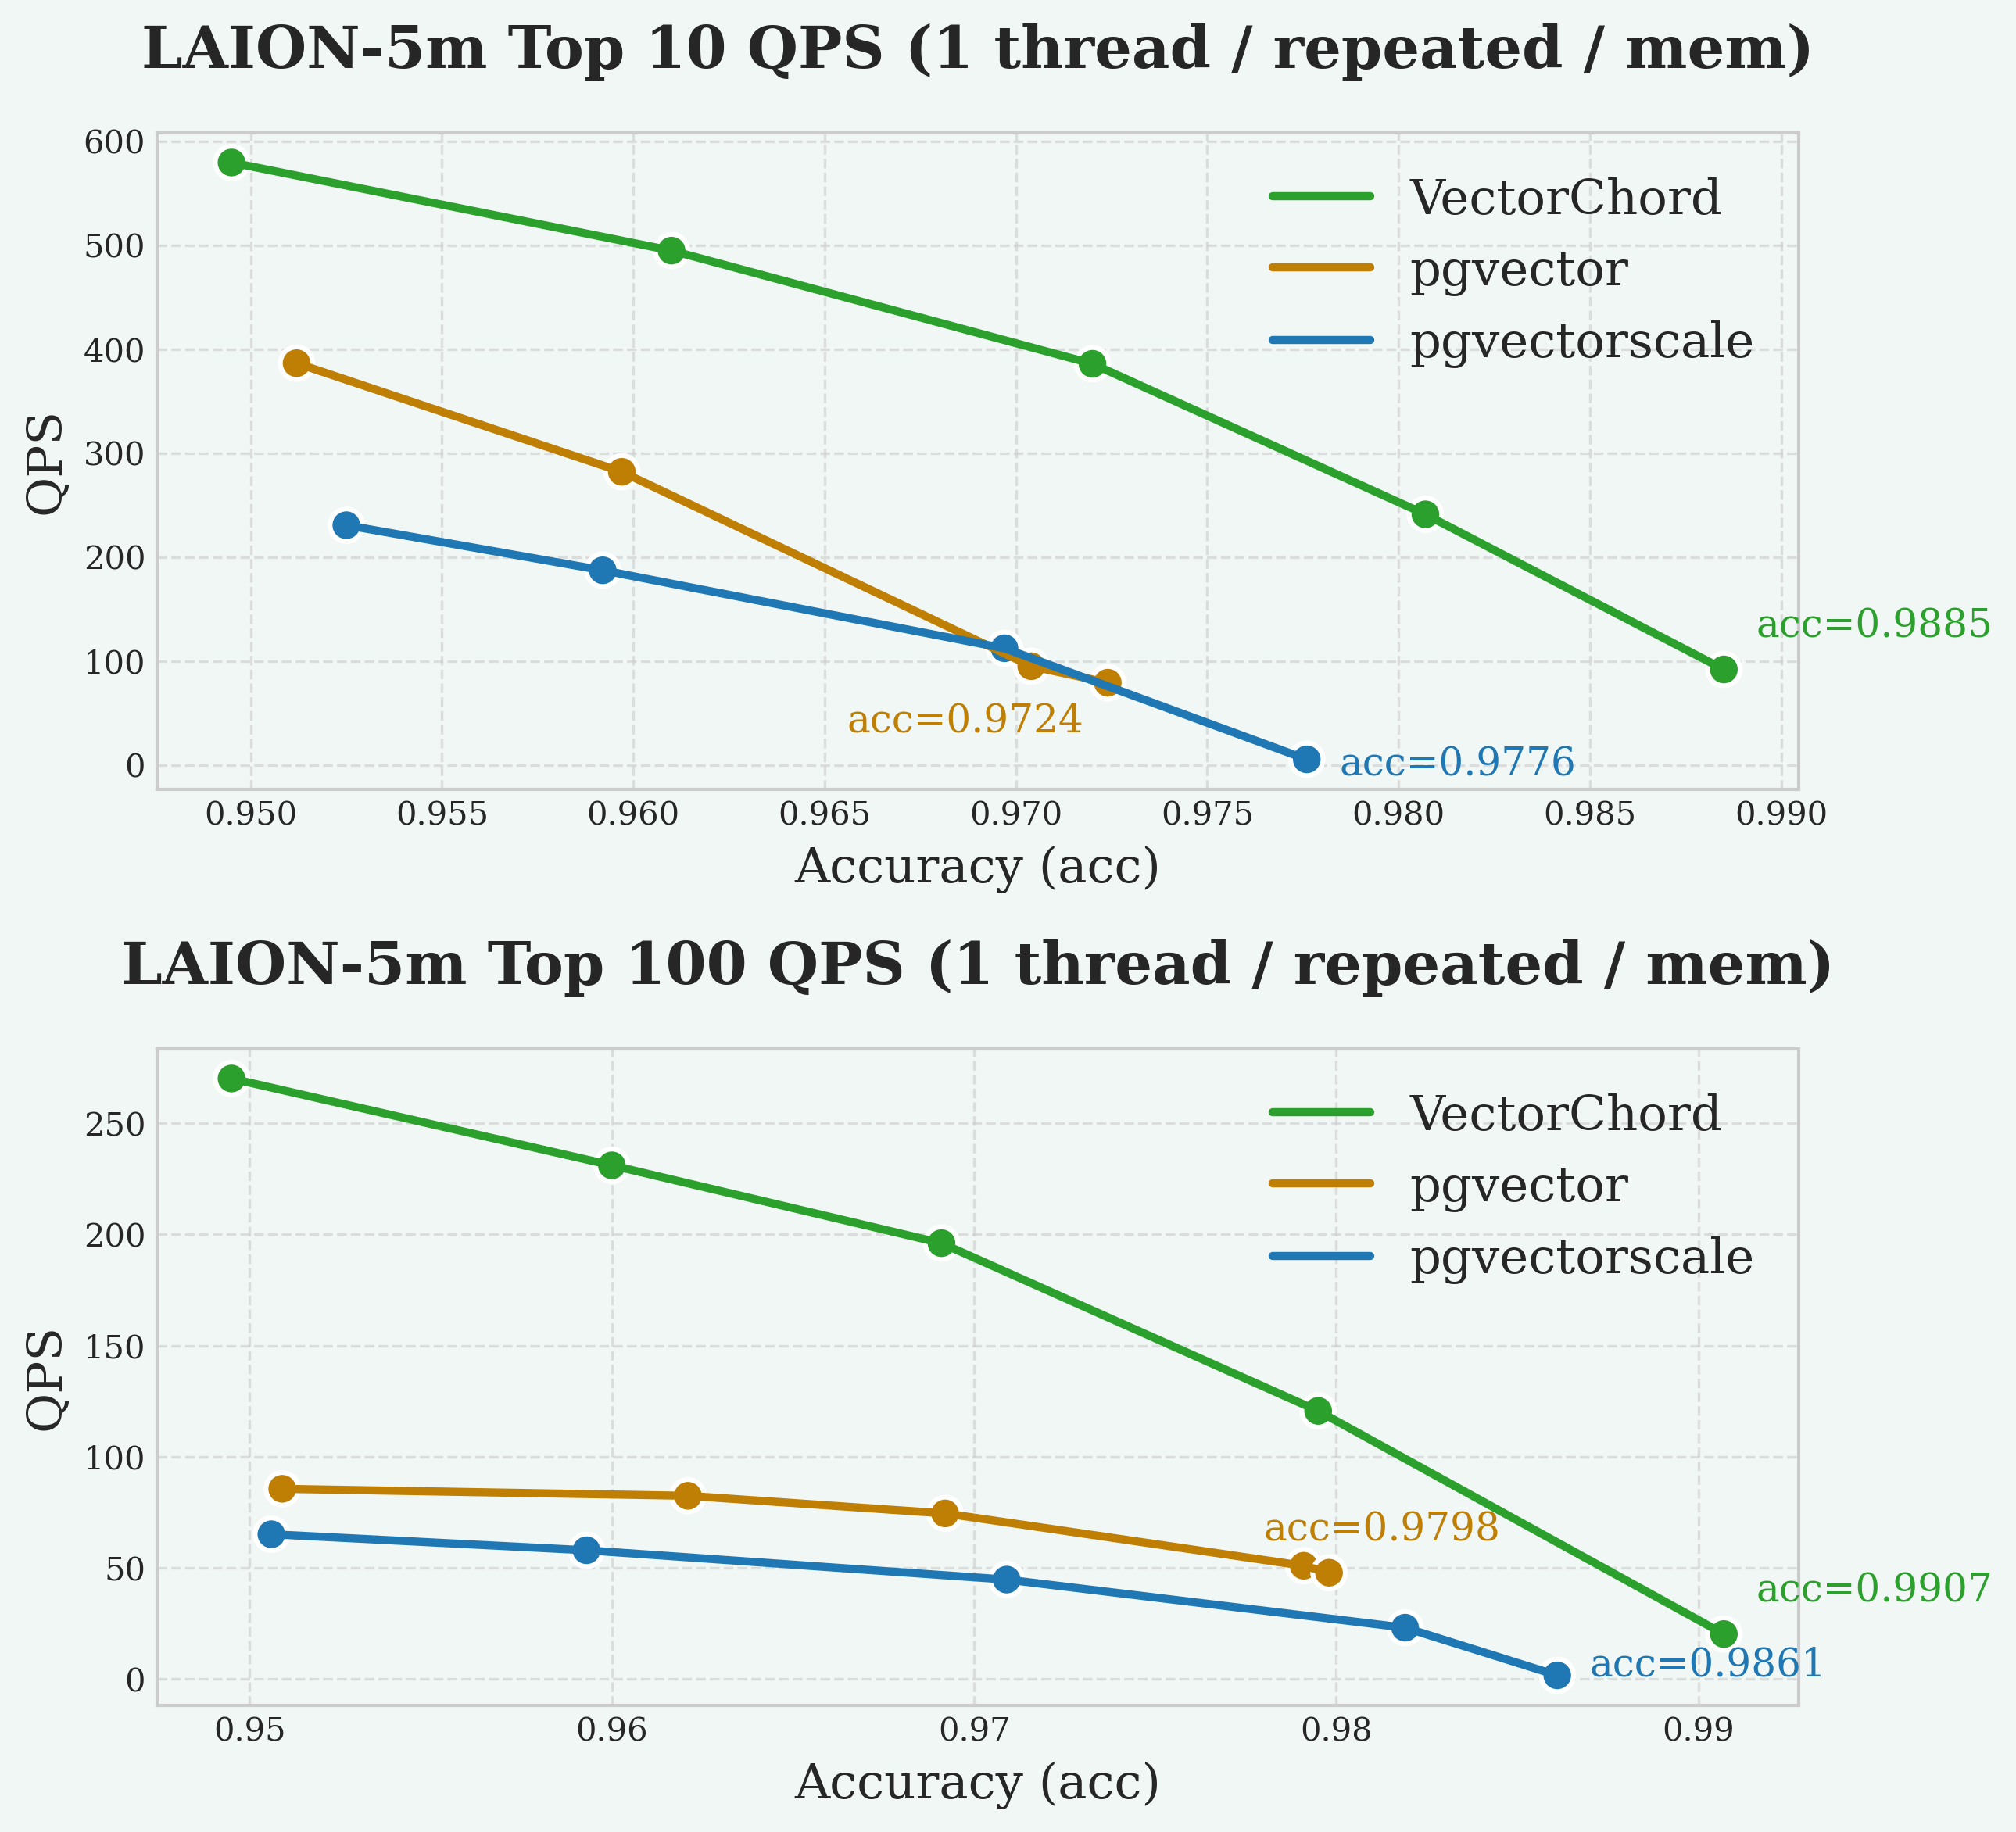
上图展示了查询速度(QPS)与检索质量(Recall@10/100)之间的权衡关系。Recall@10 衡量在前 10 个返回结果中找到真实最近邻向量的比例。通常情况下,牺牲一定的召回率可以换取更高的 QPS,反之亦然。更优秀的系统能够在相同 QPS 下实现更高的召回率,或在相同召回率水平下提供更高的 QPS。我们的目标通常是在保持高召回率目标(例如 95%)的前提下最大化 QPS。
磁盘表现
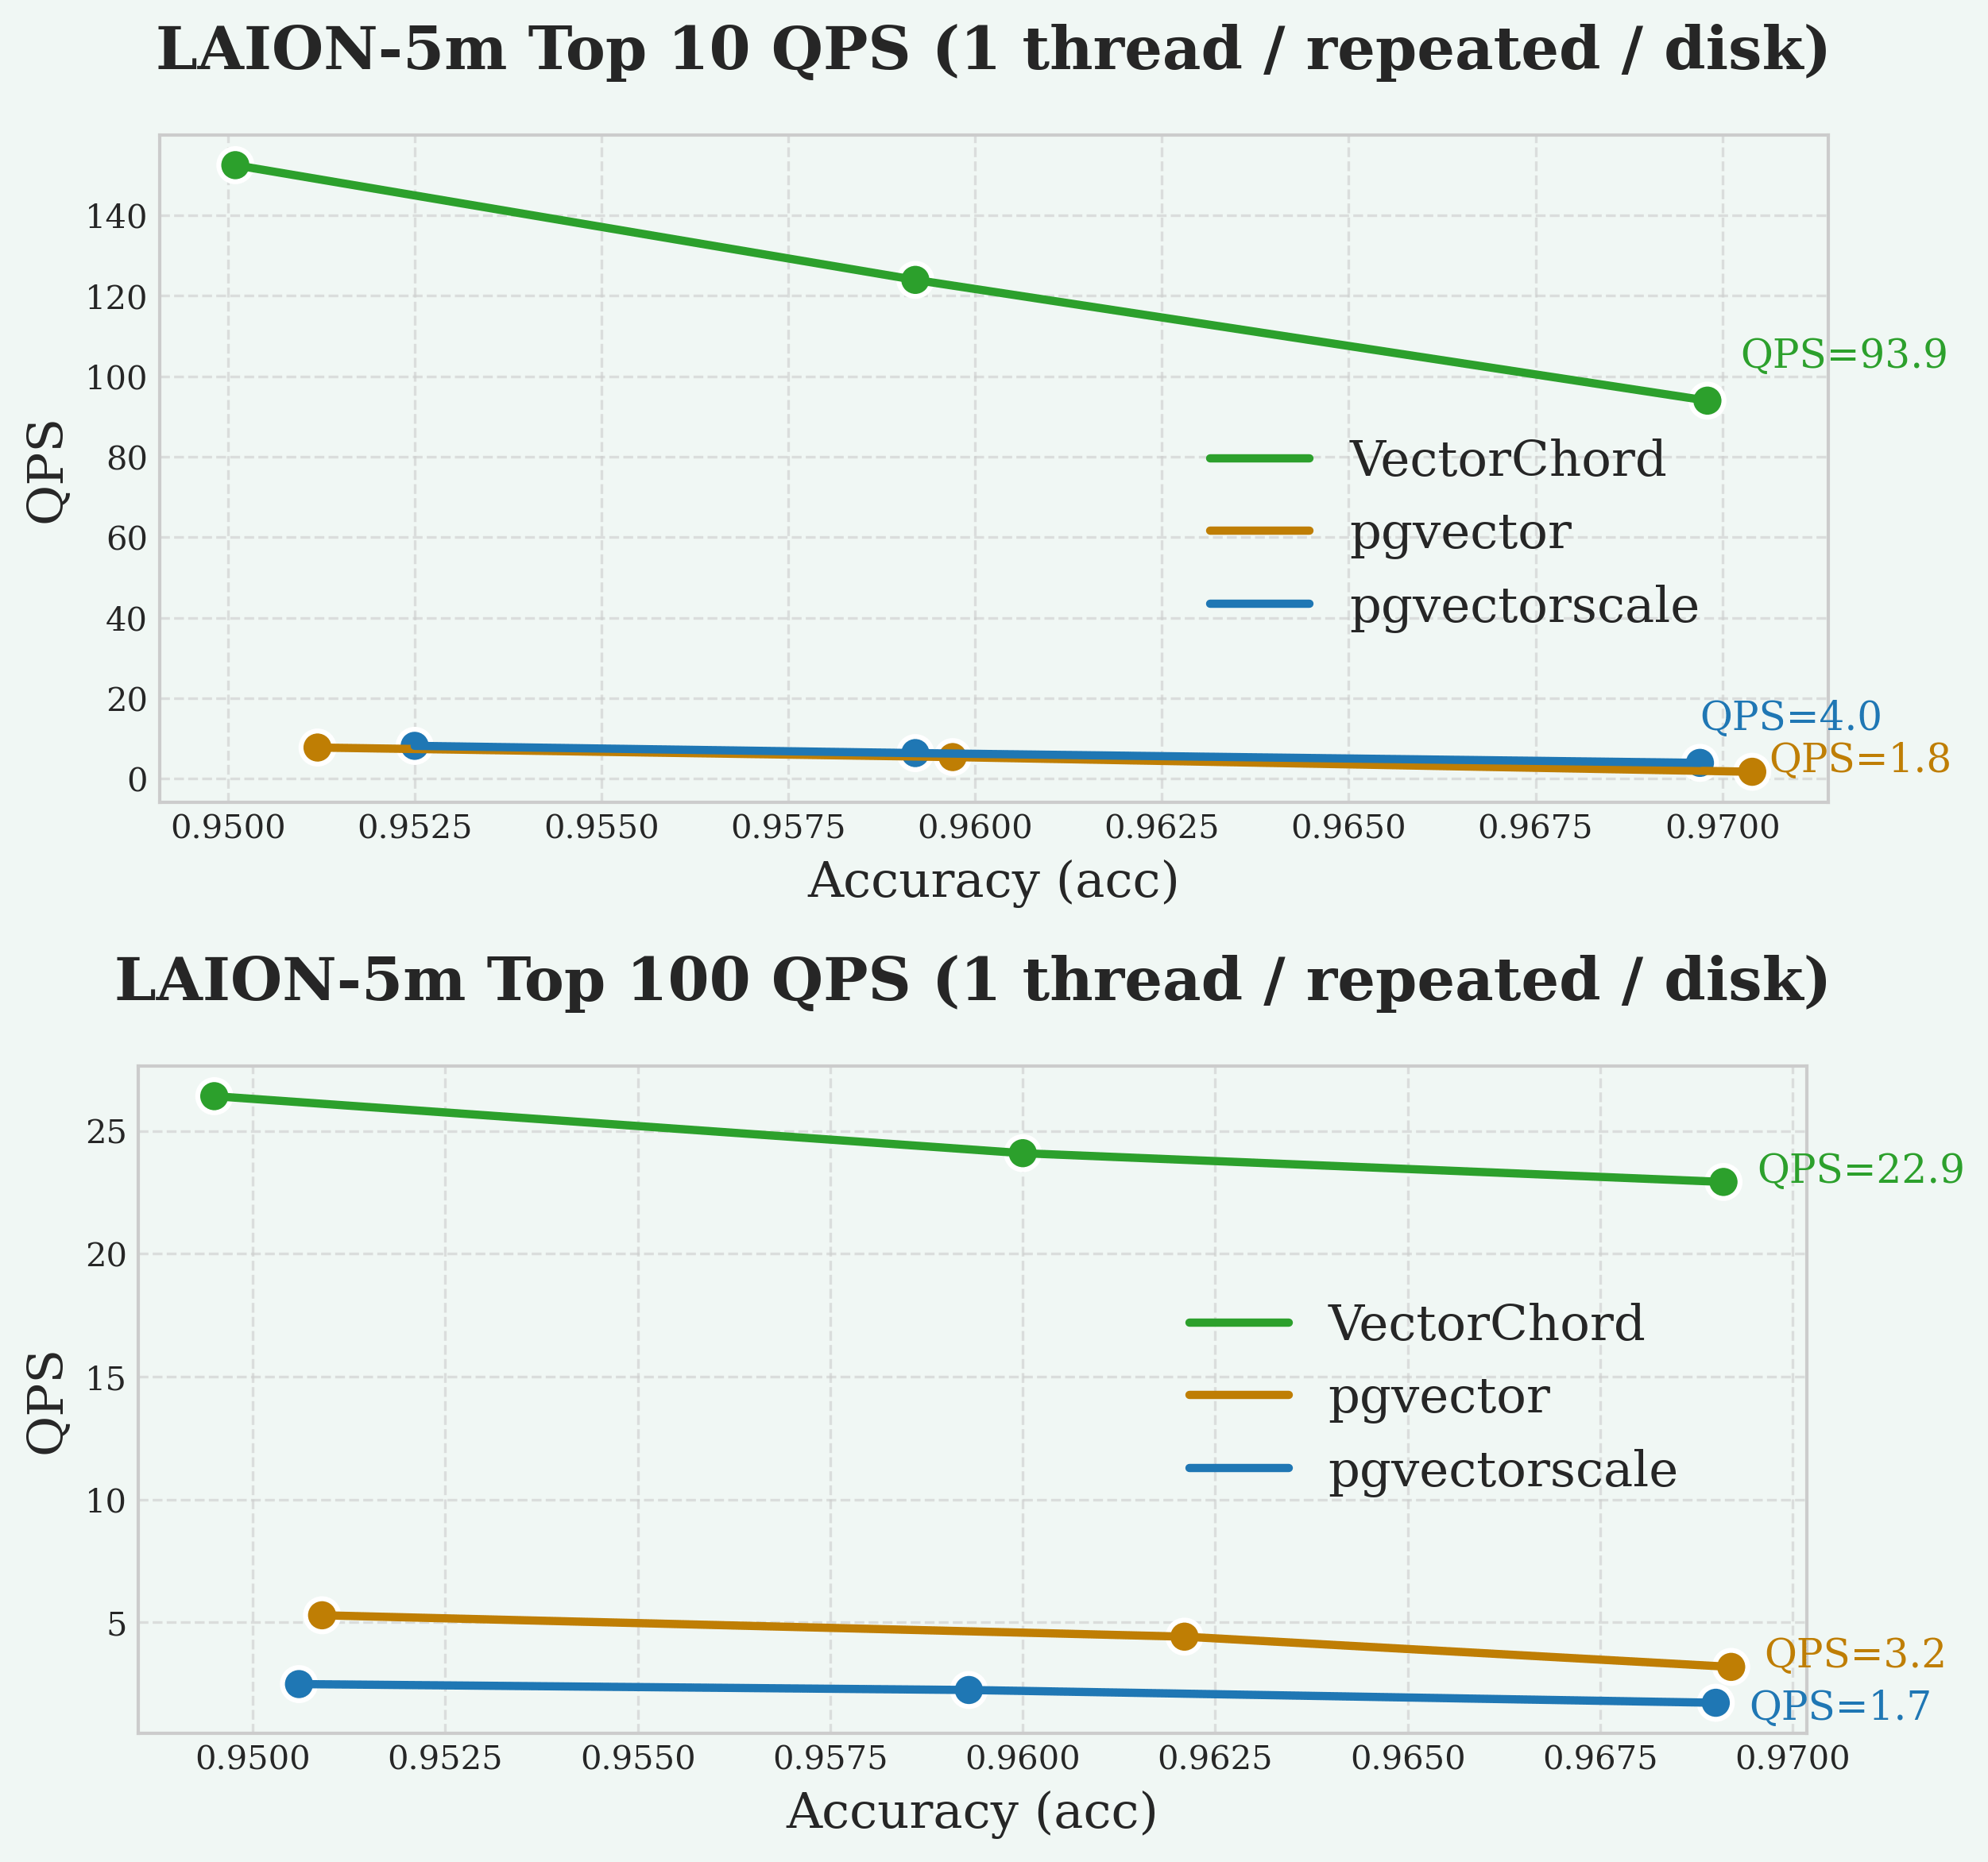
一如既往,在高召回率区间(例如 Recall@10 > 95%),VectorChord 始终能够取得高于其他扩展的 QPS,而 pgvector 与 pgvectorscale 的 QPS 表现则较为接近,位列其后。
索引构建
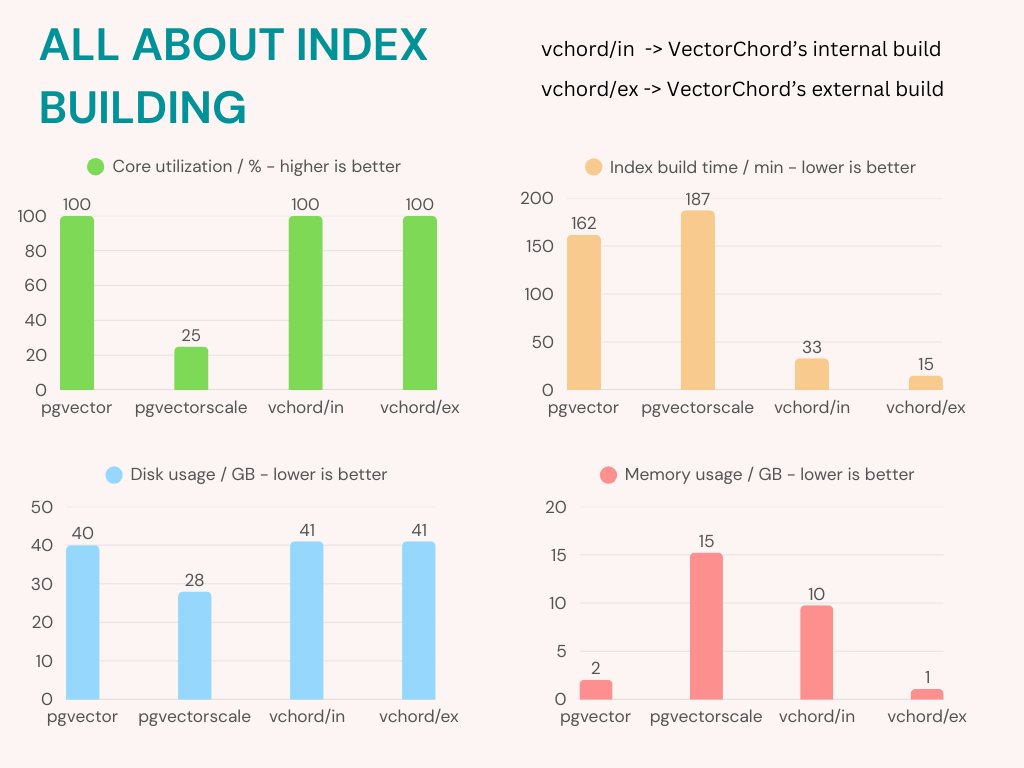
与 pgvectorscale 相比,VectorChord 能够更充分地利用 CPU 资源、减少内存占用,并大幅缩短索引构建时间。
数据插入时间
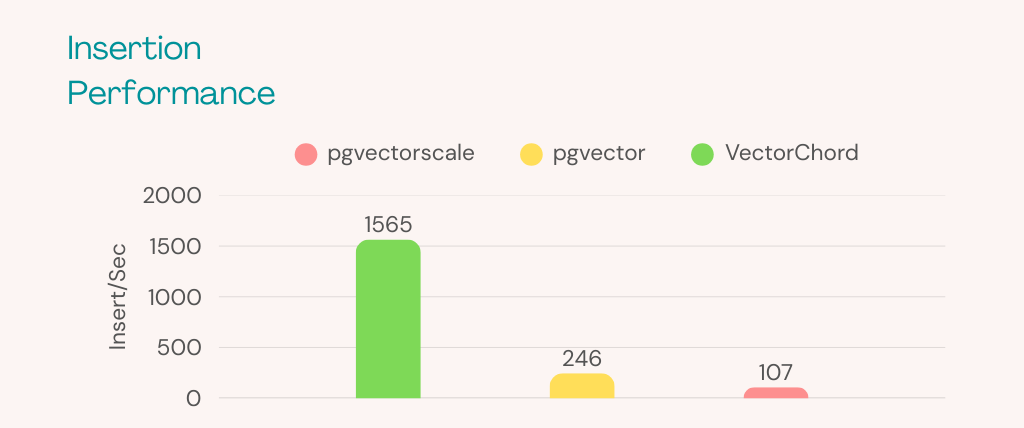
如图所示,在数据插入性能方面,VectorChord (1565 次插入/秒) 的表现远超 pgvector (246 次插入/秒) 和 pgvectorscale (107 次插入/秒)。对于大多数工作负载而言,100 次插入/秒已经足够;但如果您在生产环境中需要持续高频地写入大量向量(例如达到 500 次插入/秒),其他扩展的写入瓶颈就会成为一个棘手的问题。
5 - 运维管理
5.1 - 迁移指南
outline: [2,3]
VectorChord 迁移概览
从 PGVecto.rs 迁移
VectorChord 的绝大多数向量类型均由 pgvector 提供支持。
因此,从 PGVecto.rs 迁移到 VectorChord 的过程,基本上就是从 pgvector 迁移到 PGVecto.rs 的逆向操作。
我们提供了专用的迁移镜像 modelzai/pgvectors-vchord,用于支持在 pgvecto.rs 与 VectorChord 之间进行双向迁移。
前置条件
假设您已经拥有包含向量数据的表,并且安装了 PGVecto.rs 扩展。一个简单的示例如下:
此外,表中还插入了一些数据行,如下所示:
在大多数情况下,表上还会建有一个或多个向量索引:
这是使用 PGVecto.rs 时的典型场景。如果满足以下条件,即可开始执行迁移:
- 请注意,您的
pgvector和VectorChord扩展不能安装在vectors模式(schema)下。这意味着您可以在同一个数据库中同时安装pgvector和PGVecto.rs。
迁移步骤
1. 安装 VectorChord
请按照安装说明安装 VectorChord,并确保 PostgreSQL 已加载该扩展。
上述命令会将 vectorchord 和 pgvector 安装在 public 模式下。如果您选择了其他模式,请在后续迁移命令中将 public 替换为您实际使用的模式名。
此时,VectorChord 和 PGVecto.rs 这两个扩展已同时安装在 PostgreSQL 中,但位于不同的模式下。
若要验证这一点,请在 psql 中运行 \dx。您将看到已安装以下 3 个扩展:
- 位于
vectors模式下的vectors(即PGVecto.rs) - 位于
public模式下的vector(即pgvector) - 位于
public模式下的vchord(即VectorChord)
2. 检查现有索引
对于在向量列上创建的索引,请先查询其定义并将其记录在安全的地方。 在后续恢复重建索引的阶段,您将需要用到这些信息。
3. 迁移向量列
要从 PGVecto.rs 的向量列进行迁移,第一步是在不同扩展之间转换列的数据类型。
以下列出了 VectorChord 各向量类型的转换路径:
vector(PGVecto.rs) -> real[] -> vector(pgvector)vecf16 -> vector(PGVecto.rs) -> real[] -> halfvecbvector -> vector(PGVecto.rs) -> text[] -> real[] -> bitsvector -> text -> index++ -> text -> sparsevec
对于稀疏向量类型 svector,我们需要编写一个额外的辅助函数来完成类型转换,具体请参阅附录。
列类型迁移可通过单条命令完成,且无需消耗额外内存。 但是,您需要预先删除该向量列上的现有索引。
此步骤会导致一定的停机时间,原因在于:
ALTER TABLE ALTER COLUMN会持有较长时间的ACCESS EXCLUSIVE排他锁
4. 重建索引
下一步是在转换后的 vector 列上使用 VectorChord 重新创建索引。
关于在 VectorChord 中创建索引的更多信息,请参阅构建索引。
5. 清理环境
如果不再需要 PGVecto.rs 扩展,现在您可以安全地将其移除:
附录:稀疏向量的类型转换
上文已经讨论了大多数向量类型,唯独还没有涉及稀疏向量(Sparse Vector)。它的转换比其他类型稍显复杂。假设我们有一张包含稀疏向量列的表:
稀疏向量在 PGVecto.rs 和 pgvector 之间具有不同的文本表示格式:在 PGVecto.rs 中,维度下标从 0 开始;而在 pgvector 中,维度下标从 1 开始。
例如,一个典型的稀疏向量 [-1, 0, 1, 0, 2] 的文本表示分别为:
- 在
PGVecto.rs中:{0:-1, 2:1, 4:2}/5 - 在
pgvector中:{1:-1, 3:1, 5:2}/5
因此,我们需要创建一个辅助函数,通过处理字符串将下标整体加 1:
创建该函数后,即可顺利完成稀疏向量列的迁移:
5.2 - 可扩展性
背景
高每秒查询数(QPS)的向量检索对于推荐引擎、图像识别和自然语言处理等实时应用至关重要。这类应用要求快速、高效的检索能力以即时返回结果,这对于保持用户互动体验与业务运转效率尤为关键。通过利用 PostgreSQL 进行向量检索,您不仅能够受益于其成熟稳健的关系型数据库能力和高级索引机制,还能避免额外维护一套独立专用向量数据库的运维开销。这种统一的架构在满足现代应用高性能需求的同时,大幅简化了系统集成并降低了整体复杂度。
架构设计
在多节点集群上使用 VectorChord 比在单机上部署更具挑战性。与其他分布式服务类似,一套可靠的分布式向量检索系统通常需要满足以下核心要求:
-
易用性(Usability):支持声明式配置管理
-
弹性(Elasticity):能够根据 QPS 需求自动扩缩容节点
-
负载均衡(Load Balancing):将查询请求高效地分发到不同的只读副本实例上处理
-
高可用性(High Availability):维护数据库的多个副本,并在发生故障时自动从副本恢复
-
持久性(Durability):提供安全、持久化的存储,确保数据完整性并防止故障时发生数据丢失
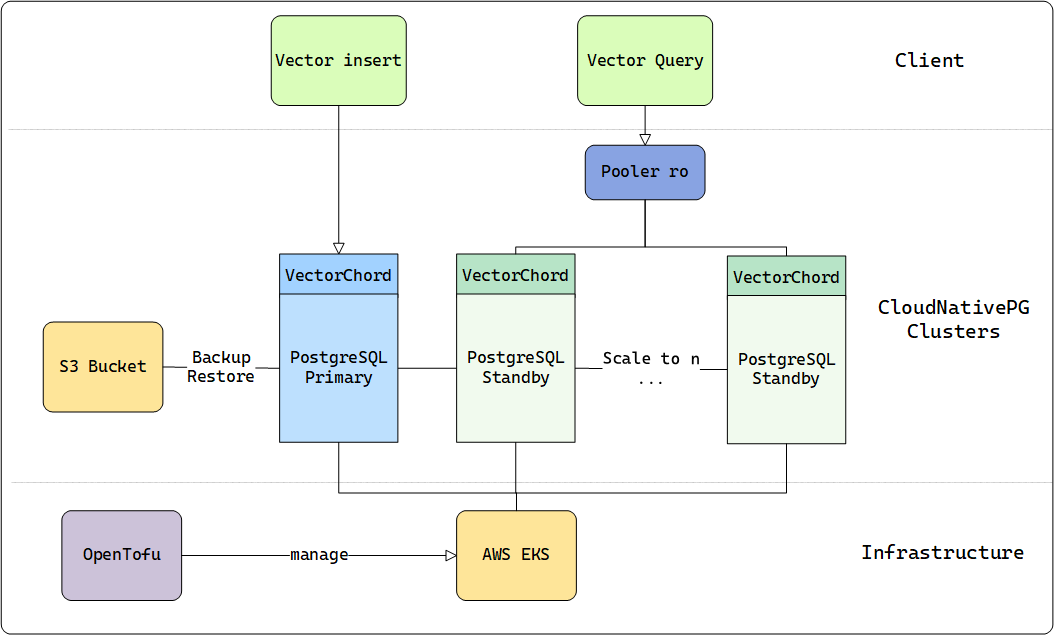
为此,我们在 AWS EKS 上结合使用 OpenTofu 和 CloudNativePG 来部署 VectorChord 服务,由它们统一管理提供上述能力的基础设施。构建示例集群的核心组件如下:
-
OpenTofu:Terraform 的开源替代方案,用于在 AWS EKS 上实现基础设施即代码(IaC)
-
CloudNativePG:基于主从(Primary/Standby)架构,管理高可用 PostgreSQL 数据库集群的全生命周期
-
PgBouncer:轻量级 PostgreSQL 连接池,由 CloudNativePG 的 Pooler 模块直接提供支持
与 DiskANN 类似,VectorChord 能够充分利用磁盘资源,在内存不足时依然保持极具竞争力的检索性能。此外,VectorChord 也可以将索引缓存在内存中,以获得极致的高并发查询吞吐。
关于 VectorChord 的更多技术细节,请参阅我们此前的博文。
为了冲击极限 QPS,我们假设内存能够完全容纳数据集,并以此为标准选择对应的 AWS 机型。
在下表中,我们列出了针对不同规模数据集能够将数据完全缓存在内存中的推荐机型:
| 数据集 | 维度 / 规模 | 机型 / 内存 |
|---|---|---|
| LAION-5m | 768 / 5,000,000 | r7i.xlarge / 32GB |
| LAION-100m | 768 / 100,000,000 | r7i.16xlarge / 512GB |
测试结果
正如我们的调优文档所述,VectorChord 接受两个关键查询参数:nprob 和 epsilon。其中,nprob 定义了查询期间需要扫描的候选聚类中心(列表)数量,而 epsilon 则作为决定是否对候选结果进行重排序的阈值。这两个参数对 QPS 和**召回率(Recall)**都有着决定性影响,允许用户在检索速度与准确性之间进行精细权衡:
-
降低
nprob会带来更高的 QPS,但召回率会有所下降。 -
降低
epsilon会带来更高但波动更大的 QPS,同时召回率也会有所下降。
当固定这两个参数时,每次实验的检索精度将保持一致,但实际 QPS 仍会随底层硬件的 CPU 和 I/O 性能而变化。为了确保召回率始终保持在 0.9 以上,我们根据此前在小规模数据集上的实验经验配置了如下参数:
| 数据集 | nprob / epsilon | 召回率(Recall) |
|---|---|---|
| LAION-5m | 20 / 1.0 | 0.9324 |
| LAION-100m | 20 / 1.0 | 0.9042 |
我们在同一个可用区内部署了一台 r7i.4xlarge 实例作为客户端,用于向 VectorChord 集群发起压测查询。测试使用了从 16 到 128 不等的并发工作线程数(Workers),以模拟真实生产场景下数据库通常承受的并发压力。这一设置使我们能够全面评估 VectorChord 在不同工作负载与并发条件下的表现。
配备 16 个 vCPU 的 r7i.4xlarge 实例能够在并发请求高达 128 时有效避免客户端侧的 CPU 争用瓶颈。
遵循通用的 PgBouncer 最佳实践,我们部署了两种类型的实例:一个主实例(Primary)专门用于数据写入,以及多个只读副本实例(Replica)专门处理只读查询负载。PgBouncer 充当负载均衡器,将查询高效地分发至后端的各个副本实例。在基准测试期间,我们将查询端点指向 read-only (ro) 连接池,而 read-write (rw) 主实例在测试过程中保持空闲。这种读写分离架构确保了读密集型工作负载下的最优资源利用率与水平扩展能力。
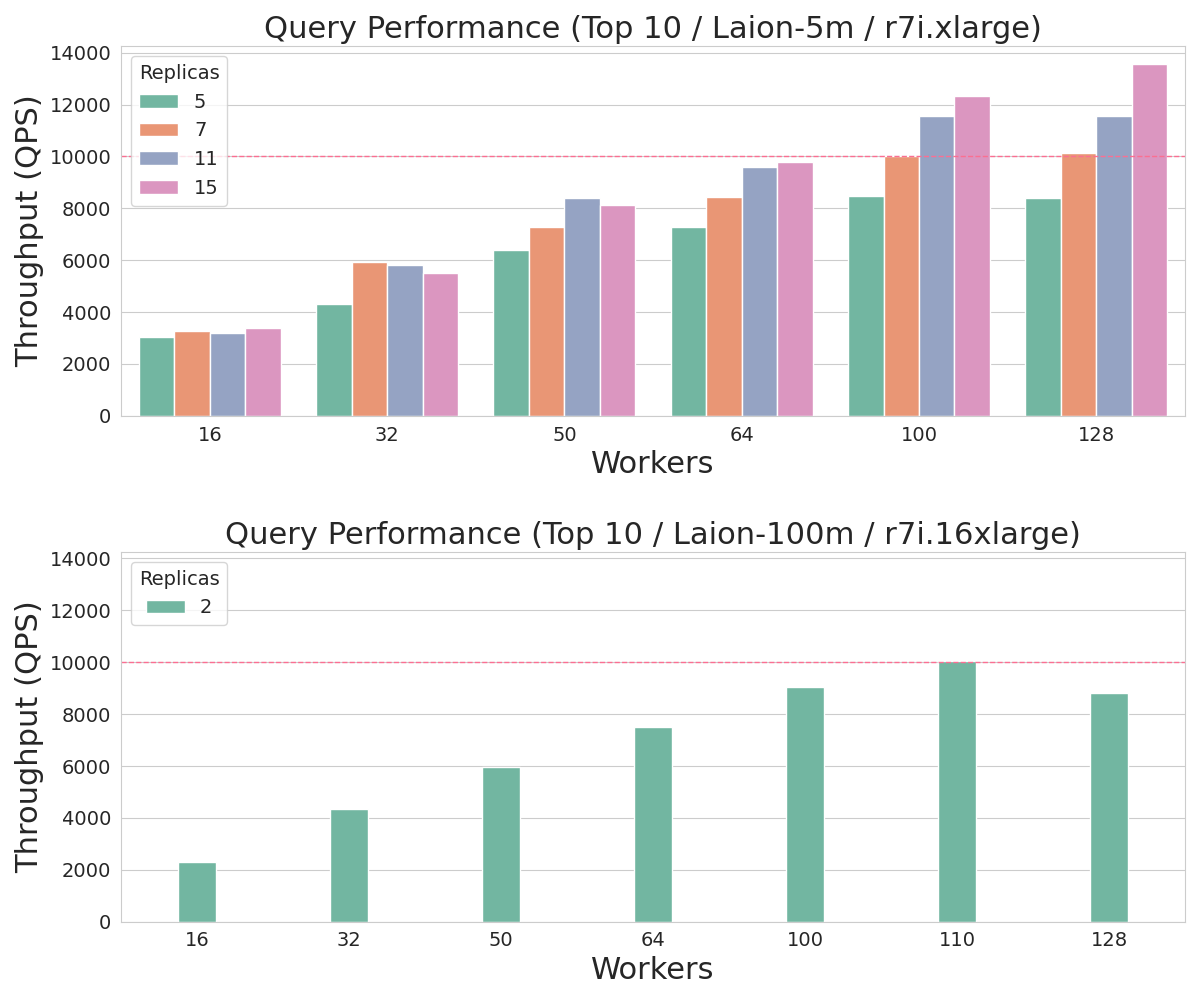
对于 500 万规模的数据集(LAION-5m),我们将副本实例数量从 5 台扩展到 15 台,成功突破了 10,000 QPS。相比之下,对于 1 亿规模的数据集(LAION-100m),仅需 2 台大规格实例便足以达到这一性能标准。下图展示了这些实验的结果,充分证明了 VectorChord 在不同数据集规模下的线性扩展能力与卓越效率。
成本分析
综上所述,如果您需要在这两类数据集上实现 10,000+ QPS 的吞吐量,所需的最低硬件成本如下:
| 数据集 | 达到 10,000+ QPS 的最低硬件配置 | vCPU 数量 | 预估月度成本 |
|---|---|---|---|
| LAION-5m | r7i.xlarge × 7 | 4 × 7 = 28 vcpu | $0.2646 × 7 × 720 = $1334 |
| LAION-100m | r7i.16xlarge × 2 | 64 × 2 = 128 vcpu | $4.2336 × 2 × 720 = $6096 |
上述成本计算未包含主实例(Primary)的开销,因为主实例可以与其他 PostgreSQL 连接池共享复用,从而进一步优化资源配置并降低整体开支。
无论是在公有云还是私有数据中心,本次实验都为您规划和扩展自己的集群以达到理想的 VectorChord 检索性能提供了可靠参考。即使在将性能置于首位的严苛场景下,VectorChord 依然展现出了极具竞争力的价格优势,是高性能向量检索需求的高性价比之选。
总结
无论您是在高性价比的 VPS 上启动初创项目,还是为追求极致性能而扩展大规模集群,VectorChord 都能为您打开无限可能。虽然本文重点探讨了 10,000 QPS 的架构实践,但这远非 VectorChord 的性能上限。
凭借强大的索引算法,VectorChord 不仅通过高效利用内存与高速 SSD 超越了 pgvector 等标准 PostgreSQL 方案,还在处理海量数据规模与高并发 QPS 需求时胜过了众多专用向量数据库。在同等成本下,它既能提供更卓越的性能,又彻底消除了维护独立向量检索系统的架构复杂度。
如果您渴望探索大规模向量检索解决方案,欢迎加入我们的 Discord 社区或发送邮件至 rh@vonng.com 与我们联系。让我们携手释放您数据的全部潜能!
5.3 - Kubernetes
如果您希望在运行于 Kubernetes 上的 PostgreSQL 中使用 vectorchord,本教程将为您提供完整的操作指引。在本教程中,我们将使用 CloudNative-PG 在 Kubernetes 中部署 PostgreSQL 集群。
环境要求
| 组件名称 | 版本要求 |
|---|---|
| helm | >= 2.4.1 |
| kubectl | >= 1.14 |
| Kubernetes | >= 1.24.0 |
| Kubernetes(使用镜像卷扩展 Image Volume Extensions) | >= 1.31.0 |
安装 CloudNative-PG
我们使用 CloudNative-PG (cnpg) 在 Kubernetes 中部署 PostgreSQL 集群。您可以通过 Helm 安装它:
内置 vectorchord 的 PostgreSQL 镜像
在官方镜像仓库中,我们已经提供了预装 vectorchord 的 Docker 镜像,您可以在 ghcr.io/tensorchord/cloudnative-vectorchord 中找到它。如果您希望构建自己的自定义镜像,可以参考以下 Dockerfile:
创建 PostgreSQL 集群
我们提供了一份用于在 Kubernetes 中创建 PostgreSQL 集群的示例 YAML 文件,您可以根据实际需求进行修改。请重点注意以下配置项:
- 设置
shared_preload_libraries以加载vchord共享库。 - 执行
CREATE EXTENSION IF NOT EXISTS vchord CASCADE;以创建vchord扩展。
您可以安装 cnpg 的 kubectl 插件来管理您的 PostgreSQL 集群。现在,我们可以检查集群的运行状态:
注意:本文仅提供最简配置示例,未包含逻辑复制、流式复制以及备份与恢复等高级配置。我们将在后续文章中专门介绍这些内容。您也可以参考 CloudNative-PG 官方文档了解更多关于
Cluster资源的配置选项。
连接到 PostgreSQL 集群
您可以使用 kubectl port-forward 转发端口并连接到 PostgreSQL 集群:
可以看到 vchord 扩展已成功安装。现在您无需额外安装步骤,即可直接按照快速开始体验各项功能。
轻量级扩展镜像
在 Kubernetes 上运行 PostgreSQL 时,扩展管理往往是最大的挑战之一。如果您想向上述一体式镜像中添加一个新扩展,通常必须重新构建镜像、备份 PostgreSQL 集群、应用包含新扩展的镜像,然后再恢复集群。这一繁琐流程源于 Kubernetes 中不可变容器(Immutable Containers)的设计理念。
得益于 Andrew Dunstan 和 Matheus Alcantara 的贡献,一项针对 PostgreSQL 18 的提案引入了一个新的配置选项(GUC)extension_control_path,允许用户为扩展控制文件指定额外的搜索目录。
与此同时,在 Kubernetes 侧,ImageVolume 特性允许我们将容器镜像作为只读且不可变的卷直接挂载到运行中的 Pod 内部。这使得打包为独立 OCI 兼容容器镜像的 PostgreSQL 扩展,能够直接挂载到 CloudNativePG 集群内的指定目录中。
基于这两项特性,我们构建了轻量级的 vectorchord 扩展镜像 vchord-scratch。
如果您希望使用镜像卷扩展(Image Volume Extensions),需要满足以下要求:
- 使用 Kubernetes 1.31.0 或更高版本(推荐使用 1.33.0),并确保已启用
ImageVolume特性门控(Feature Gate)。 - 使用 CloudNative-PG Helm Chart 0.26.0 或更高版本。
使用镜像卷扩展创建 PostgreSQL 集群
您可以使用以下示例 YAML 文件创建一个挂载 vectorchord 扩展镜像的 PostgreSQL 集群,并根据实际需求进行修改。请重点注意以下配置项:
- 设置
shared_preload_libraries以加载vchord共享库。 - 执行
CREATE EXTENSION IF NOT EXISTS vchord CASCADE;以创建vchord扩展。 - 设置
extensions字段以指定vchord-scratch扩展镜像。 - 设置
extension_control_path和dynamic_library_path,以指定扩展控制文件和共享库文件在镜像内的路径。
接下来,我们可以验证扩展是否已成功安装:
镜像 ghcr.io/cloudnative-pg/postgresql:18-system-bookworm 默认已内置了 vchord 所需的 pgvector 扩展。不过,未来的版本中该基础镜像可能会移除内置的 pgvector(但短期内我们尚未看到这一趋势)。
6 - 客户案例
6.1 - 驾驭 30 亿 PostgreSQL 向量:Earth Genome 的 Earth Index 与 VectorChord 携手守护地球
监测地球健康状况是我们这个时代最关键的挑战之一。我们的星球正面临巨大的环境压力,而要理解这些变化,需要从不间断捕获的海量卫星数据(高达 PB 级的像素)中抽丝剥茧。无论是追踪亚马逊雨林的森林砍伐、识别偏远地区的非法采矿作业,还是监测农业活动对脆弱生态系统的影响,将这些原始数据转化为可付诸行动的情报都至关重要。
Earth Genome 旗下的 Earth Index 平台正在正面攻克这一难题。如今,该平台已实现全球覆盖,利用 AI 的力量让地球上的每一寸陆地表面都变得可搜索。这不仅是一项技术壮举,更是一款旨在通过从卫星数据中提取人人可用、可操作的情报,从而赋能全球环境治理的全新工具。
在 VectorChord 团队,我们无比自豪地看到我们的 PostgreSQL 向量检索扩展在驱动这一宏伟且至关重要的使命中发挥着核心作用。
Earth Index 在做什么?将像素转化为地球洞察
想象一下,要在覆盖数百万平方公里的卫星影像中,找出某种特定类型的小规模环境破坏(例如未申报的采石场或新出现的森林砍伐斑块)。传统上,分析这类数据需要深厚的专业知识与高昂的资源投入,这使得环保组织、调查记者以及预算有限的监管机构很难在广袤偏远的地区追踪特定威胁。下方的动画展示了 Earth Index 是如何精准定位亚马逊雨林中的非法贩毒简易跑道的——这无异于在足球场上寻找一根牙签。
那么,Earth Index 是如何让全球范围内的环境特征搜索成为可能的呢?其奥秘在于一套前沿的技术方案:利用通过对比学习(Contrastive Learning)训练的 AI 基础模型及其生成的向量嵌入(Vector Embeddings)。
下面让我们一窥其创新流程:
-
全球网格切片(Tiling the Globe): Earth Index 将地球的全部陆地表面划分为超过 32 亿个相互重叠的网格切片(Tile),每个切片面积约为 10 公顷。
-
通过对比自监督学习提取“地球 DNA”: Earth Index 利用了 AI 领域的突破性进展,特别是采用自监督对比学习方法(如 DINO 目标函数)专为地球观测(EO)训练的基础模型。该基础模型(例如 SSL4EO Vision Transformer)通过区分来自同一地理位置的图像对(正样本对)和来自不同地理位置的图像对(负样本对),学习卫星影像的底层视觉语言。这一过程在多样化的全球遥感数据(如 Harmonized Landsat Sentinel-2 光学影像、Sentinel-1 雷达影像)上进行,完全无需人工显式标注“森林”或“城市”等标签。
-
生成向量嵌入: 完成预训练后,该模型即作为编码器使用。将每个网格切片的影像输入模型,即可生成一个向量嵌入——这是一种以高度压缩格式(压缩比超过 10,000 倍)捕捉该切片核心视觉与结构特征的丰富数值表示(或称“数字指纹”)。这个高维向量就像是那片土地独一无二的“地球 DNA”。
-
打造可搜索的地球: 这 32 亿条向量嵌入构成了 Earth Index 的核心。它们需要被存储在一个专门针对快速查找数值相似向量而优化的系统中。用户只需提供一个他们想要寻找的目标示例(例如在地图上点击一个已知的非法矿点或某种特定的农业基础设施),Earth Index 就能在这个庞大的数据集中搜索,找出全球范围内(或特定区域内)具有相似向量指纹的其他地点。
现实影响力:Earth Index 环保实战
这一技术底座直接转化为了理解与保护自然环境的强大工具。它赋能调查记者(如 Mongabay 和自由欧洲电台的记者)、原住民社区、环保及国际组织(如世界银行)以及科研人员,使他们能够以前所未有的便捷性与速度揭露隐蔽的环境变化、监测工业足迹并为生态保护行动收集证据。下图展示了丰塞卡湾(Gulf of Fonseca)的养虾场分布。
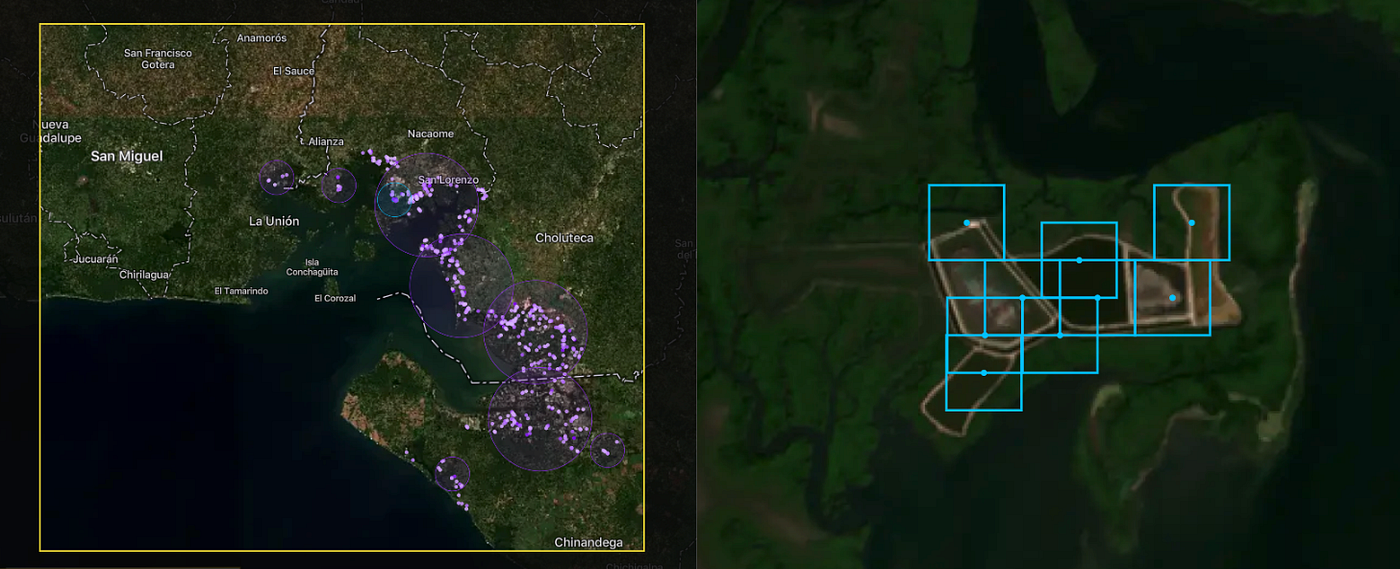
以下是 Earth Index 在实际应用中的几个典型案例:
-
打击森林砍伐与非法活动: 在与环境新闻机构 Mongabay 的合作中,Earth Index 穿透茂密的雨林冠层,成功识别出亚马逊地区隐蔽的非法贩毒简易机场。同样地,该平台还能快速定位非法采金留下的地表伤痕(例如在亚诺马米原住民领地造成严重破坏的矿坑),帮助量化问题规模并为执法行动提供指引。
-
监测资源开采: 自由欧洲电台(Radio Free Europe) 利用 Earth Index 在巴尔干半岛识别出了 1,300 多个采石场,揭露出其中约有一半缺乏合法许可证,凸显了潜在的环境破坏与违规开采问题。这一方法同样可用于监测水力压裂井场、橡胶加工厂或其他工业设施。
-
保护水质与生态系统: Earth Index 可以定位敏感水道附近的集约化畜禽养殖场以评估径流污染风险,或识别向重要红树林生态系统扩张的养虾场。
-
追踪农业扩张: 通过搜索与新开辟林地或特定作物类型相关的视觉模式,该工具能够帮助监测自然栖息地向农业用地的转化过程。
基础设施挑战:以可承受的成本检索数十亿向量
生成 32 亿条高维向量只是挑战之一;如何高效地托管并检索这些向量则是另一道巨大的门槛。Earth Index 需要一套能够满足以下要求的解决方案:
-
应对海量规模: 检索数十亿条向量需要专门的索引与查询加速能力。
-
与地理空间数据无缝集成: Earth Index 高度依赖地理空间运算(例如在特定行政边界内过滤结果,或按与河流的距离进行筛选)。这使得带有 PostGIS 扩展的 PostgreSQL 成为其核心数据库自然且不可或缺的选择。而独立的专用向量数据库往往缺乏所需的丰富地理空间特性。
-
保障查询性能: 平台需要足够快地返回结果,才能有效支撑交互式调查与监测工作。
-
严控成本: 存储和检索数十亿条向量(尤其是当纯内存索引需要消耗海量 RAM 时)对于许多组织——特别是非营利机构——而言,成本往往高得令人望而却步。
因此,Earth Index 需要一种原生运行于其选定的 PostgreSQL 环境中、具备超大规模扩展能力、性能优异且硬件成本不会超支的向量检索解决方案。
为什么 PostgreSQL 是行星级向量检索的绝佳选择
尽管市面上存在各种专用向量数据库,但 Earth Index 面临着一个核心诉求:将向量相似性检索与丰富的地理空间数据及操作无缝结合。这正是 PostgreSQL 及其扩展生态真正大放异彩的地方:
-
统一的数据平台: PostgreSQL(尤其是配合强大的 PostGIS 扩展)使 Earth Index 能够将向量嵌入与其关键的地理空间元数据(切片位置、行政边界、与河流等地物的空间邻近关系)保存在一起。这避免了分别维护独立的向量数据库与关系型/空间数据库所带来的架构复杂性及潜在的数据同步难题。
-
释放 SQL 与 PostGIS 的强大威力: Earth Index 可以在单一查询接口中,将向量相似性检索与标准 SQL 过滤条件及复杂的 PostGIS 空间查询结合起来(例如,“在该特定国家公园边界内,或者在该水系附近,查找与该示例相似的向量”)。独立的向量数据库通常缺乏如此成熟的地理空间联合查询能力。
-
成熟度与生态系统: 基于 PostgreSQL 构建意味着继承其数十年的研发积淀、享誉业界的稳定性、完善的工具链以及广泛的社区支持——这对于像 Earth Index 这样的关键任务平台而言至关重要。
然而,要高效地检索 32 亿条向量,仅靠标准的 PostgreSQL 能力是远远不够的。
为什么 Earth Index 选择 VectorChord 以兼顾性能与性价比
虽然 PostgreSQL 生态系统提供了理想的底座,但在 32 亿条向量的规模下同时实现所需的性能与可承受的成本,依然是一项严峻的挑战。Earth Index 需要一种既能提供极速查询、又不会掏空预算的解决方案。
在性能、成本与集成度之间寻找最佳平衡点并非易事。Earth Genome 首席技术官 Hutch Ingold 解释了他们的选型考量:
当我们为 32 亿条向量评估技术方案时——尽管技术演进日新月异——标准的 pgvector 在如此庞大的规模下无法满足我们的性能要求。而像 Qdrant 这样的专用向量数据库也面临困难:其全托管云服务过于昂贵,而当时在我们自己的 Kubernetes 基础设施上自建集群部署又显得不够成熟。我们还考察了各大云厂商的服务(例如 Google 的 Vertex AI Vector Search),但针对我们的数据集,其高达每月 237,000 美元的目录报价实在令人望而却步。
正是在这一背景下,VectorChord 成为了破局的关键技术:
-
超越原生 pgvector 的卓越性能: VectorChord 提供了不可或缺的速度提升——查询速度最高提升 5 倍,写入吞吐量提升 16 倍,索引构建速度加快 16 倍——有效攻克了标准 pgvector 在超大规模下的性能瓶颈。
-
基于磁盘索引的高性价比扩展: 尤为关键的是,VectorChord 经过深度优化的**磁盘索引(Disk-Based Indexing)**技术(充分利用高性价比的 SSD)直接化解了 CTO 所提到的高昂成本难题。它既避免了纯内存方案对海量 RAM 的苛刻需求,又省去了托管云向量服务高昂的月度费用,使构建 32 亿规模的向量索引在财务上切实可行。
-
原生集成与卓越扩展性: 作为一款 PostgreSQL 扩展,VectorChord 直接在他们已选定的数据库内部提供了上述所有优势,无需对现有基础设施进行改造。它专为高效扩展而构建,在轻松驾驭 Earth Index 全球监测平台所需的数十亿级向量的同时,依然保持了流畅的交互式查询性能。
VectorChord 在 Earth Index 所熟悉的强大 PostgreSQL 环境中,完美集齐了高性能、超大规模扩展能力与极佳的成本效益。
Earth Index:技术架构与部署配置
为了高效且经济地管理其行星级数据集,Earth Index 在由三台强大的 AWS EC2 i8g.16xlarge 实例组成的集群上构建了后端系统,这些实例搭载了最新的 Graviton4 ARM 处理器与 Nitro SSD。每台实例配备 512 GB 内存、64 个 vCPU 以及 15 TB 的 NVMe 存储,为密集计算与高速磁盘 I/O 奠定了坚实基础。整套环境的月度成本约为 12,000 美元,与同类托管云向量服务预估高达 237,000 美元的月费相比,节省了巨额开支,从而让该项目在经济上得以持续运转。这些实例运行着由 VectorChord 和 PostGIS 增强的 PostgreSQL,高效地同时承载了向量数据与其他应用组件。
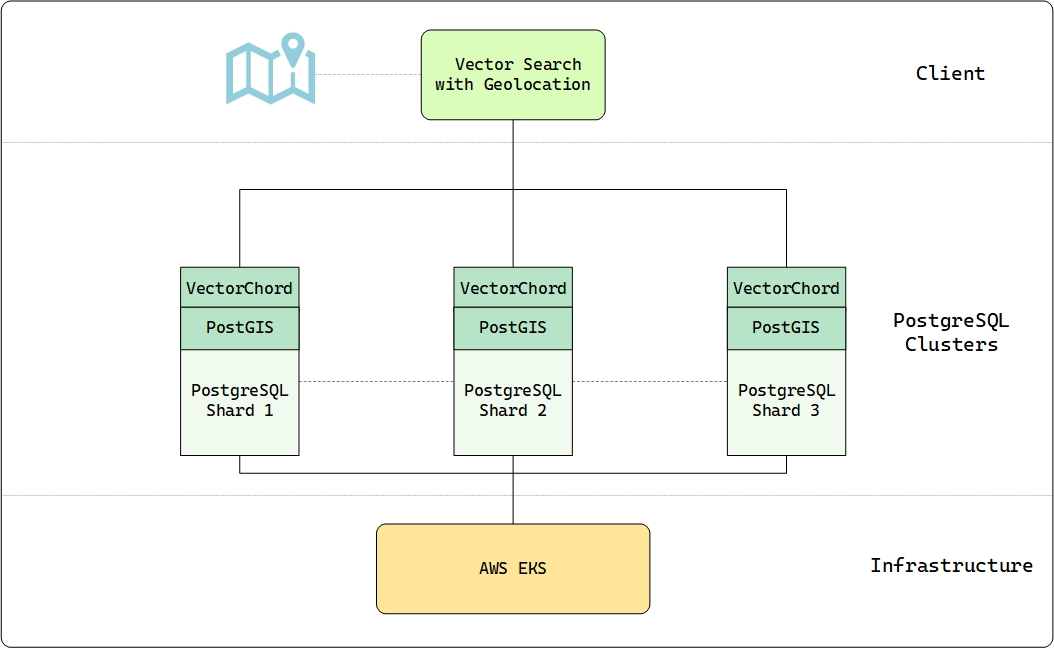
核心数据存储在跨三个节点的分区表结构中。主表 globe24 存储了每个切片的唯一 ID、地理空间点几何信息(geometry(Point, 4326))、分区键(partkey),以及至关重要的、以 halfvec(384) 格式高效存储的 384 维 AI 生成嵌入向量。这种分片策略将 32 亿行数据均匀分布在集群中,从而支持高效的并行处理。
该架构的一大核心优势在于能够执行复杂的联合查询。Earth Index 经常执行的 SQL 语句会将 VectorChord 的快速向量检索(embedding <=> '{vector}'::vector)与 PostGIS 地理空间过滤(st_within(geom, '{geom}'))以及分区裁剪(partkey IN (...))无缝结合。这使得用户能够在指定的地理边界内高效地查找视觉特征相似的地点。即便面对数十亿条向量,这种一体化方案依然能提供极为实用的性能表现:对于返回前 500 条结果的典型搜索,其查询延迟中位数(P50)仅约为 761 ms。
大规模赋能环保行动
通过在 PostgreSQL 内部提供高性价比、可扩展且紧密集成的向量检索解决方案,VectorChord 助力 Earth Index 实现了这项开创性的工作。它使团队能够以可承受的成本管理庞大的“地球 DNA”数据库,确保这一强大的环境监测工具能够真正惠及最需要它的组织与社区。
立即加入 Earth Index 候补名单,探索您身边的环境变化、了解您的生态足迹,并成为守护地球全球行动的一份子。
我们非常欣喜地看到 Earth Index 利用 VectorChord 将海量卫星数据转化为可付诸行动的环境情报。他们的成功充分证明了将前沿 AI、稳健的数据库技术与高效的向量检索相结合,在应对全球重大挑战时所迸发出的巨大能量。
希望将大规模向量检索引入您的 PostgreSQL 数据库?立即深入了解 VectorChord 并开始体验吧!