可扩展性
背景
高每秒查询数(QPS)的向量检索对于推荐引擎、图像识别和自然语言处理等实时应用至关重要。这类应用要求快速、高效的检索能力以即时返回结果,这对于保持用户互动体验与业务运转效率尤为关键。通过利用 PostgreSQL 进行向量检索,您不仅能够受益于其成熟稳健的关系型数据库能力和高级索引机制,还能避免额外维护一套独立专用向量数据库的运维开销。这种统一的架构在满足现代应用高性能需求的同时,大幅简化了系统集成并降低了整体复杂度。
架构设计
在多节点集群上使用 VectorChord 比在单机上部署更具挑战性。与其他分布式服务类似,一套可靠的分布式向量检索系统通常需要满足以下核心要求:
-
易用性(Usability):支持声明式配置管理
-
弹性(Elasticity):能够根据 QPS 需求自动扩缩容节点
-
负载均衡(Load Balancing):将查询请求高效地分发到不同的只读副本实例上处理
-
高可用性(High Availability):维护数据库的多个副本,并在发生故障时自动从副本恢复
-
持久性(Durability):提供安全、持久化的存储,确保数据完整性并防止故障时发生数据丢失
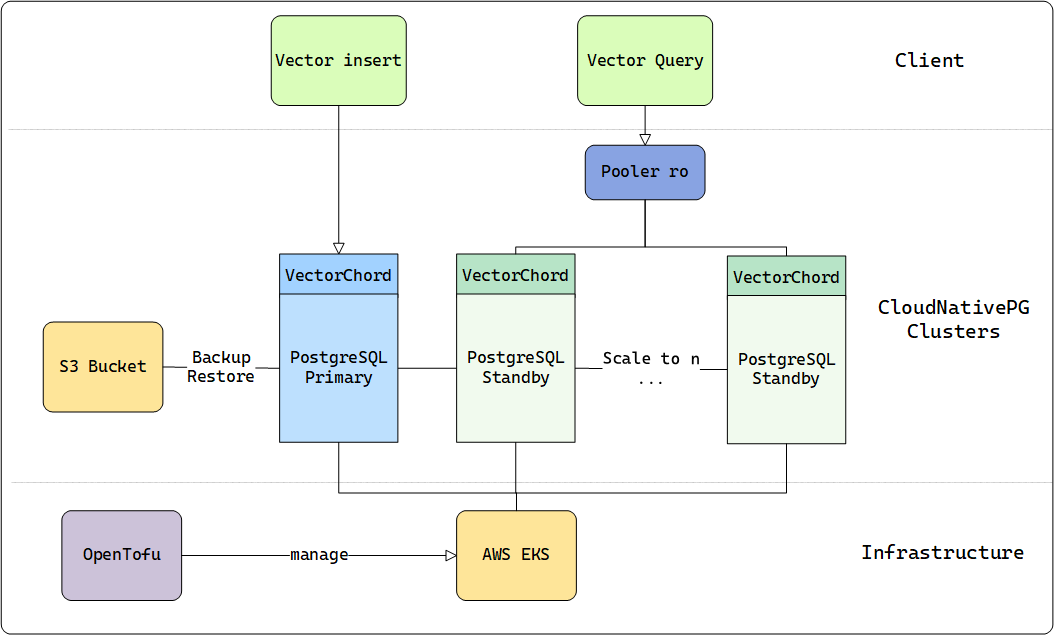
为此,我们在 AWS EKS 上结合使用 OpenTofu 和 CloudNativePG 来部署 VectorChord 服务,由它们统一管理提供上述能力的基础设施。构建示例集群的核心组件如下:
-
OpenTofu:Terraform 的开源替代方案,用于在 AWS EKS 上实现基础设施即代码(IaC)
-
CloudNativePG:基于主从(Primary/Standby)架构,管理高可用 PostgreSQL 数据库集群的全生命周期
-
PgBouncer:轻量级 PostgreSQL 连接池,由 CloudNativePG 的 Pooler 模块直接提供支持
与 DiskANN 类似,VectorChord 能够充分利用磁盘资源,在内存不足时依然保持极具竞争力的检索性能。此外,VectorChord 也可以将索引缓存在内存中,以获得极致的高并发查询吞吐。
关于 VectorChord 的更多技术细节,请参阅我们此前的博文。
为了冲击极限 QPS,我们假设内存能够完全容纳数据集,并以此为标准选择对应的 AWS 机型。
在下表中,我们列出了针对不同规模数据集能够将数据完全缓存在内存中的推荐机型:
| 数据集 | 维度 / 规模 | 机型 / 内存 |
|---|---|---|
| LAION-5m | 768 / 5,000,000 | r7i.xlarge / 32GB |
| LAION-100m | 768 / 100,000,000 | r7i.16xlarge / 512GB |
测试结果
正如我们的调优文档所述,VectorChord 接受两个关键查询参数:nprob 和 epsilon。其中,nprob 定义了查询期间需要扫描的候选聚类中心(列表)数量,而 epsilon 则作为决定是否对候选结果进行重排序的阈值。这两个参数对 QPS 和**召回率(Recall)**都有着决定性影响,允许用户在检索速度与准确性之间进行精细权衡:
-
降低
nprob会带来更高的 QPS,但召回率会有所下降。 -
降低
epsilon会带来更高但波动更大的 QPS,同时召回率也会有所下降。
当固定这两个参数时,每次实验的检索精度将保持一致,但实际 QPS 仍会随底层硬件的 CPU 和 I/O 性能而变化。为了确保召回率始终保持在 0.9 以上,我们根据此前在小规模数据集上的实验经验配置了如下参数:
| 数据集 | nprob / epsilon | 召回率(Recall) |
|---|---|---|
| LAION-5m | 20 / 1.0 | 0.9324 |
| LAION-100m | 20 / 1.0 | 0.9042 |
我们在同一个可用区内部署了一台 r7i.4xlarge 实例作为客户端,用于向 VectorChord 集群发起压测查询。测试使用了从 16 到 128 不等的并发工作线程数(Workers),以模拟真实生产场景下数据库通常承受的并发压力。这一设置使我们能够全面评估 VectorChord 在不同工作负载与并发条件下的表现。
配备 16 个 vCPU 的 r7i.4xlarge 实例能够在并发请求高达 128 时有效避免客户端侧的 CPU 争用瓶颈。
遵循通用的 PgBouncer 最佳实践,我们部署了两种类型的实例:一个主实例(Primary)专门用于数据写入,以及多个只读副本实例(Replica)专门处理只读查询负载。PgBouncer 充当负载均衡器,将查询高效地分发至后端的各个副本实例。在基准测试期间,我们将查询端点指向 read-only (ro) 连接池,而 read-write (rw) 主实例在测试过程中保持空闲。这种读写分离架构确保了读密集型工作负载下的最优资源利用率与水平扩展能力。
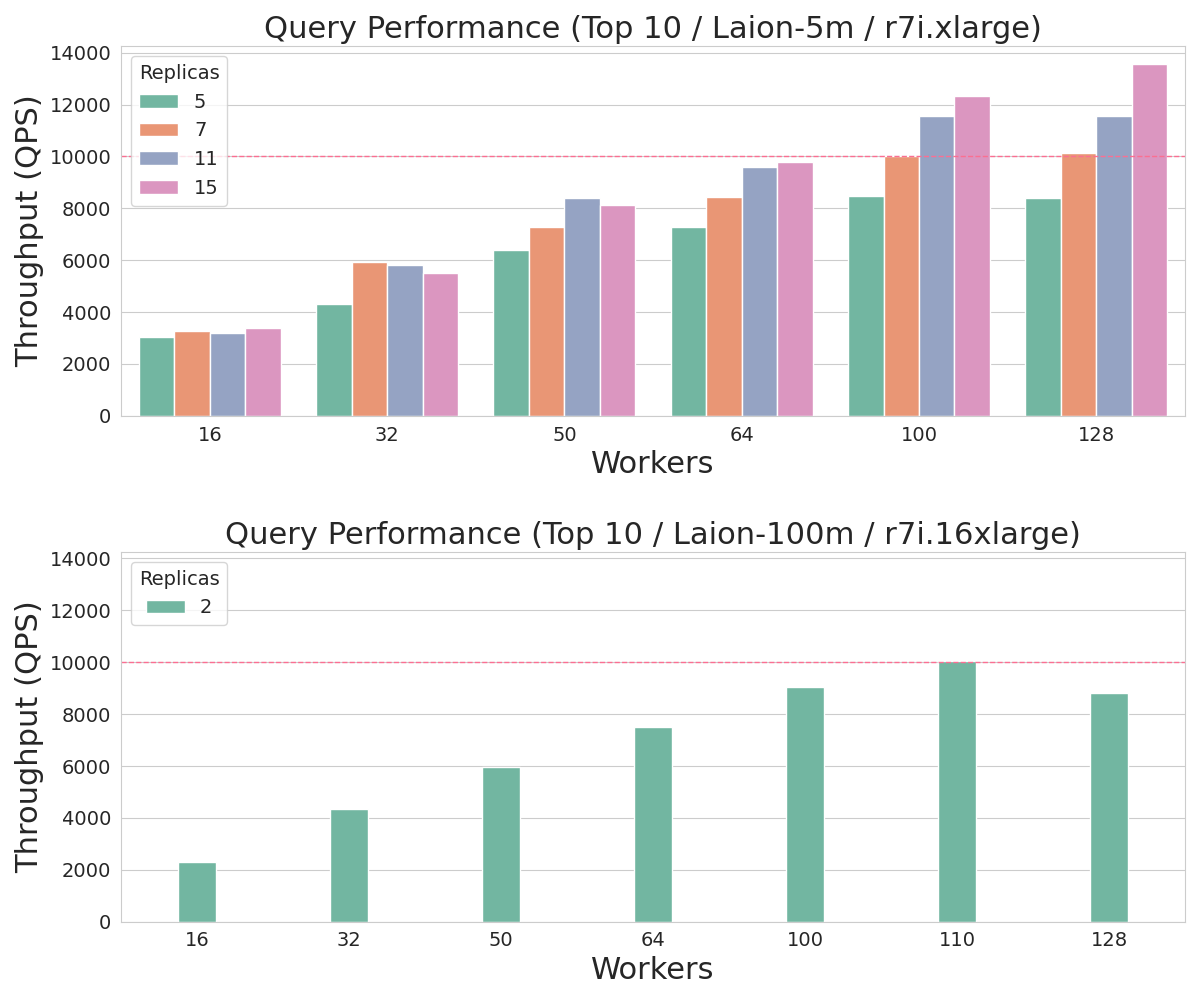
对于 500 万规模的数据集(LAION-5m),我们将副本实例数量从 5 台扩展到 15 台,成功突破了 10,000 QPS。相比之下,对于 1 亿规模的数据集(LAION-100m),仅需 2 台大规格实例便足以达到这一性能标准。下图展示了这些实验的结果,充分证明了 VectorChord 在不同数据集规模下的线性扩展能力与卓越效率。
成本分析
综上所述,如果您需要在这两类数据集上实现 10,000+ QPS 的吞吐量,所需的最低硬件成本如下:
| 数据集 | 达到 10,000+ QPS 的最低硬件配置 | vCPU 数量 | 预估月度成本 |
|---|---|---|---|
| LAION-5m | r7i.xlarge × 7 | 4 × 7 = 28 vcpu | $0.2646 × 7 × 720 = $1334 |
| LAION-100m | r7i.16xlarge × 2 | 64 × 2 = 128 vcpu | $4.2336 × 2 × 720 = $6096 |
上述成本计算未包含主实例(Primary)的开销,因为主实例可以与其他 PostgreSQL 连接池共享复用,从而进一步优化资源配置并降低整体开支。
无论是在公有云还是私有数据中心,本次实验都为您规划和扩展自己的集群以达到理想的 VectorChord 检索性能提供了可靠参考。即使在将性能置于首位的严苛场景下,VectorChord 依然展现出了极具竞争力的价格优势,是高性能向量检索需求的高性价比之选。
总结
无论您是在高性价比的 VPS 上启动初创项目,还是为追求极致性能而扩展大规模集群,VectorChord 都能为您打开无限可能。虽然本文重点探讨了 10,000 QPS 的架构实践,但这远非 VectorChord 的性能上限。
凭借强大的索引算法,VectorChord 不仅通过高效利用内存与高速 SSD 超越了 pgvector 等标准 PostgreSQL 方案,还在处理海量数据规模与高并发 QPS 需求时胜过了众多专用向量数据库。在同等成本下,它既能提供更卓越的性能,又彻底消除了维护独立向量检索系统的架构复杂度。
如果您渴望探索大规模向量检索解决方案,欢迎加入我们的 Discord 社区或发送邮件至 rh@vonng.com 与我们联系。让我们携手释放您数据的全部潜能!