# 与 pgvector 的基准测试对比
> 对比 VectorChord 与 pgvector 在 QPS、Recall@100、索引构建时间与数据插入时间四个核心指标上的表现。
---
LLMS 索引: [llms.txt](/zh/llms.txt)
---
在本节中,我们将 VectorChord 与提供向量相似性检索能力的 PostgreSQL 扩展 pgvector 进行对比。我们将重点关注四个核心指标:QPS(每秒查询数)、Recall@100(Top-100 召回率)、索引构建时间(Index Building Time)以及数据插入时间(Insertion Time)。如果您对我们的实现细节感兴趣,请参阅我们的博文《[PostgreSQL 上的向量检索:内存与磁盘方案的对比分析](/zh/blog/post/vector-search-over-postgresql-a-comparative-analysis-of-memory-and-disk-solutions/)》。
## QPS 与召回率 {#qps--recall}
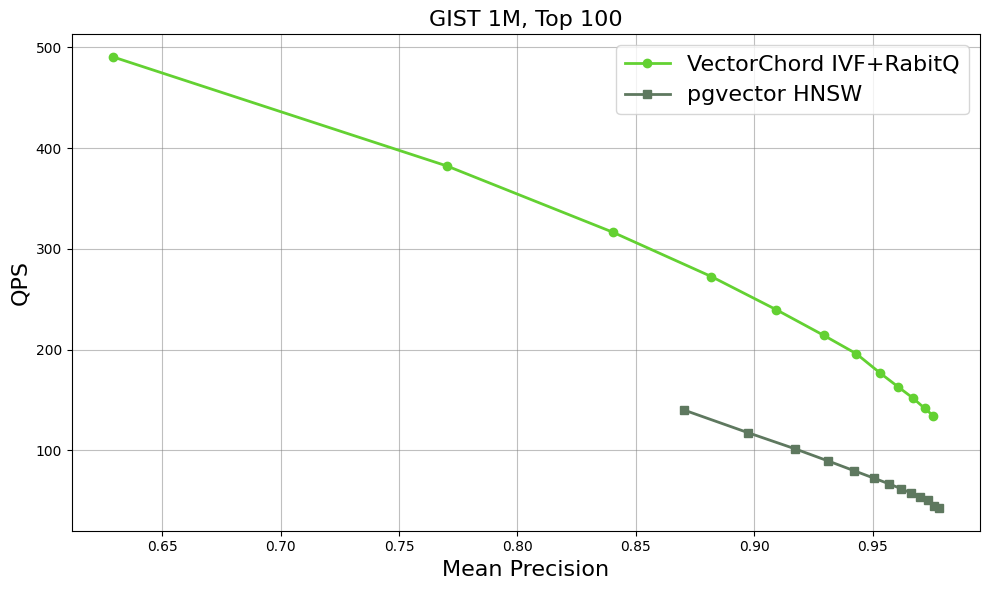 上方展示了在 GIST 数据集(包含 100 万条 960 维向量)上的初步基准测试结果。在相同的召回率水平下,VectorChord 的 QPS 可达 pgvector 的两倍。更多详情将在基准测试章节中展开说明。
## 索引构建时间、插入时间与查询完成时间 {#index-build-time--insert-time--query-completion-time}
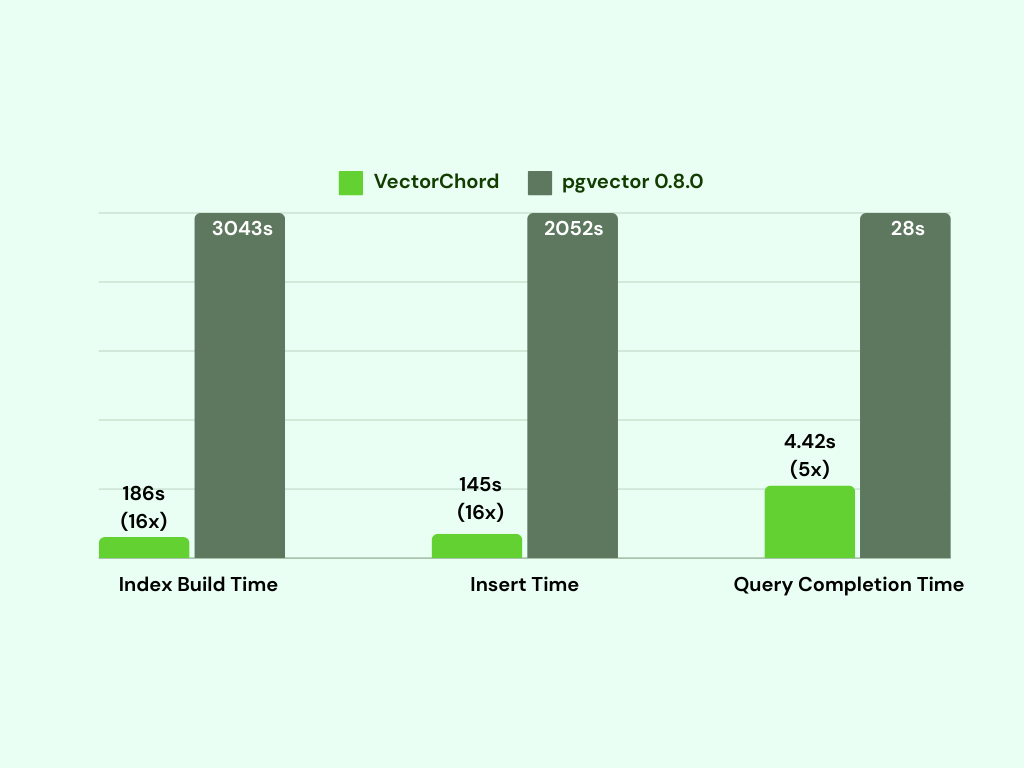 通过利用独立的机器执行 KMeans 聚类,VectorChord 仅需 186 秒即可完成索引构建,**速度比 pgvector 快 16 倍**。此外,其数据插入速度也比 pgvector 快 14 倍。众所周知,构建索引是向量数据库中资源消耗最密集的环节,需要大量的计算资源,并会显著推高对 CPU 和内存的需求。通过利用算力更强的机器在外部完成索引构建,再将其导入至小规格机器中提供查询服务,在单台机器上支撑数十亿级向量的检索将成为可能。