这是本节的多页打印视图。 .
常见问题
- 1: 常见问答
- 2: 与 pgvector 对比
- 3: 为什么不使用专用向量数据库?
- 4: 基准测试
1 - 常见问答
我们强烈建议你了解并选用我们全新的 VectorChord 实现,它提供了更高的稳定性和性能。建议现有用户迁移至 VectorChord,具体步骤请参阅迁移指南。
找不到向量类型或操作符类
在大多数情况下,这是由于缺少 Schema 搜索路径(search_path)或权限不足导致的。
请按照以下检查清单逐一排查:
- 在
psql中运行\dx或执行SELECT * FROM pg_extension;,检查扩展是否已安装:
如果未安装,请执行 CREATE EXTENSION vectors; 进行安装。
- 运行
SHOW search_path;,检查其中是否包含vectors:
如果不包含,请执行 SET search_path="$user", public, vectors; 进行设置。
- 如果
pgvecto.rs是由其他超级用户安装的:
请在 psql 中运行 \dn 或执行 SELECT nspname FROM pg_catalog.pg_namespace;,检查 vectors Schema 是否存在且当前用户是否有权访问:
如果当前用户无权访问,请以超级用户身份登录并将 Schema 权限授予当前用户(current_user):
GRANT ALL ON SCHEMA vectors to tensorchord;
2 - 与 pgvector 对比
原文:pgvector vs. pgvecto.rs in 2024: A Comprehensive Comparison for Vector Search in PostgreSQL
太长不看(TL; DR):请直接跳转到总结部分,查看展示两者核心差异的对比表格。
检索能力
检索是数据库的核心能力,对于实现高效的数据获取、帮助用户快速查找所需信息至关重要。下面我们将展示 pgvecto.rs 与 pgvector 的性能表现,并重点对比二者提供的各项功能特性。
过滤检索
虽然 pgvector 和 pgvecto.rs 都支持在 PostgreSQL 中进行向量相似度检索,但 pgvecto.rs 更进一步,引入了来自 OSDI 2023 的 VBASE 方法。
真实业务负载通常涉及向量检索与关系型查询的结合。向量检索擅长相似度匹配与相似向量召回,而关系型查询则支持对结构化数据执行复杂的连接(JOIN)、过滤(Filter)和聚合(Aggregation)。
pgvecto.rs 专为高效处理**单向量 TopK + 过滤 + 连接(Single-Vector TopK + Filter + Join)**场景而设计。
由于目前缺乏通用的关系型向量基准测试集,我们使用 laion-768-5m-ip-probability 数据集进行基准测试。该数据集衍生自 LAION 2B 图像数据集,包含 5,000,000 条向量和 10,000 条查询。
该数据集包含一个 probability 列,用于存储从 0 到 1 均匀分布生成的随机浮点数。选择率(ratio)为 0.01 意味着每次查询过滤后覆盖数据集的 1%(即 0.01 倍),便于开展针对性的选择率分析。
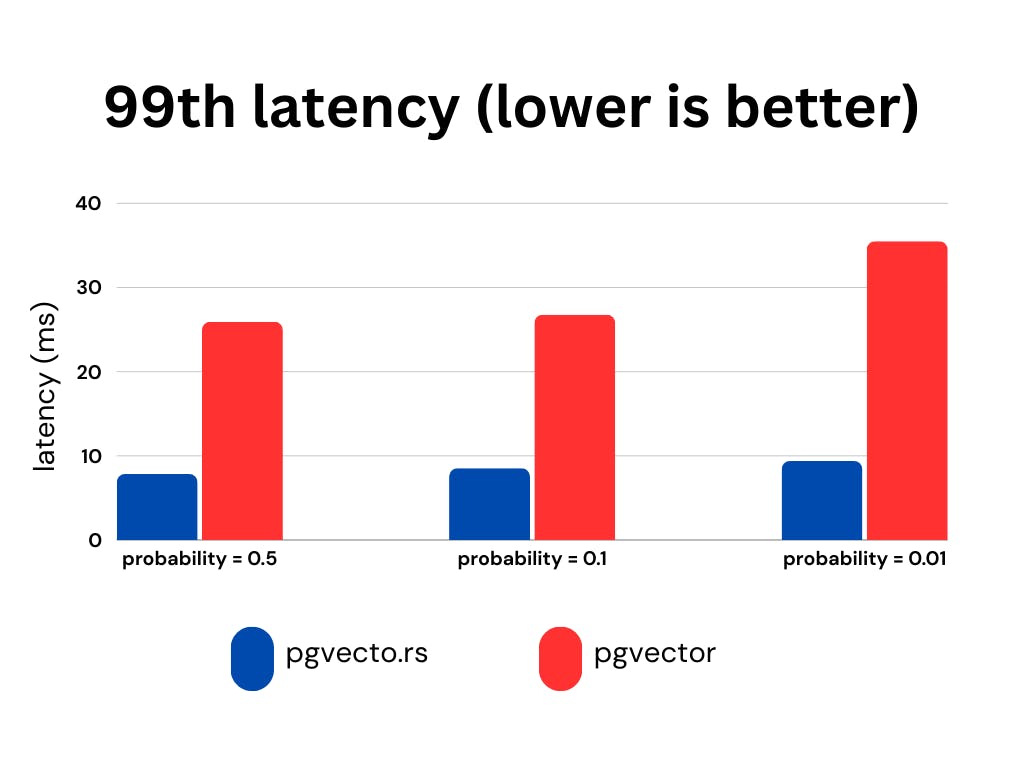
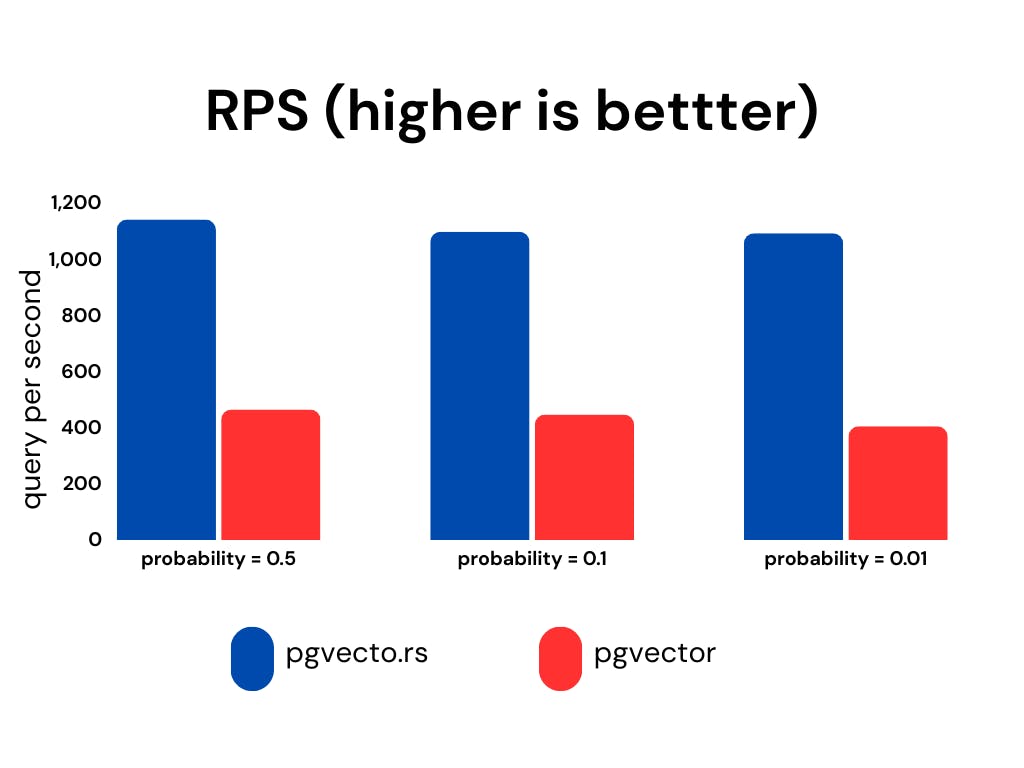
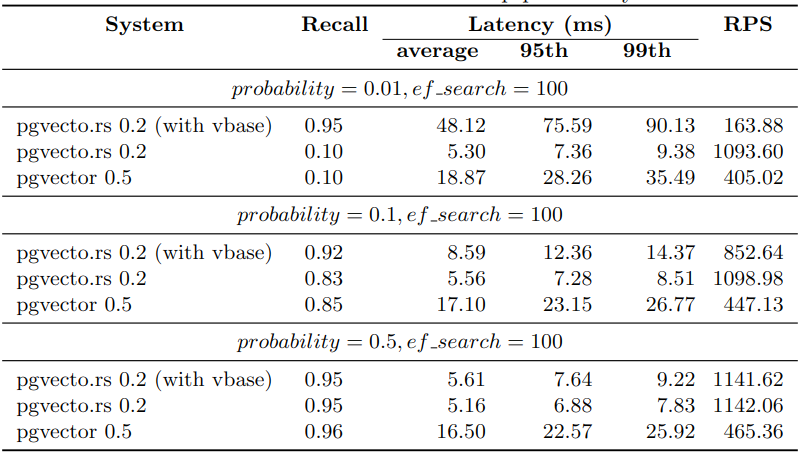
我们在保持 ef_search 不变的前提下,展示了不同 probability 范围下的召回率(Recall)、延迟(毫秒)和每秒请求数(RPS)。ef_search 参数表示 k-NN(k 近邻)搜索期间使用的候选列表大小,决定了搜索精度与查询处理耗时之间的权衡。
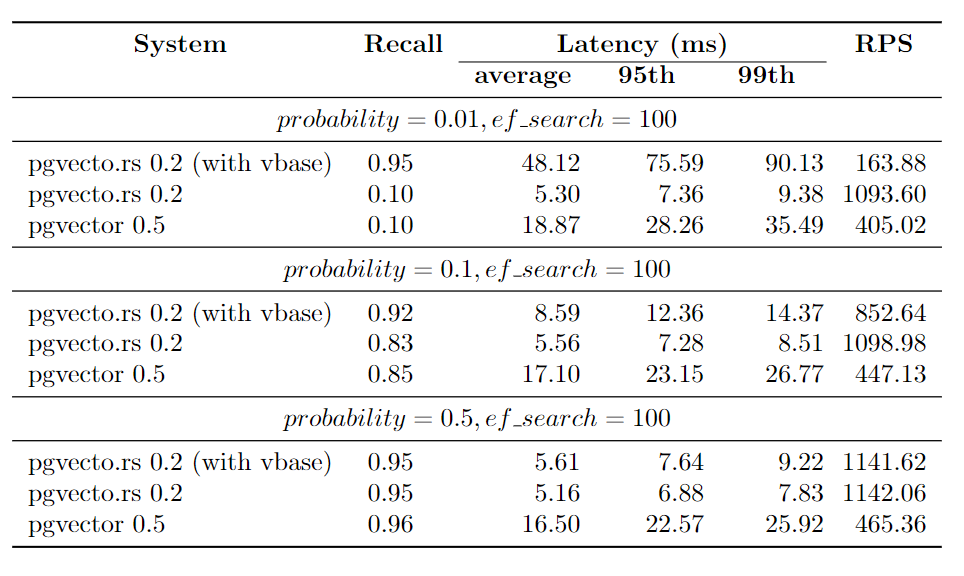
当结合 VBASE 使用时,pgvecto.rs 能够始终保持更高的召回率,尤其是在低选择率(高过滤比)场景下优势极为显著。
稀疏向量检索
稀疏向量是仅包含少量非零元素的高维向量,非常适用于传统信息检索(IR)场景。例如,一个拥有 32,000 个维度但仅有 2 个非零元素的向量就是典型的稀疏向量:
稠密向量则是神经网络生成的嵌入向量(Embeddings),由文本嵌入模型生成,其中绝大多数或全部元素均为非零值。它们的维度通常较低(如 256 或 1536 维),远小于稀疏向量:
pgvecto.rs 同时支持稠密向量检索和稀疏向量检索。它提供了 svector 数据类型,用于构建稀疏向量索引并执行高效检索:
向量维度上限
pgvecto.rs 扩展支持最高 65,535 维的向量,而 pgvector 扩展的 vector 索引最多仅支持 2,000 维。这一维度上限的差异使得 pgvecto.rs 能够直接处理 OpenAI 最新高维嵌入模型生成的向量。
单指令多数据流(SIMD)
pgvecto.rs 会在运行时动态检测并利用用户机器上可用的最优 SIMD(单指令多数据流)指令集;而 pgvector 则依赖编译器在编译期生成静态 SIMD 代码,无法在运行时针对宿主机的硬件特性自动选择更快的指令集。更快的向量距离计算使得 pgvecto.rs 的检索速度更具优势。
数据类型
二值向量
bvector 是 pgvecto.rs 中的二值向量类型,表示每个分量仅取两个可能值(通常为 0 和 1)的向量。
在配合特定嵌入模型(如 OpenAI 嵌入模型)使用时,二值向量具有显著优势:它能在保持理想召回精度的同时,大幅降低内存占用。
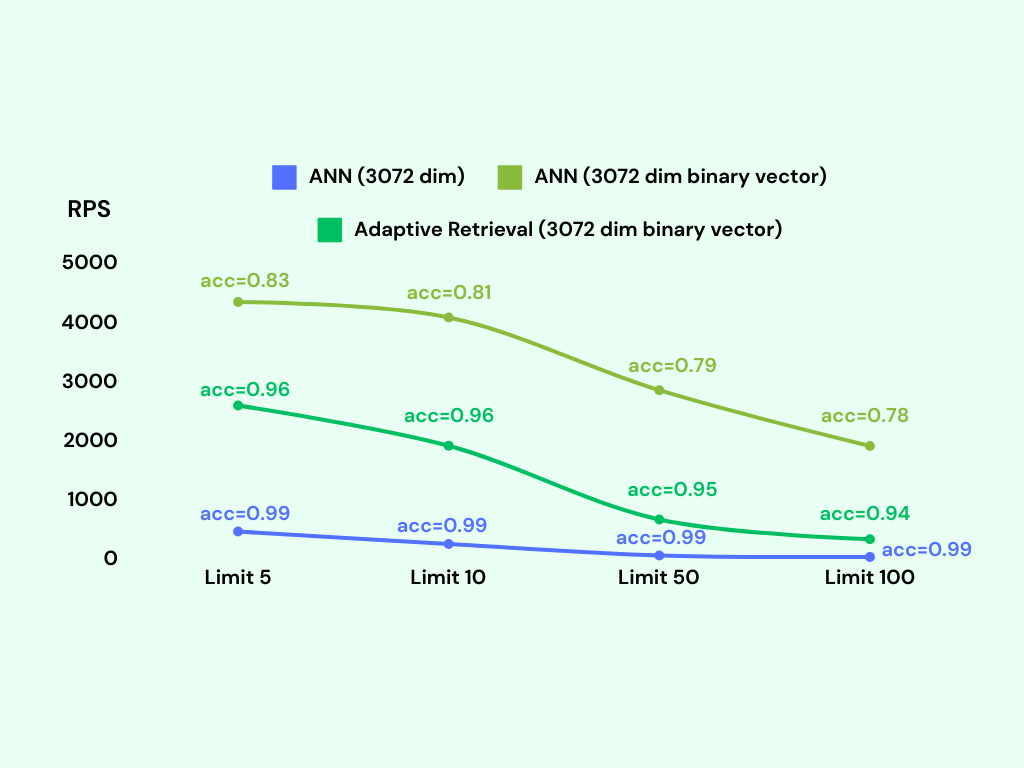
以下是 bvector 类型的性能基准测试,采用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,测试环境为 Google Cloud 上的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机。
我们将 100 万条二值向量写入表中并建立索引,随后对每条查询运行 KNN 搜索。为 100 万条二值向量建立索引仅需约 600 MB 内存,而使用 vector 类型为相同数量的向量建立索引则需要约 18 GB 内存。如果结合采用自适应检索(Adaptive Retrieval),bvector 的准确率可超过 95%。
FP16/INT8
除二值向量外,pgvecto.rs 还支持 FP16(16 位浮点数)数据类型以及 INT8(8 位整数)量化存储。
索引架构
与 pgvector 相比,pgvecto.rs 采用了不同的索引架构设计。它独立于 PostgreSQL 管理索引的存储与内存,而不是像 pgvector 那样依赖 PostgreSQL 的原生页面存储引擎。
这是一种工程架构上的权衡。在开发初期,我们也曾尝试像 pgvector 一样基于 PostgreSQL 的页面存储(Page Storage)来实现分层可导航小世界(HNSW)图索引,但遇到了诸多制约其性能与功能的瓶颈:
- 并行化难题:PostgreSQL 采用单语句单进程模型,且内部 API 并非线程安全,这给多线程并行带来了巨大挑战。构建向量索引属于计算密集型任务,并行化能显著提升性能;但我们在尝试并行化该过程时,频繁遭遇
Too many shared buffer locked(锁定的共享缓冲区过多)错误。 - 预写式日志(WAL)写放大:插入一条 2 KB 的向量往往会产生超过 20 KB 的 WAL 日志。这一问题源于 HNSW 算法本身的特性——每插入一个节点都需要修改图中的多条边,而 PostgreSQL 会在 WAL 中逐条记录每一次页面修改,从而导致严重的 WAL 写放大。
- 锁竞争(Lock Contention):在遍历和更新 HNSW 图时,读写操作都需要对边列表加锁。由于 HNSW 采用分层结构,越高的层级包含的节点越少,导致高层节点在索引并发读写时极易成为锁竞争瓶颈,进而引发延迟升高和并发吞吐量下降。
为此,pgvecto.rs 采用了类似 FreshDiskANN 与日志结构合并树(LSM-Tree)的架构设计。该架构由三个组件构成:写入段(Writing Segment)、增长段(Growing Segment)和封存段(Sealed Segment)。新写入的向量首先进入写入段,随后由后台进程异步转换为不可变的增长段,最后增长段会与封存段进行合并(类似于 LSM-Tree 中的 Compaction 过程)。这种设计带来了诸多优势:
- 非阻塞插入:索引的后台构建与优化不会阻塞前台的数据插入操作。
- 批量更新图结构:将对 HNSW 图的修改进行批量聚合处理,显著提升了写入吞吐量。
- 消除读写锁竞争:由于封存段(Sealed Segment)是不可变的(Immutable),彻底缓解了并发检索时的读写锁竞争问题。
当然,这种独立存储方式也存在不足,其中最主要的一点是索引无法直接获得 PostgreSQL 开箱即用的预写式日志(WAL)支持。这意味着依赖 WAL 的时间点恢复(PITR)和物理复制(Physical Replication)无法直接作用于索引文件(注:这一限制已在后续的继任项目 VectorChord 中通过原生 PostgreSQL 存储引擎架构彻底解决)。
总结
下表汇总了 pgvecto.rs 与 pgvector 之间的主要区别:
| 特性 | pgvecto.rs | pgvector |
|---|---|---|
| 过滤检索(Filtering) | 引入 VBASE 方法,专为向量检索结合关系型查询(如单向量 TopK + Filter + Join)深度优化。 | 应用过滤条件时可能出现召回结果不足的情况(例如原本指定 LIMIT 10,过滤后可能只返回 5 条结果)。 |
| 向量维度上限 | 最高支持 65,535 维。 | 索引最高支持 2,000 维(vector 类型)。 |
| SIMD 加速 | 在运行时根据宿主机硬件能力动态派发最优 SIMD 指令集,最大化计算性能。 | 依赖编译器在编译期生成的静态 SIMD 代码。 |
| 数据类型 | 提供丰富的数据类型支持:稠密向量、稀疏向量、二值向量、FP16(16 位浮点数)以及 INT8 量化。 | - |
| 索引存储架构 | 独立于 PostgreSQL 管理索引的磁盘存储与内存映射。 | 依赖 PostgreSQL 原生页面存储引擎。 |
| WAL 支持 | 表数据支持预写式日志(WAL),索引的 WAL 支持尚在开发中。 | 表数据和索引均支持预写式日志(WAL)。 |
3 - 为什么不使用专用向量数据库?
欢迎阅读我们的完整博客文章:我们真的需要专用向量数据库吗?(2023) | vchord.pgsty.com。
试想一下:你现有的业务数据已经存储在 Postgres 数据库中,现在你希望引入向量数据库来执行向量相似度检索。如果采用专用向量数据库,你就必须将数据从 Postgres 同步迁移到向量数据库中,并且同时运维两套数据库系统。这显然不是一个好主意。
为什么不直接使用 Postgres 来完成向量相似度检索呢?这正是我们构建 pgvecto.rs 的初衷。使用体验非常自然直观:
引用自 SingleStore DB 博客:
向量和向量检索本质上只是一种数据类型和一种查询处理方式,而不是构建全新数据处理范式的基石。使用专用向量数据库(SVDB)会导致我们在使用多套专用系统的客户身上反复看到的那些典型问题:数据冗余、过度的数据迁移、分布式组件之间的数据不一致、需要专门技能带来的额外人力成本、额外的商业授权费用、受限的查询语言表达能力与可编程/可扩展性、匮乏的工具链生态集成,以及与真正的数据库管理系统(DBMS)相比糟糕的数据完整性与高可用保障。
4 - 基准测试
pgvecto.rs 从诞生之初就高度专注于性能。我们持续监控 pgvecto.rs 的性能表现,并与其他向量检索库进行对比测试。以下基准测试结果来自 2024 年 1 月。
测试在 Google Cloud n2-standard-8(8 vCPU,32 GB 内存)实例上进行,使用 laion-768-5m-ip 数据集。
pgvecto.rs 对比 pgvector
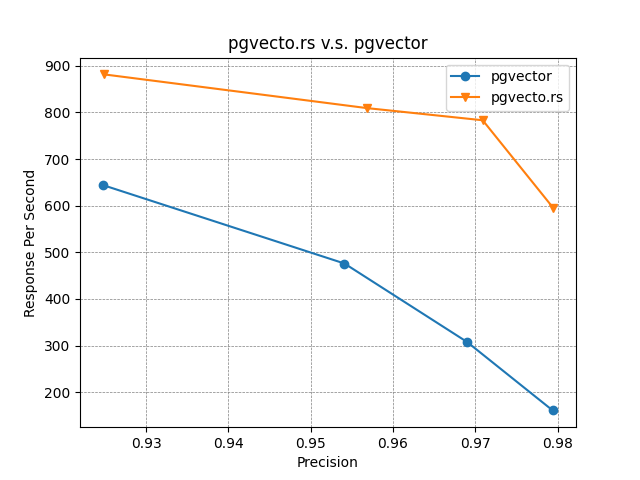
在使用 HNSW 索引时,pgvecto.rs 在保持约 97% 略高召回精度的同时,每秒响应数(RPS)可达到 pgvector 的 2.5 倍。当对召回精度要求更高时,这一性能优势还会进一步扩大。
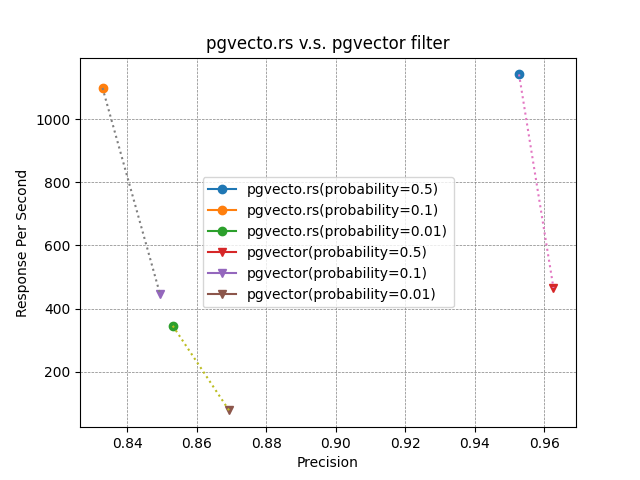
启用 vbase 模式后,在不同的过滤条件选择率(filter probability)下,pgvecto.rs 的每秒响应数相比 pgvector 均可提升 2 倍以上。
不同量化方法的对比
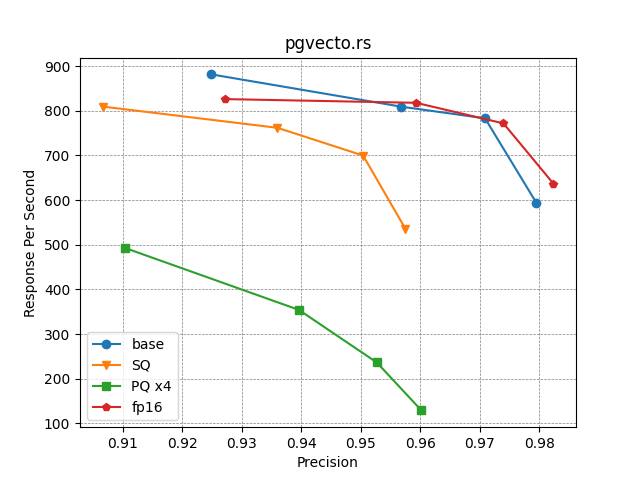
pgvecto.rs 支持多种量化方法以及不同低精度的索引方式。这些方法有助于在不同数据规模下大幅降低内存占用。下图展示了 pgvecto.rs 在不同量化方法下的性能表现:
缩短嵌入向量(即 Matryoshka Embedding)
OpenAI 的最新嵌入模型支持缩短嵌入向量(Shortening Embeddings),开发者只需“直接移除序列末尾的部分数值”,即可在更短的维度下依然保留有效的文本语义表征。
这一特性带来了极高的使用灵活性。例如,当使用的向量数据存储仅支持最高 1024 维的嵌入向量时,开发者依然可以使用我们最强大的嵌入模型
text-embedding-3-large,并将 API 参数dimensions指定为 1024,从而将嵌入向量从 3072 维缩短为 1024 维,以极小的精度折衷换取更紧凑的向量体积。
以下是针对缩短后嵌入向量的性能基准测试。测试采用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集。原始嵌入向量为 3072 维,缩短后的嵌入向量分别为 256 维和 1024 维。基准测试同样在 Google Cloud 的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机上进行。
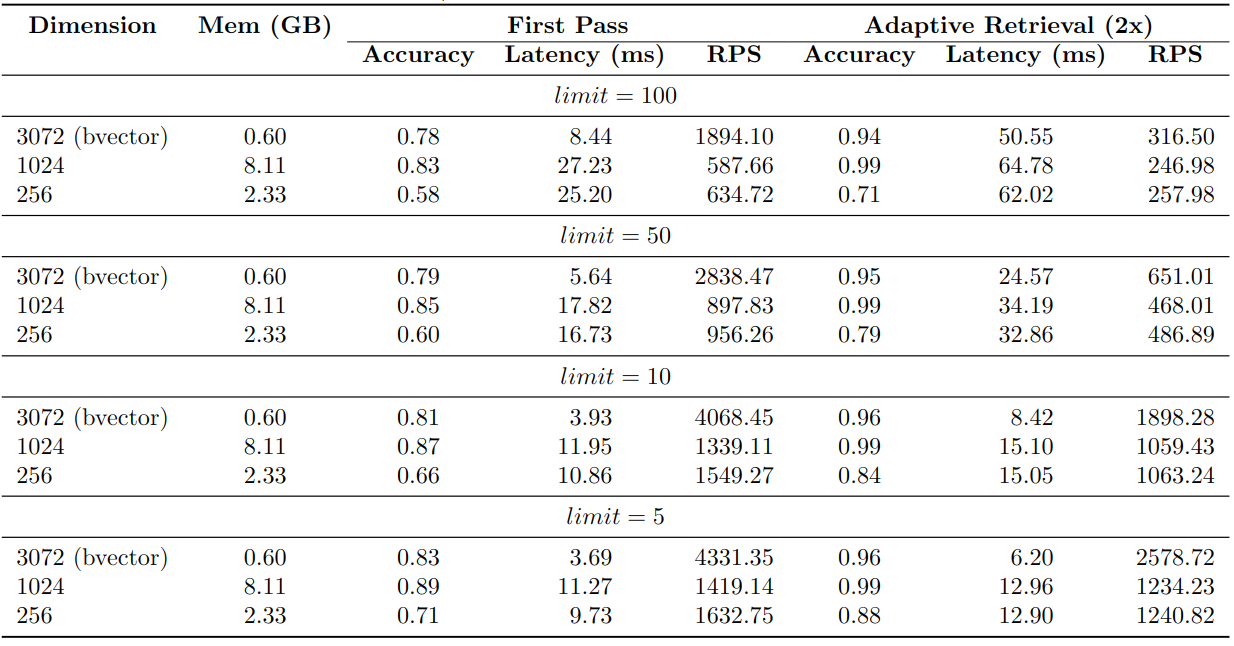
基准测试中的 First Pass(初筛阶段) 表明,仅使用缩短后的嵌入向量时,其召回精度不如完整维度的嵌入向量:256 维 HNSW 索引仅能达到约 65% 的准确率,而 1024 维 HNSW 索引约为 85%。
然而,当结合使用自适应检索(Adaptive Retrieval)时,缩短后嵌入向量的最终准确率能够超过 95%。此外,采用这种方法还能在 RPS(每秒请求数)和查询延迟方面带来显著提升。
二值向量
pgvecto.rs 支持二值向量(Binary Vectors)。bvector 类型专为存储效率与计算性能而优化,采用按位紧凑打包(bit-packed)的方式存储二值向量,并针对二值向量的距离计算进行了专门优化。
以下是 bvector 类型的性能基准测试,使用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,测试环境为 Google Cloud 上的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机。
我们将 100 万条二值向量写入表中并建立索引,随后对每条查询向量运行 KNN 搜索。为 100 万条二值向量建立索引仅需约 600 MB 内存,而使用普通 vector 类型为相同数量的向量建立索引则需要约 18 GB 内存。
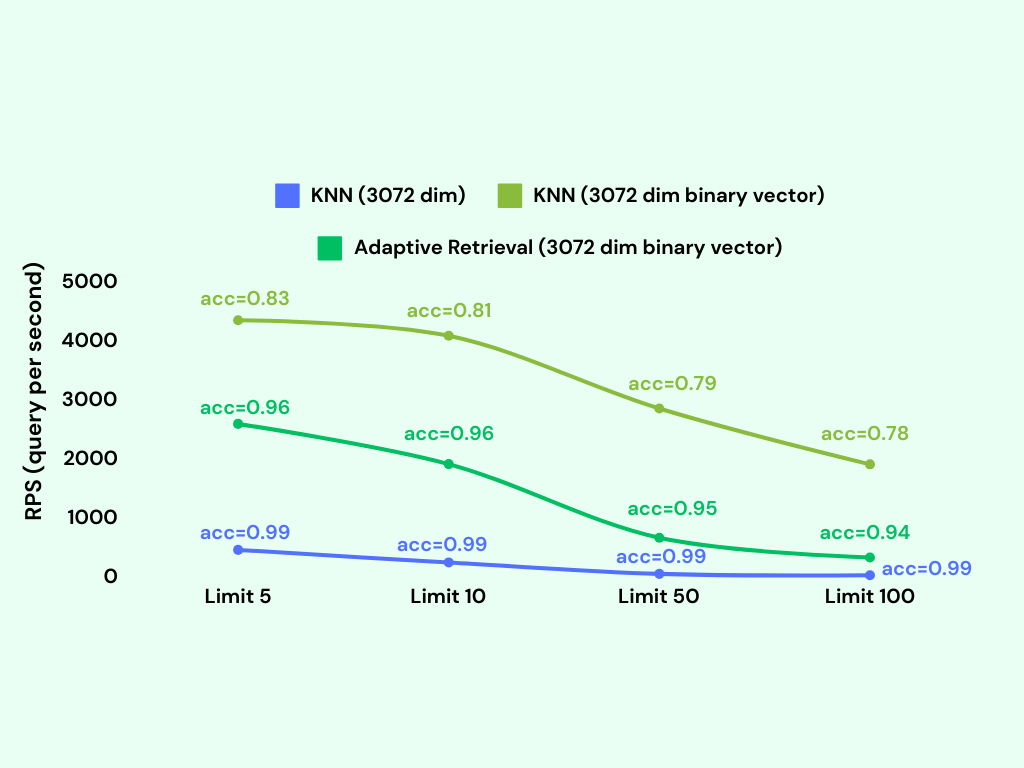
可以看到,单纯使用 bvector 的召回精度略低于 vector 类型,但如果结合采用自适应检索(Adaptive Retrieval),其准确率同样能够超过 95%。