这是本节的多页打印视图。 .
基准测试
- 1: 价格基准测试
- 2: 性能基准测试
- 3: 与 pgvector 的基准测试对比
- 4: 与 Elasticsearch 的基准测试对比
- 5: 与 pgvectorscale 的基准测试对比
1 - 价格基准测试
使用 VectorChord,您可以在单台机器上对 1 亿条 768 维向量执行 Top-10 查询,在保持 0.95 召回率(Precision/Recall)的同时实现 131 的 QPS,而整套配置的月度成本仅为 250 美元。如果您对我们的技术实现细节感兴趣,请参阅我们的博文《VectorChord:在 PostgreSQL 中仅需 1 美元存储 400k 向量》。
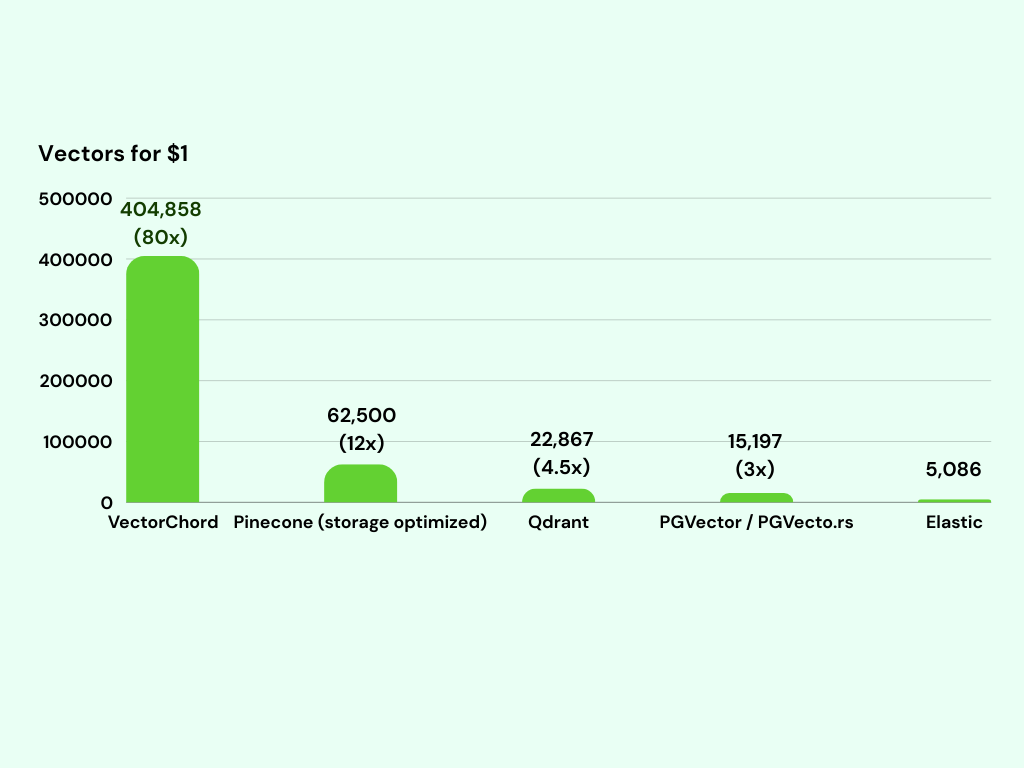
这意味着您只需花费 1 美元即可存储 400k(40 万)条向量,从而实现显著的成本节约:在同等价格下,可存储的向量数量是 Pinecone(存储优化型实例)的 6 倍,是 pgvector/pgvecto.rs 的 26 倍。
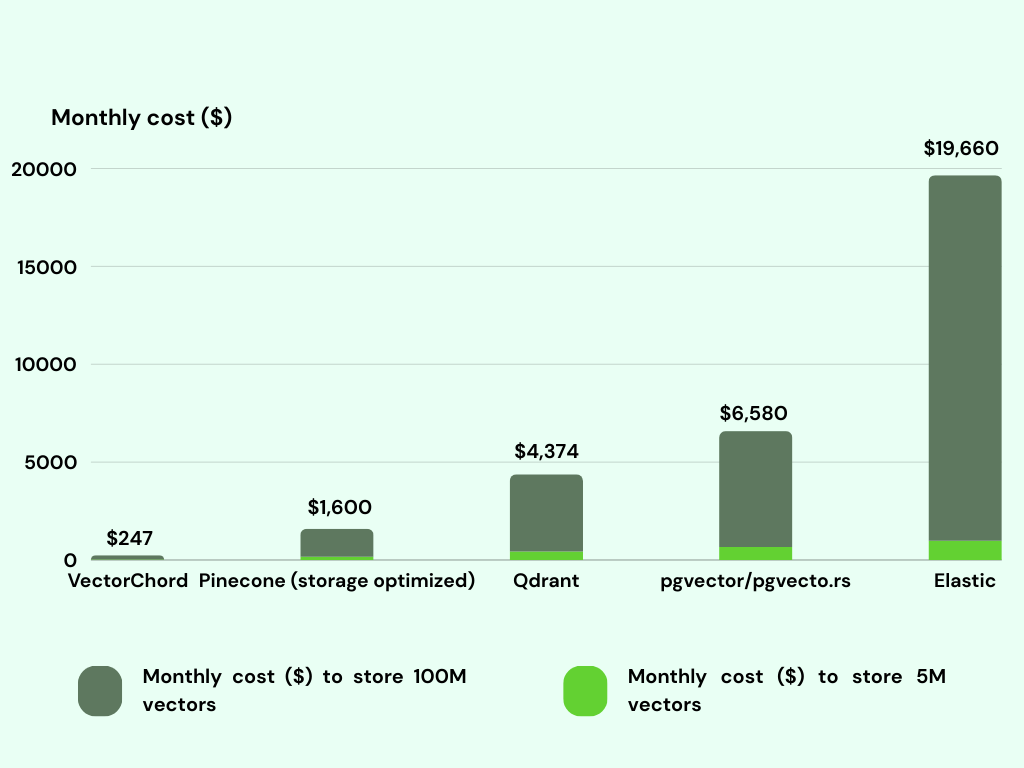
在基于 MyScale 基准测试数据的向量存储月度成本对比中,下图清晰地展示了 VectorChord 极具竞争力的性价比——存储 1 亿条向量的月均成本仅需 247 美元。相比之下,尽管 Pinecone 采用了优化型存储,其月成本仍高达 1,600 美元;Qdrant 的月成本为 4,374 美元;而 pgvector/pgvecto.rs 的成本则更高,达到每月 6,580 美元。
上述价格基准测试于 2024 年 12 月 5 日执行。我们正在持续提升性能并优化成本。例如,VectorChord 0.2 在前代版本的基础上将索引体积缩减了 30%,并将索引构建速度提升了 50%。如果您想了解最新的基准测试数据,欢迎通过 Discord 联系我们。
2 - 性能基准测试
本文展示了我们将 VectorChord 实现与其他主流向量数据库进行全面对比的基准测试结果,重点考察 QPS(每秒查询数)与可扩展性。如果您对我们的技术实现细节感兴趣,请参阅我们的博文《VectorChord:在 PostgreSQL 中仅需 1 美元存储 400k 向量》。
QPS
LAION 5M
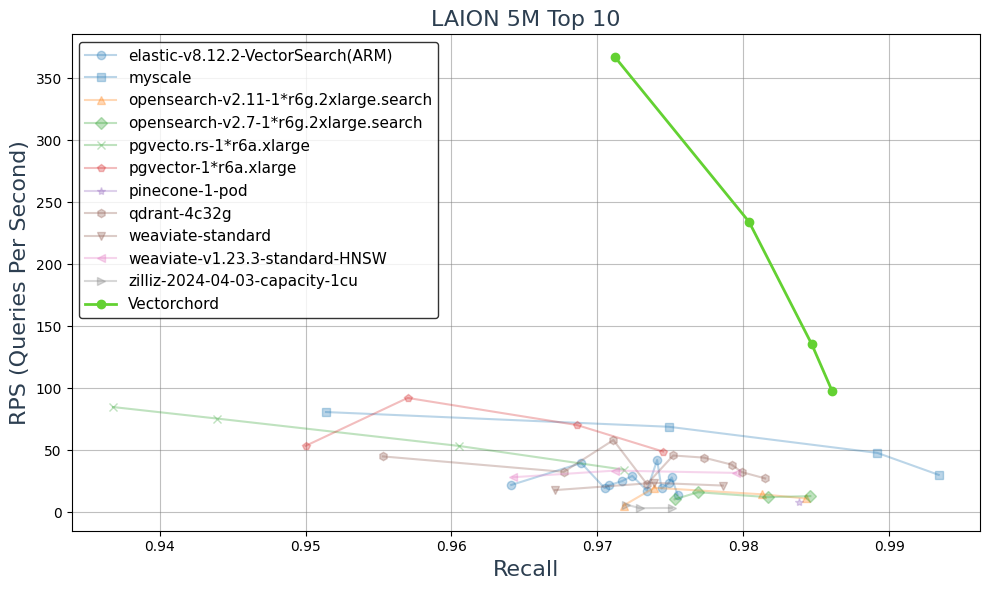
在 LAION 5M 数据集上,在达到 0.95 召回率的前提下,VectorChord 取得了比 MyScale、pgvector、Pinecone、Weaviate、Qdrant 和 Zilliz(Milvus)等各类向量数据库高出 3 倍以上的 QPS。
i4i.xlarge 上的 LAION 100M
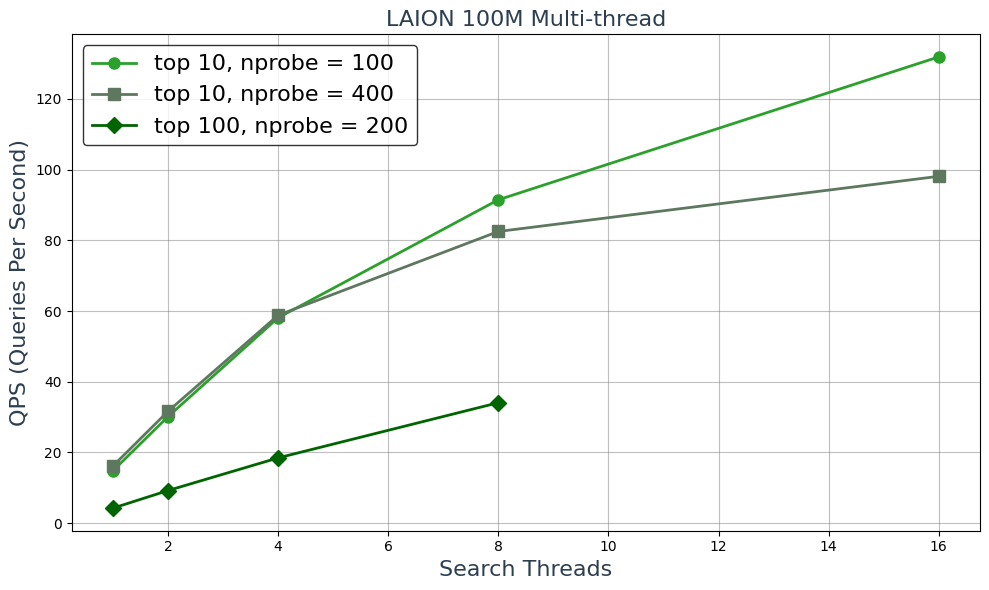
该测试环境配置为 4 核 CPU、32 GB 内存,并使用 937 GB 的 SSD 存储来容纳 1 亿条向量。在单线程查询下,我们在 Top-10 召回率达到 0.95 时实现了 16.2 的 QPS,在 Top-100 召回率达到 0.95 时实现了 4.3 的 QPS。这一表现令人印象深刻。
可扩展性
如果您对 VectorChord 的水平扩展能力感兴趣,请参阅我们的博文《使用 VectorChord 在 PostgreSQL 中实现 10,000 QPS 的向量检索》。
LAION 100M 与 LAION 5M
| 数据集 | 达到 10,000+ QPS 的最低硬件配置 | vCPU 数量 | 预估月度成本 |
|---|---|---|---|
| LAION-5m | r7i.xlarge × 7 | 4 × 7 = 28 vcpu | $0.2646 × 7 × 720 = $1334 |
| LAION-100m | r7i.16xlarge × 2 | 64 × 2 = 128 vcpu | $4.2336 × 2 × 720 = $6096 |
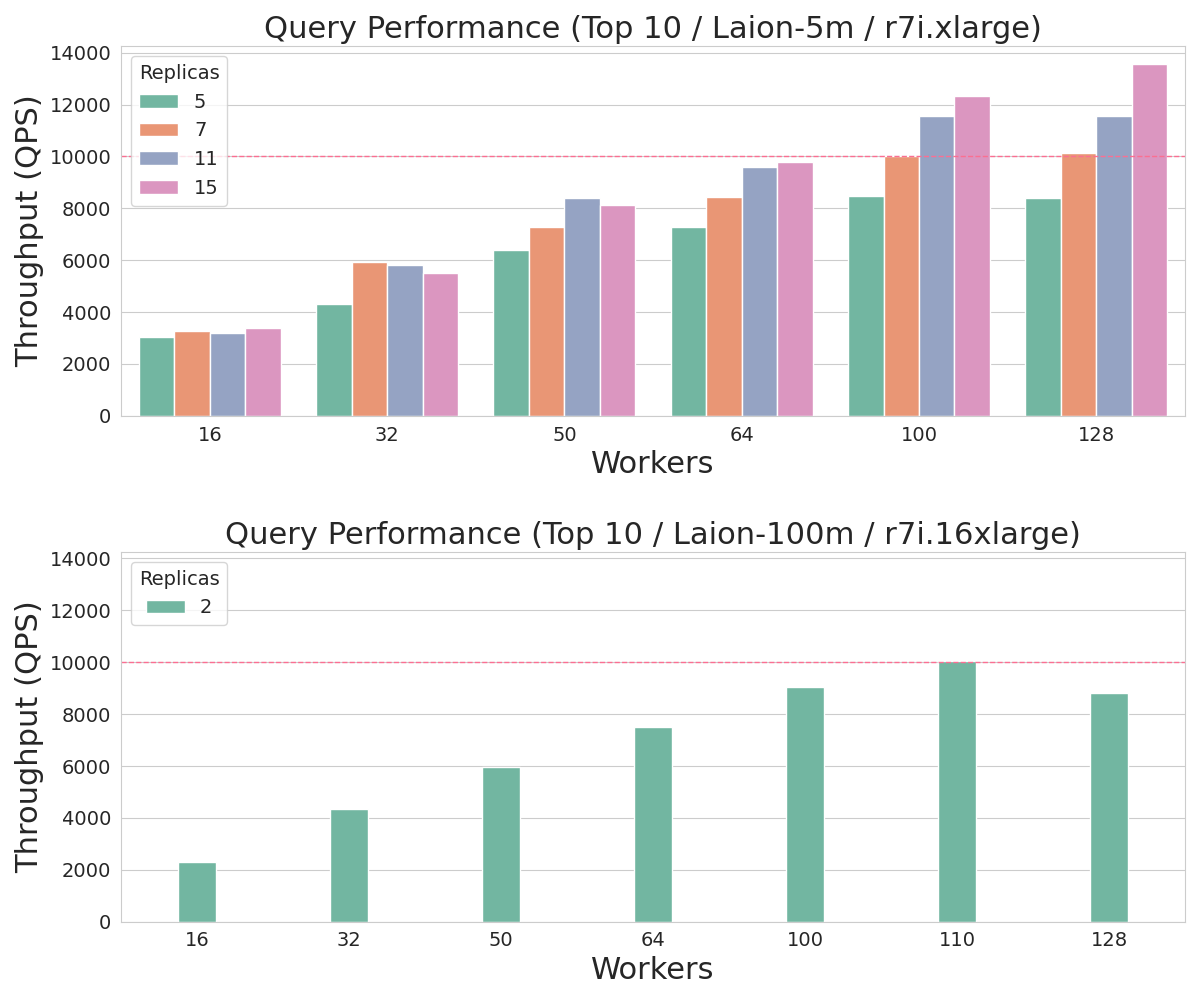
上述价格基准测试于 2024 年 12 月 5 日执行。我们正在持续提升性能并优化成本。例如,VectorChord 0.2 在前代版本的基础上将索引体积缩减了 30%,并将索引构建速度提升了 50%。如果您想了解最新的基准测试数据,欢迎通过 Discord 联系我们。
3 - 与 pgvector 的基准测试对比
在本节中,我们将 VectorChord 与提供向量相似性检索能力的 PostgreSQL 扩展 pgvector 进行对比。我们将重点关注四个核心指标:QPS(每秒查询数)、Recall@100(Top-100 召回率)、索引构建时间(Index Building Time)以及数据插入时间(Insertion Time)。如果您对我们的实现细节感兴趣,请参阅我们的博文《PostgreSQL 上的向量检索:内存与磁盘方案的对比分析》。
QPS 与召回率
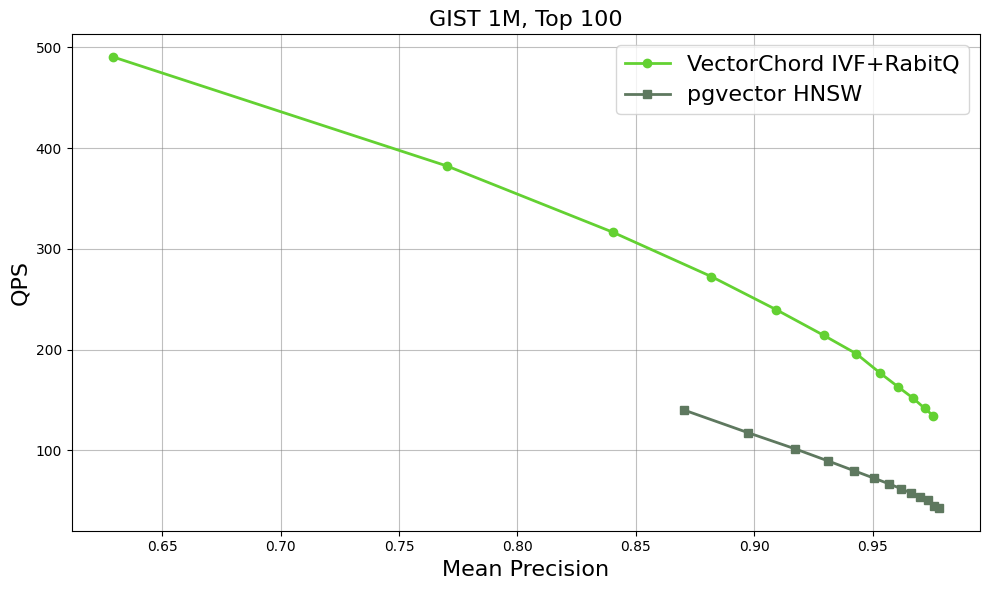
上方展示了在 GIST 数据集(包含 100 万条 960 维向量)上的初步基准测试结果。在相同的召回率水平下,VectorChord 的 QPS 可达 pgvector 的两倍。更多详情将在基准测试章节中展开说明。
索引构建时间、插入时间与查询完成时间
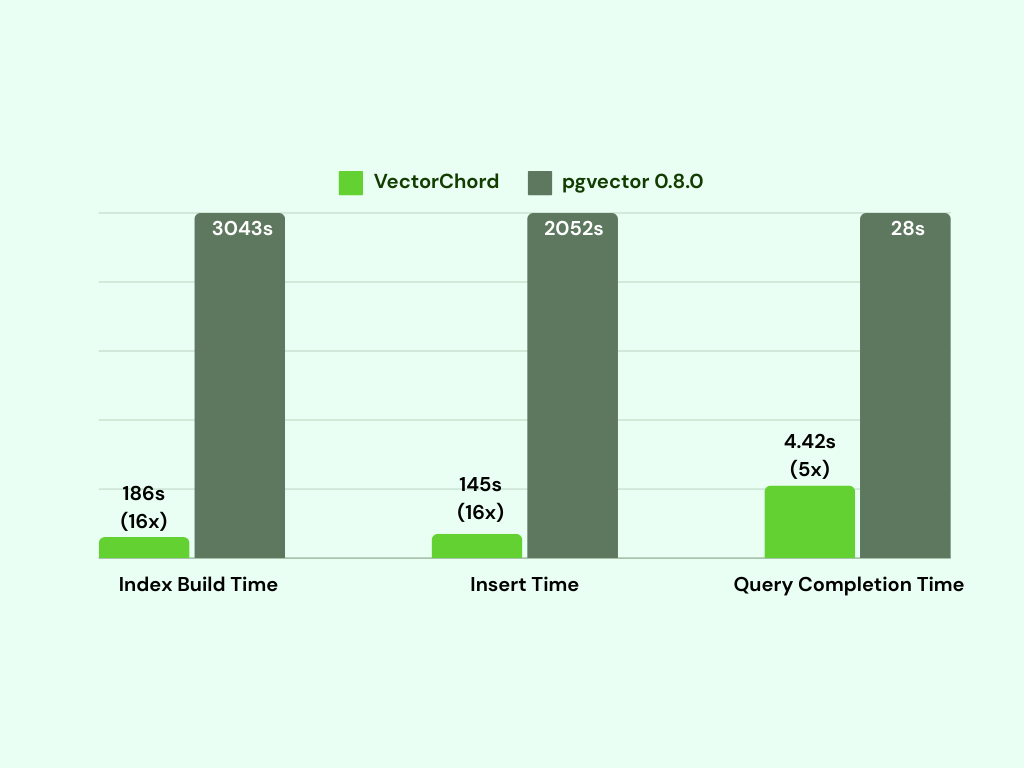
通过利用独立的机器执行 KMeans 聚类,VectorChord 仅需 186 秒即可完成索引构建,速度比 pgvector 快 16 倍。此外,其数据插入速度也比 pgvector 快 14 倍。众所周知,构建索引是向量数据库中资源消耗最密集的环节,需要大量的计算资源,并会显著推高对 CPU 和内存的需求。通过利用算力更强的机器在外部完成索引构建,再将其导入至小规格机器中提供查询服务,在单台机器上支撑数十亿级向量的检索将成为可能。
4 - 与 Elasticsearch 的基准测试对比
本文展示了我们将 VectorChord-BM25 实现与 Elasticsearch 进行全面对比的基准测试结果,重点考察两个核心指标:QPS(每秒查询数)与 NDCG@10(前 10 位结果的归一化折损累计增益)。如果您对我们的技术实现细节感兴趣,请参阅我们的博文《VectorChord-BM25:以比 Elasticsearch 快 3 倍的 BM25 排序彻底革新 PostgreSQL 搜索》。
RPS
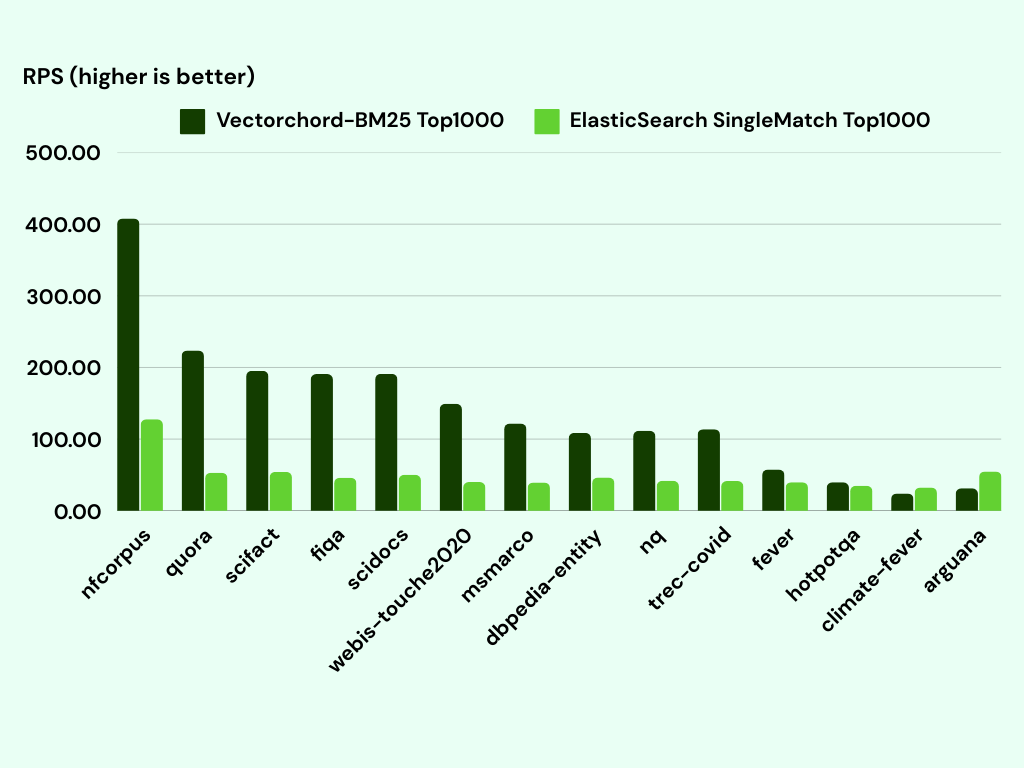
我们在来自 bm25-benchmarks 的多个数据集上,对比了我们的实现与 Elasticsearch 的 Top-1000 每秒查询数(QPS)——该指标衡量系统在为每次查询检索前 1000 条结果时每秒能够处理的查询数量。在所有测试数据集上,我们的实现平均取得了 比 Elasticsearch 高出 3 倍的 QPS,充分展现了其卓越的执行效率与可扩展性。
NDCG@10
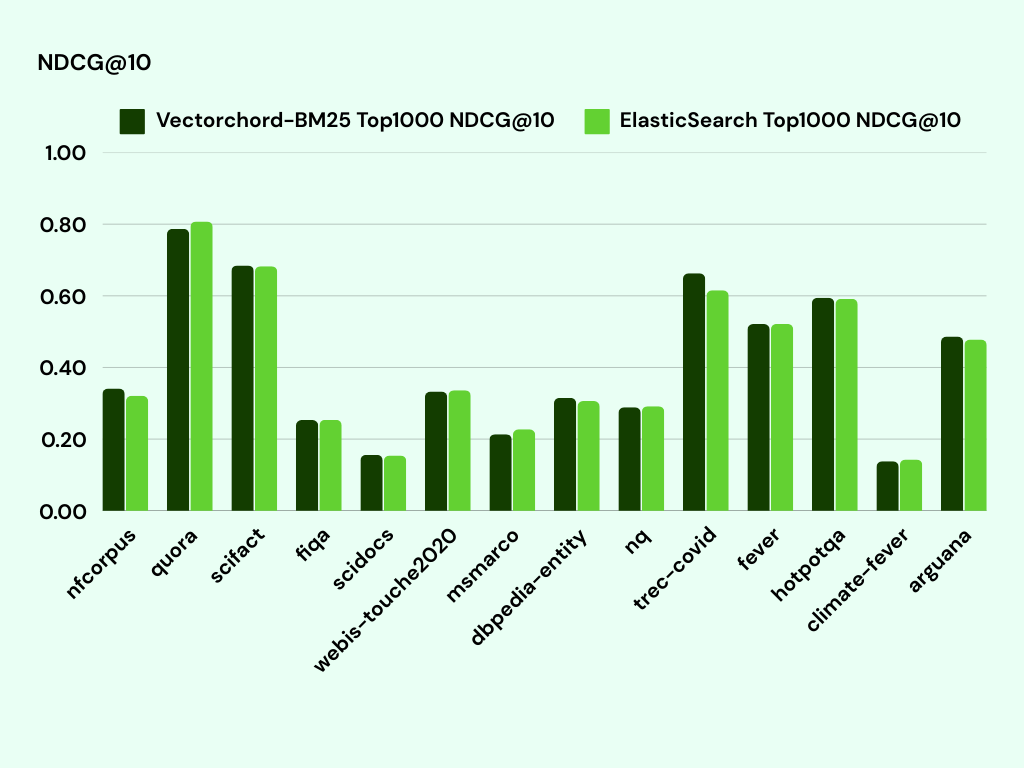
我们投入了大量精力使 VectorChord-BM25 的评分行为与 Elasticsearch 保持对齐,以确保对比的公平性与准确性。如上表所示,我们的实现在绝大多数数据集上均取得了与 Elasticsearch 相当的 NDCG@10 得分,甚至在部分数据集(如 trec-covid 和 scifact)上超越了 Elasticsearch。
5 - 与 pgvectorscale 的基准测试对比
在本节中,我们将 VectorChord 与提供向量相似性检索能力的 PostgreSQL 扩展 pgvectorscale 进行对比。我们将重点关注四个核心指标:QPS(每秒查询数)、Recall@10/100、索引构建时间(Index Building Time)以及数据插入时间(Insertion Time),并同时探讨内存与磁盘场景下的性能表现。如果您对我们的实现细节感兴趣,请参阅我们的博文《PostgreSQL 上的向量检索:内存与磁盘方案的对比分析》。
QPS 与召回率
内存表现
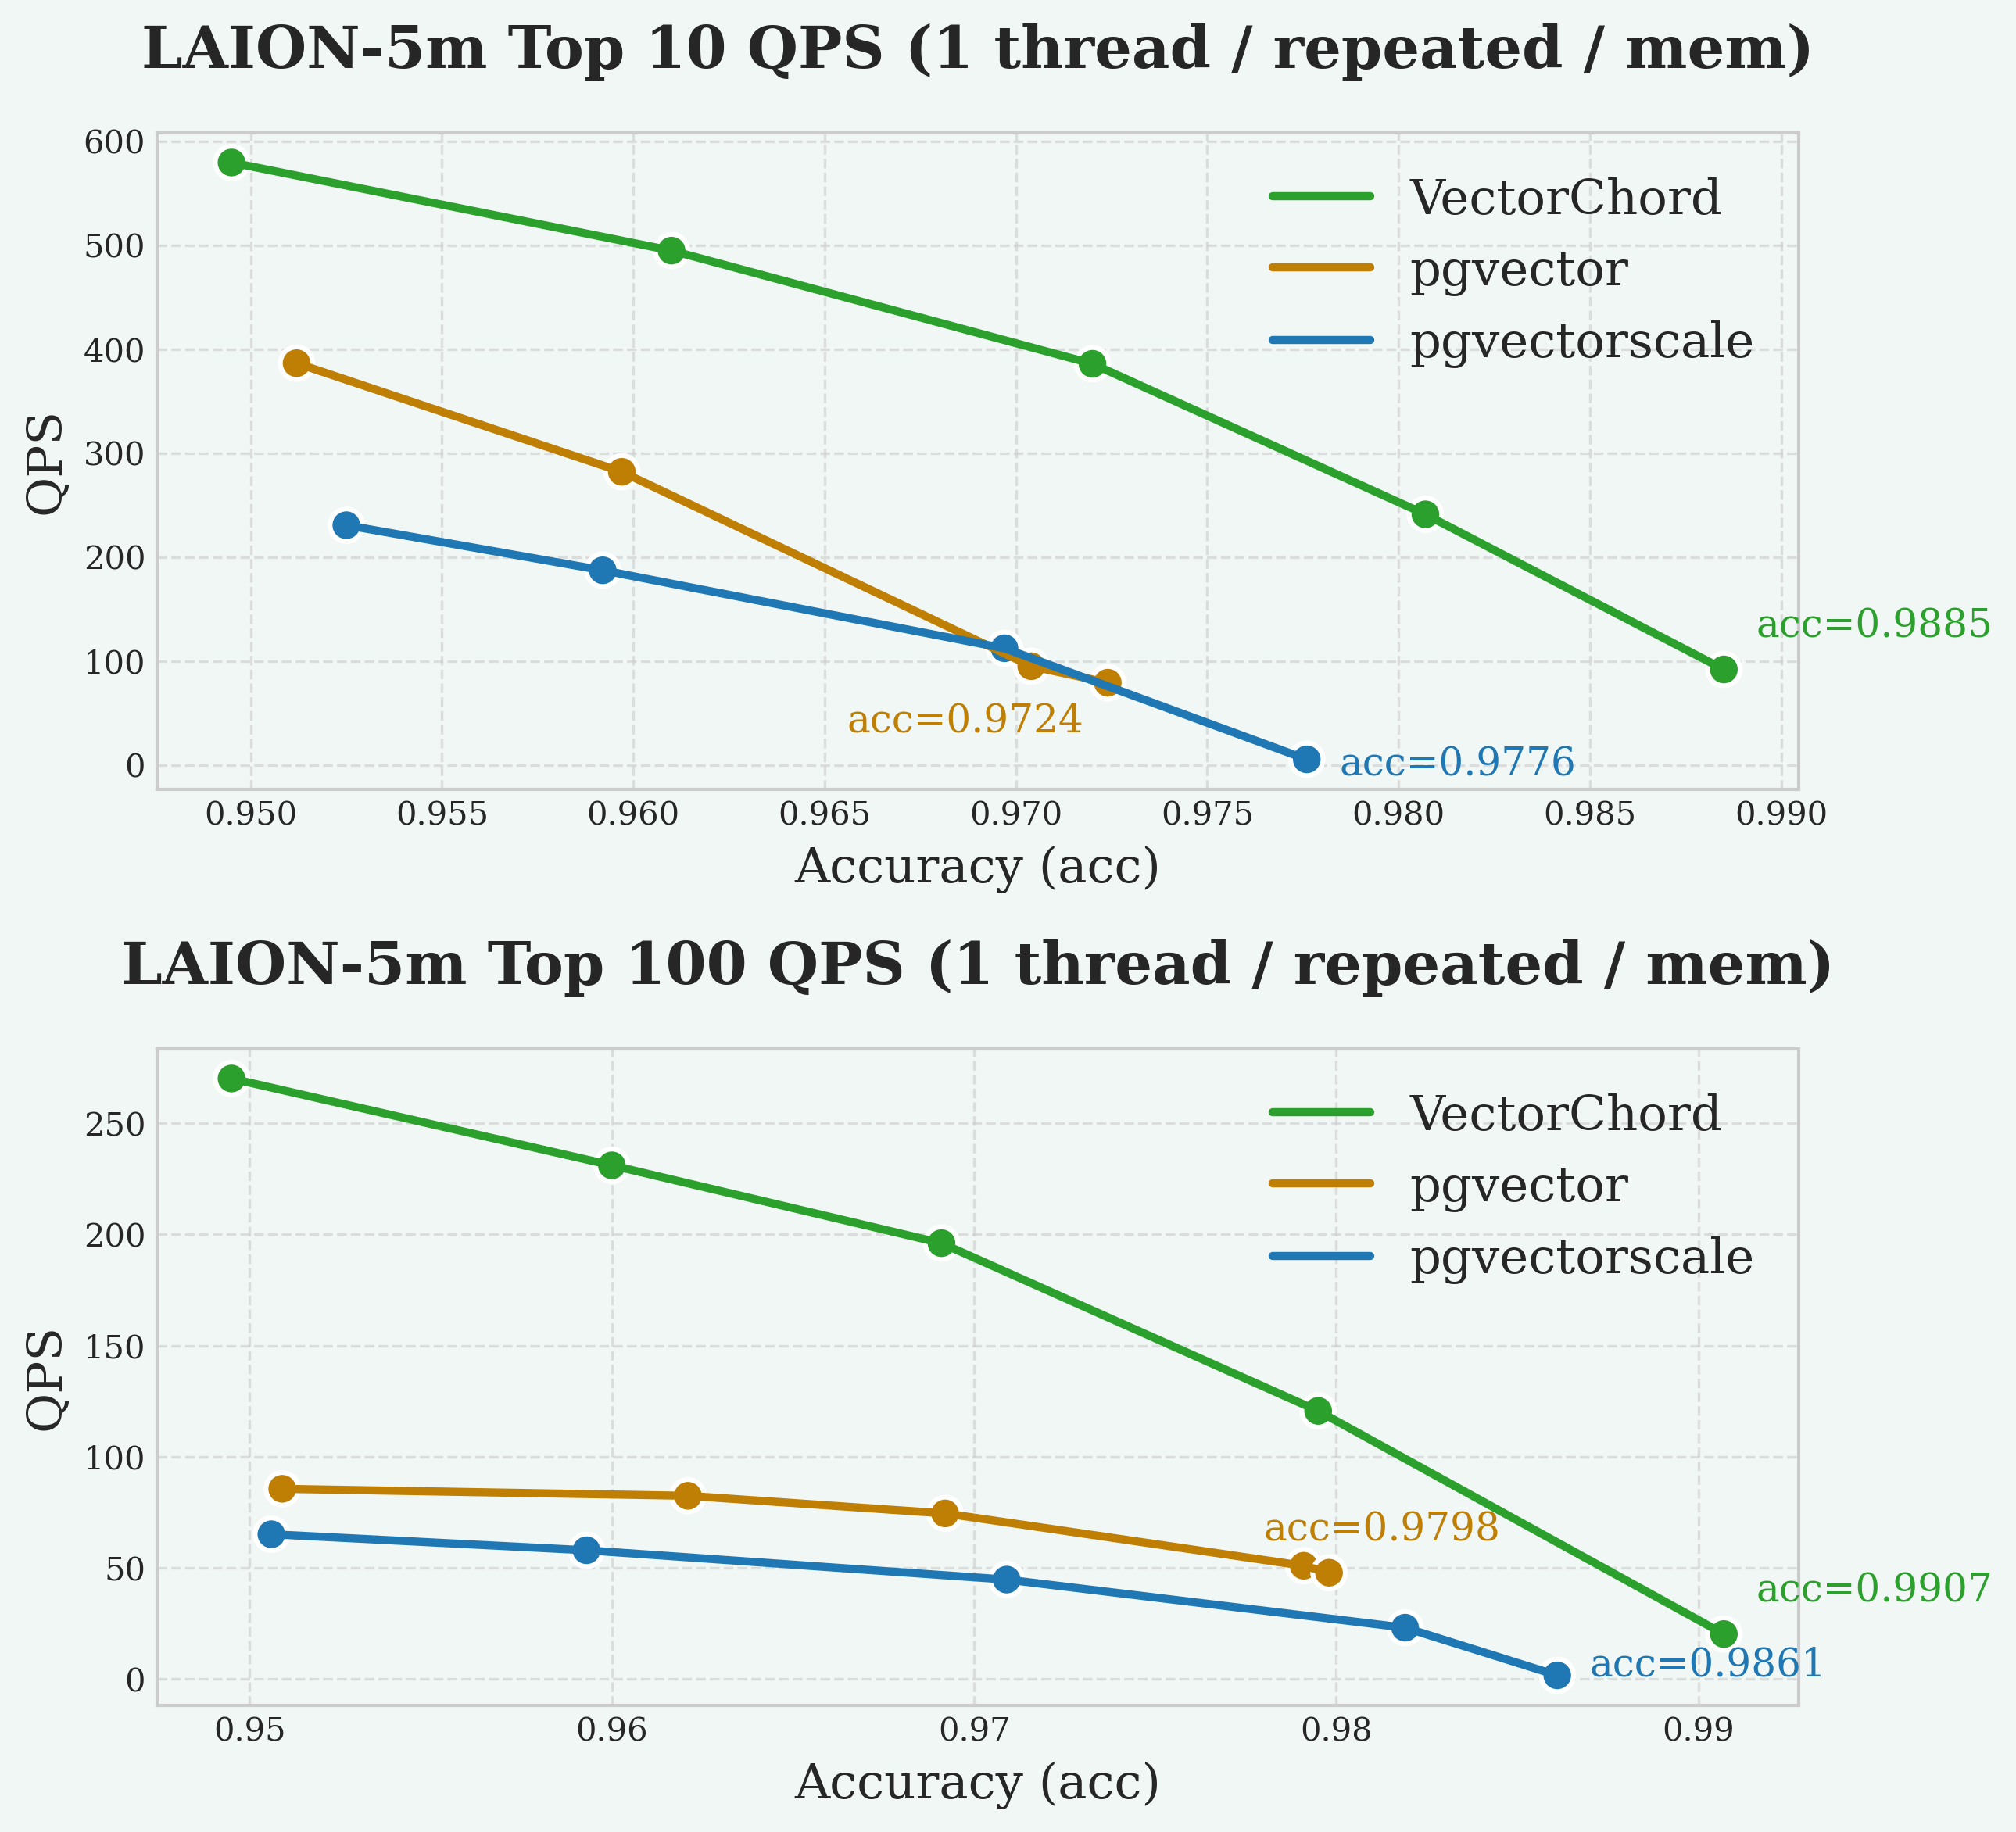
上图展示了查询速度(QPS)与检索质量(Recall@10/100)之间的权衡关系。Recall@10 衡量在前 10 个返回结果中找到真实最近邻向量的比例。通常情况下,牺牲一定的召回率可以换取更高的 QPS,反之亦然。更优秀的系统能够在相同 QPS 下实现更高的召回率,或在相同召回率水平下提供更高的 QPS。我们的目标通常是在保持高召回率目标(例如 95%)的前提下最大化 QPS。
磁盘表现
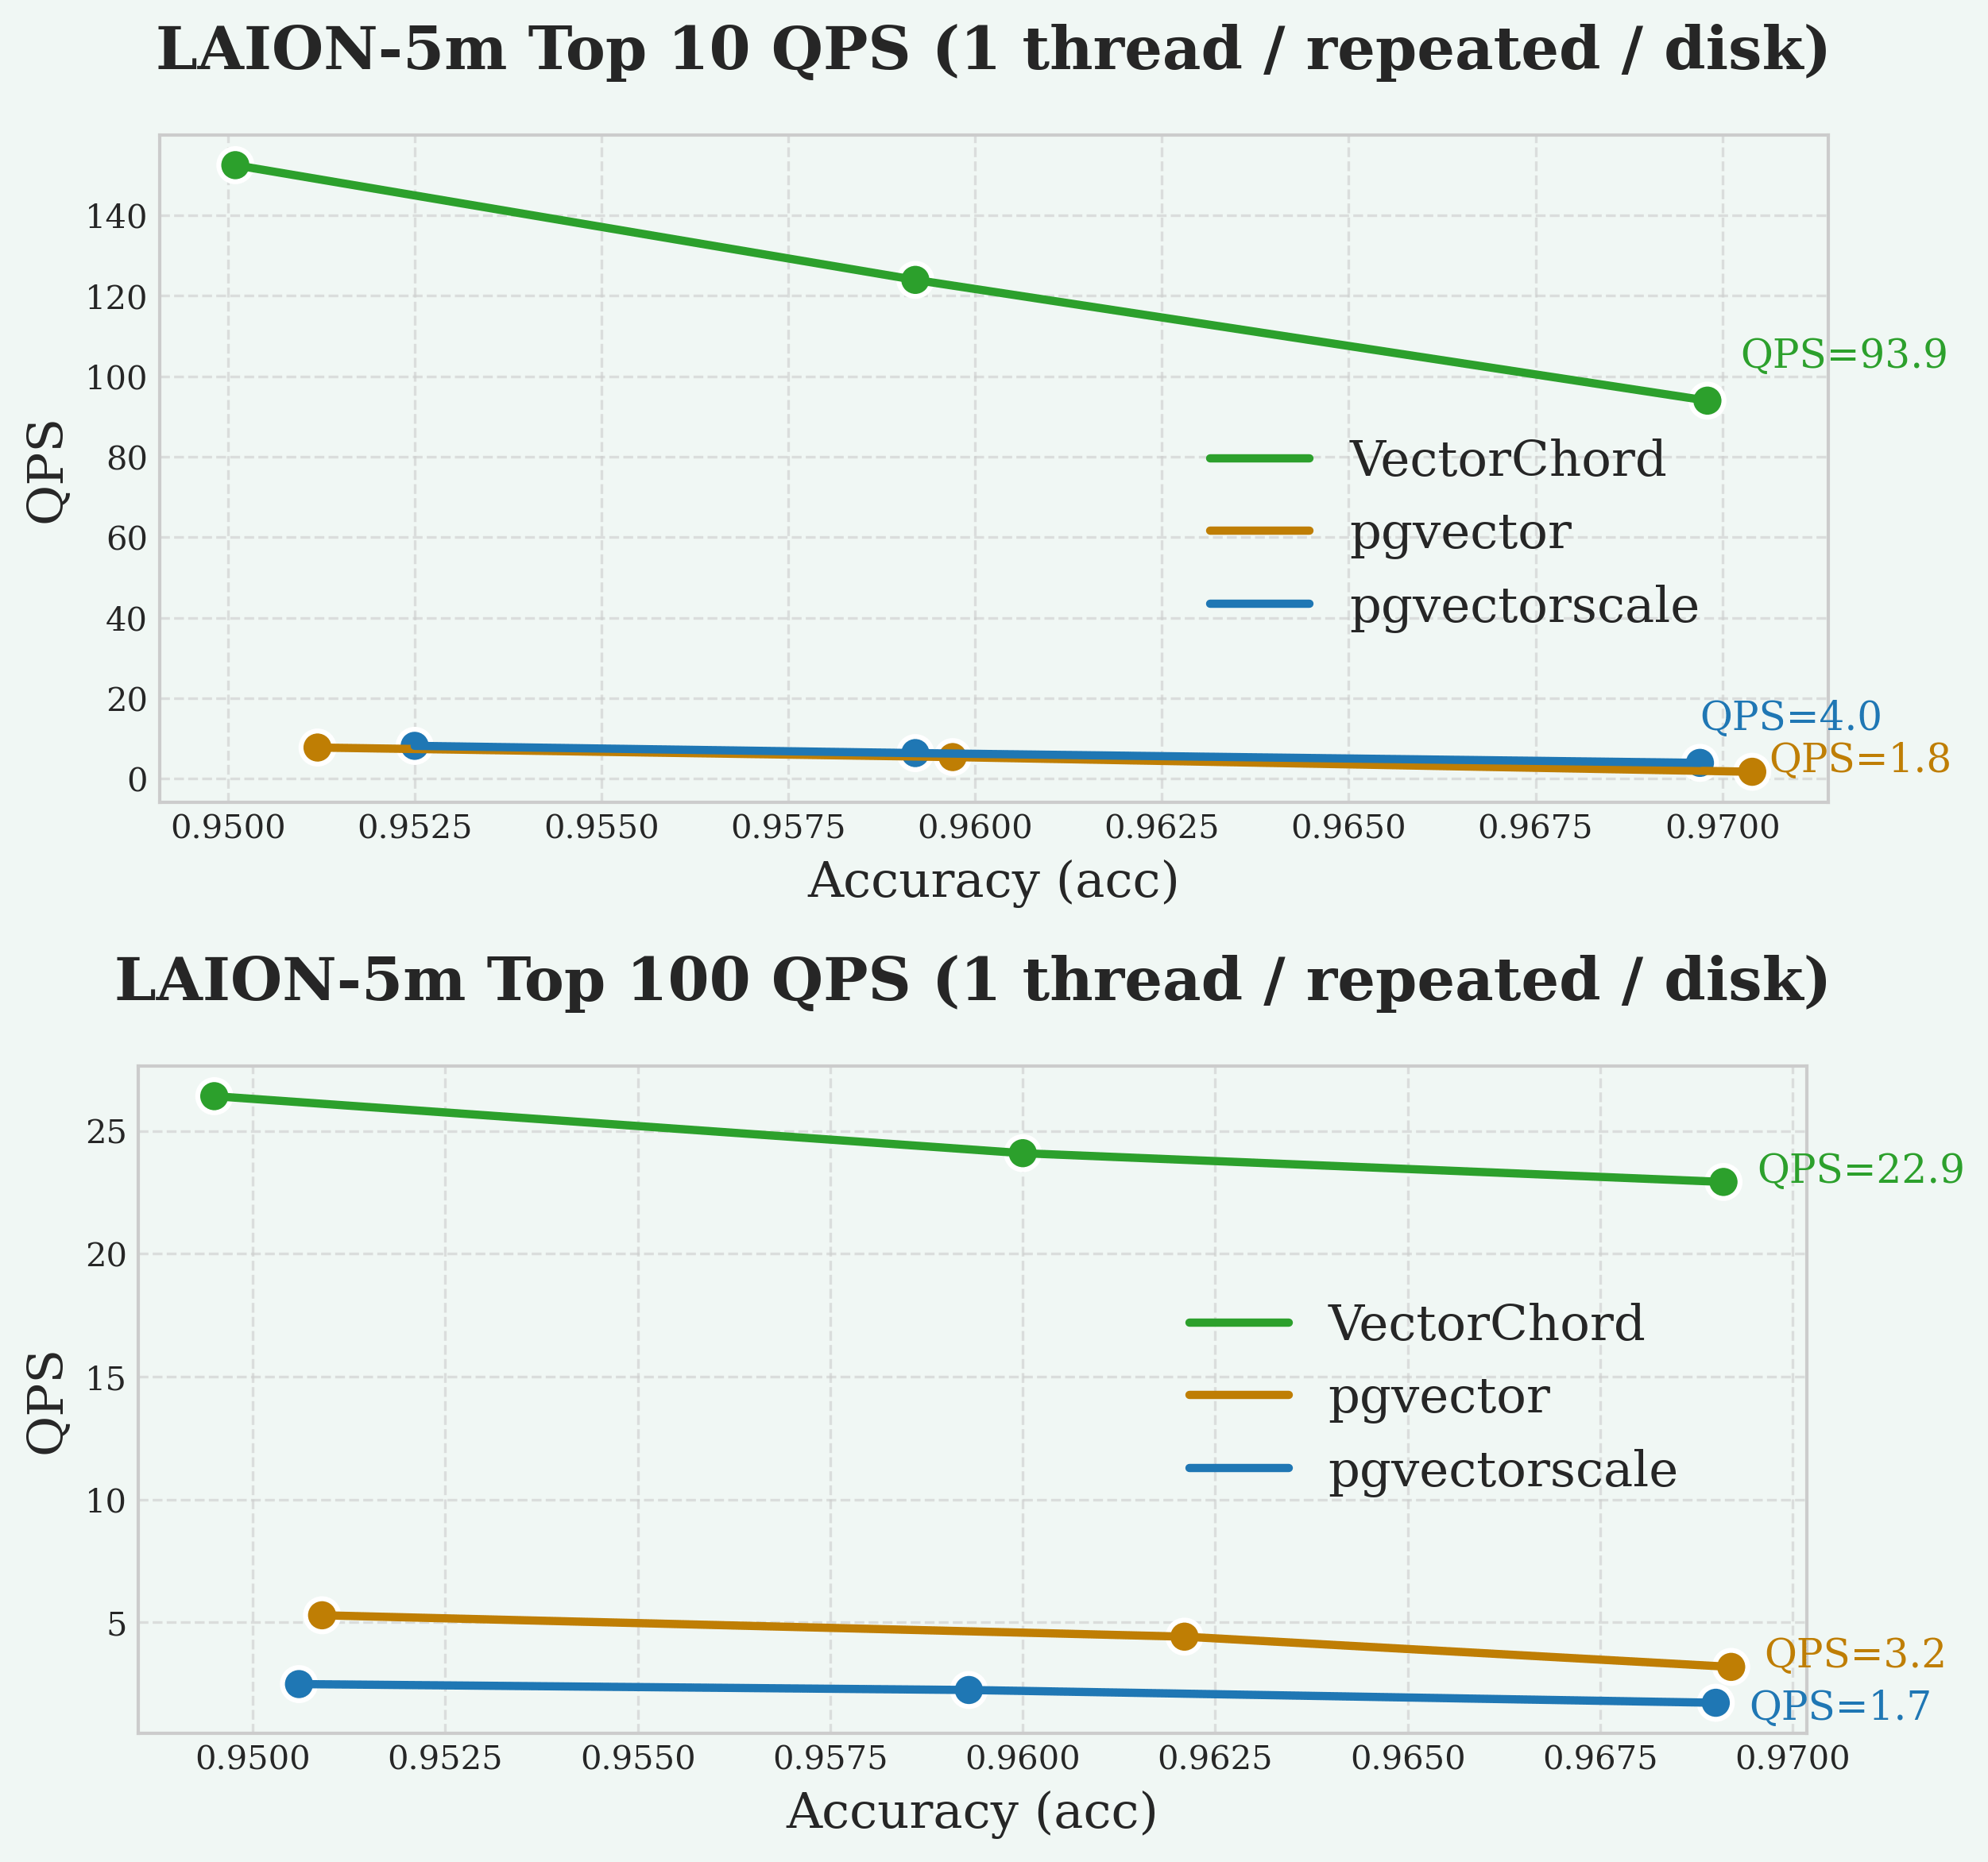
一如既往,在高召回率区间(例如 Recall@10 > 95%),VectorChord 始终能够取得高于其他扩展的 QPS,而 pgvector 与 pgvectorscale 的 QPS 表现则较为接近,位列其后。
索引构建
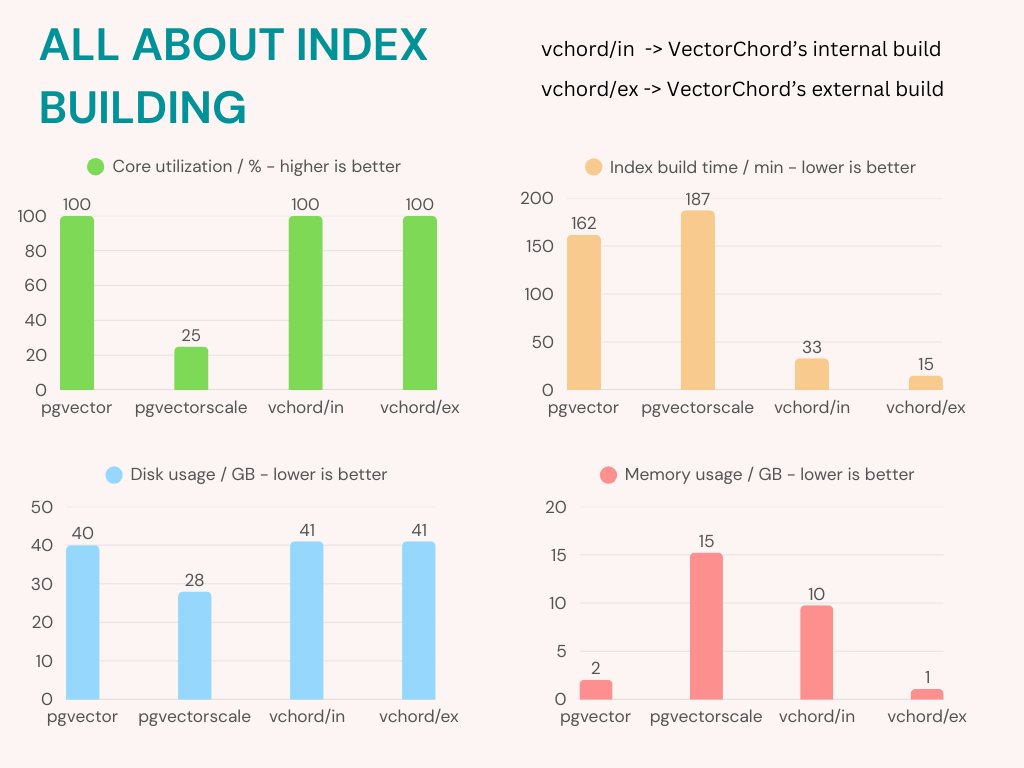
与 pgvectorscale 相比,VectorChord 能够更充分地利用 CPU 资源、减少内存占用,并大幅缩短索引构建时间。
数据插入时间
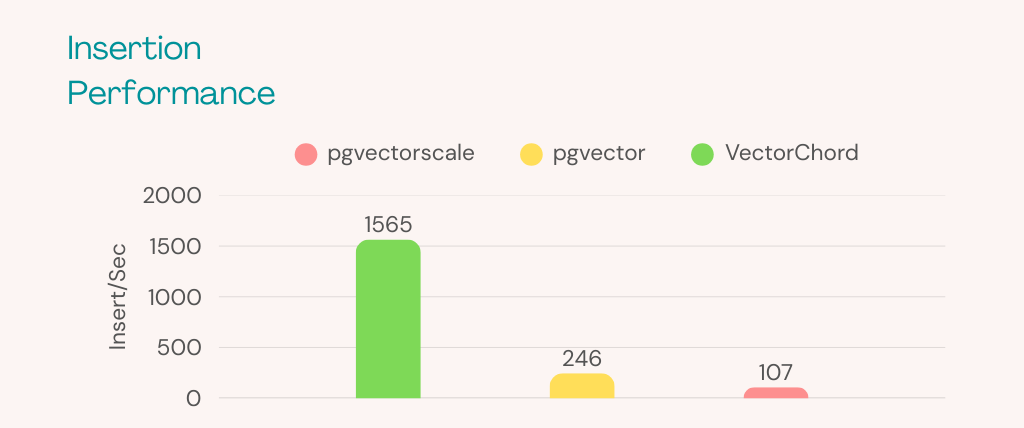
如图所示,在数据插入性能方面,VectorChord (1565 次插入/秒) 的表现远超 pgvector (246 次插入/秒) 和 pgvectorscale (107 次插入/秒)。对于大多数工作负载而言,100 次插入/秒已经足够;但如果您在生产环境中需要持续高频地写入大量向量(例如达到 500 次插入/秒),其他扩展的写入瓶颈就会成为一个棘手的问题。