跳转到主要内容

这是本节的多页打印视图。 .

返回本页常规视图.

VectorChord Cloud 文档

全托管 PostgreSQL 向量数据库服务参考文档:集群置备、连接池、监控、Terraform 与计费。

VectorChord Cloud 参考文档,涵盖账户注册与引导、psql 与连接池连接、Prometheus 指标采集、集群生命周期管理、Terraform Provider 集成以及计费管理。

1 - 快速入门

注册并启动您的第一个 VectorChord Cloud 集群。

1.1 - 注册云账户

只需几秒即可注册 VectorChord Cloud 并免费开始使用。

只需几秒即可注册 VectorChord Cloud 并免费开始使用。

如需了解 Cloud 免费套餐包含的内容,请参阅 Cloud 免费套餐。如需了解 Cloud 的付费套餐选项,请参阅 Cloud 套餐。

注册

注册 VectorChord Cloud 非常简单。只需访问 https://cloud.vectorchord.ai 并使用您的 GitHub 账户注册即可。
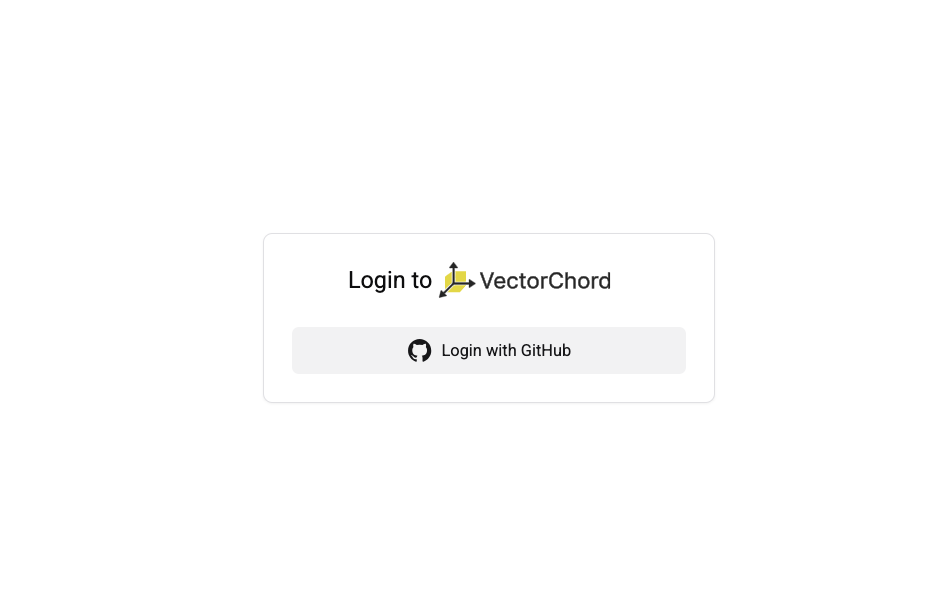
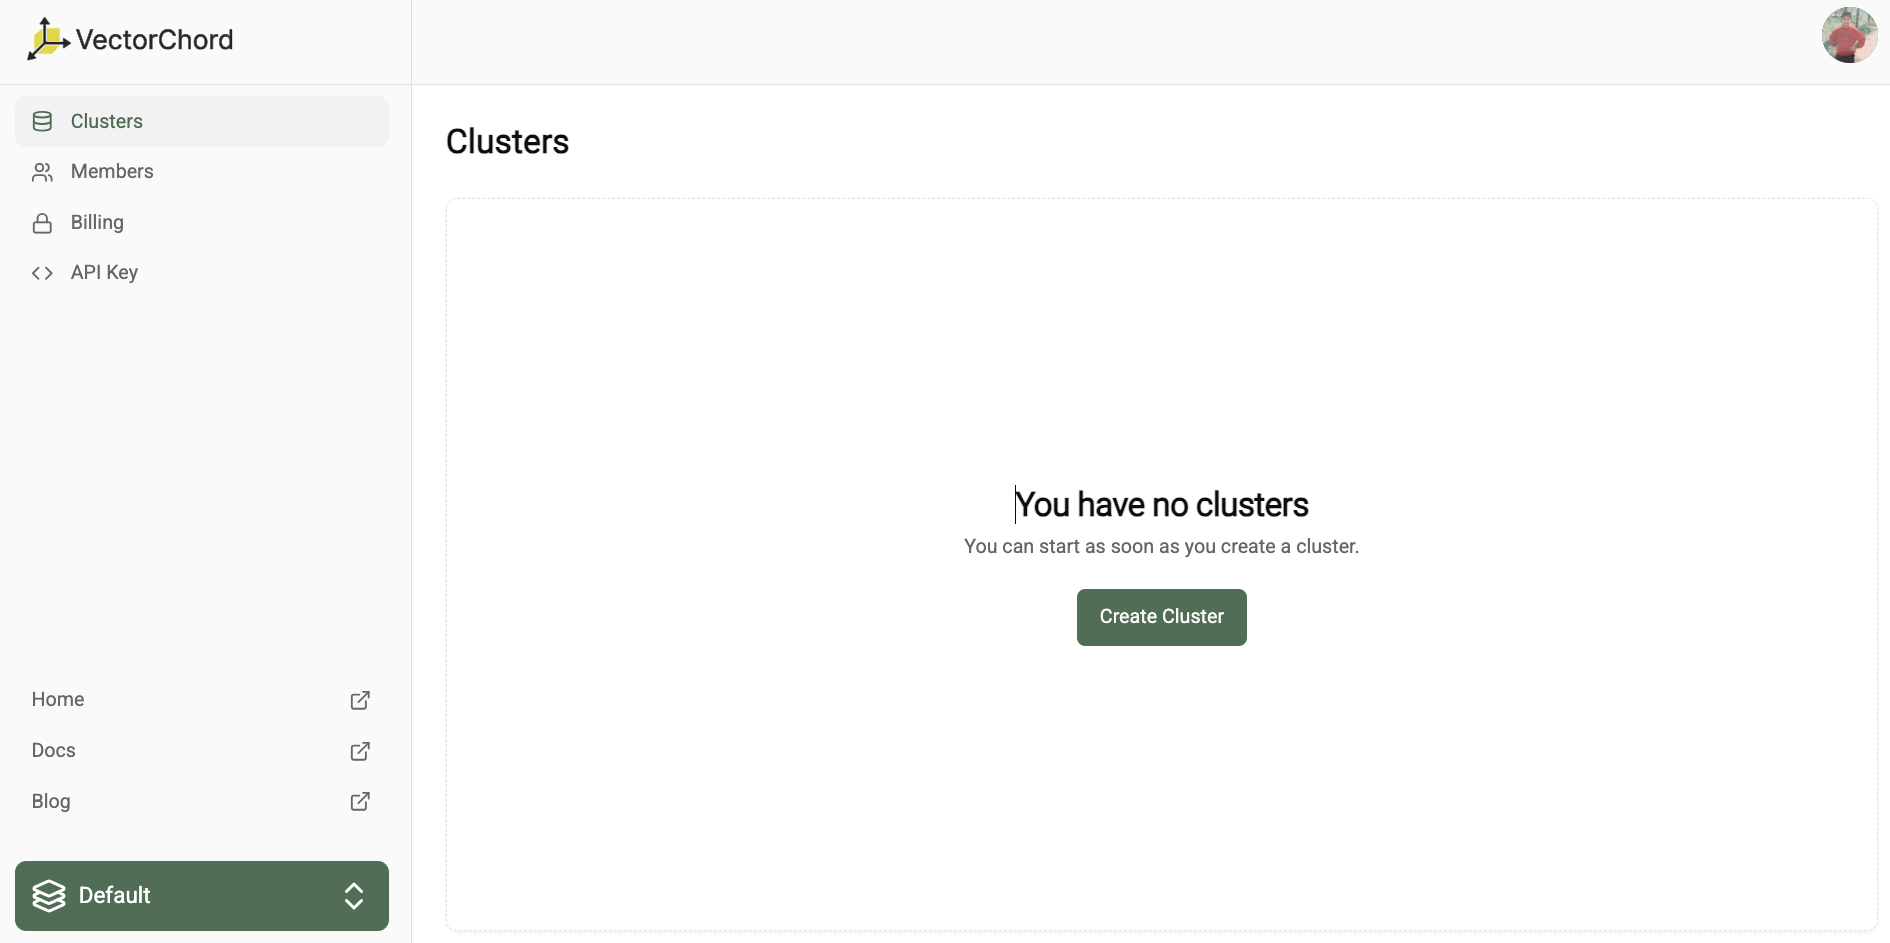
完成注册后,系统会将您引导至 VectorChord Cloud 控制台,并为您创建一个默认项目。
后续步骤

1.2 - 快速开始

本指南将帮助您快速上手 VectorChord Cloud。首先,您需要注册一个 VectorChord Cloud 账户。

本指南将帮助您快速上手 VectorChord Cloud。首先,您需要注册一个 VectorChord Cloud 账户。如果您还没有账户,可以在此处免费注册。

创建集群

提示

您需要先绑定信用卡,然后才能创建企业版(Enterprise)套餐集群。

要创建新集群,请前往 VectorChord Cloud 控制台并点击“Create Cluster”按钮。
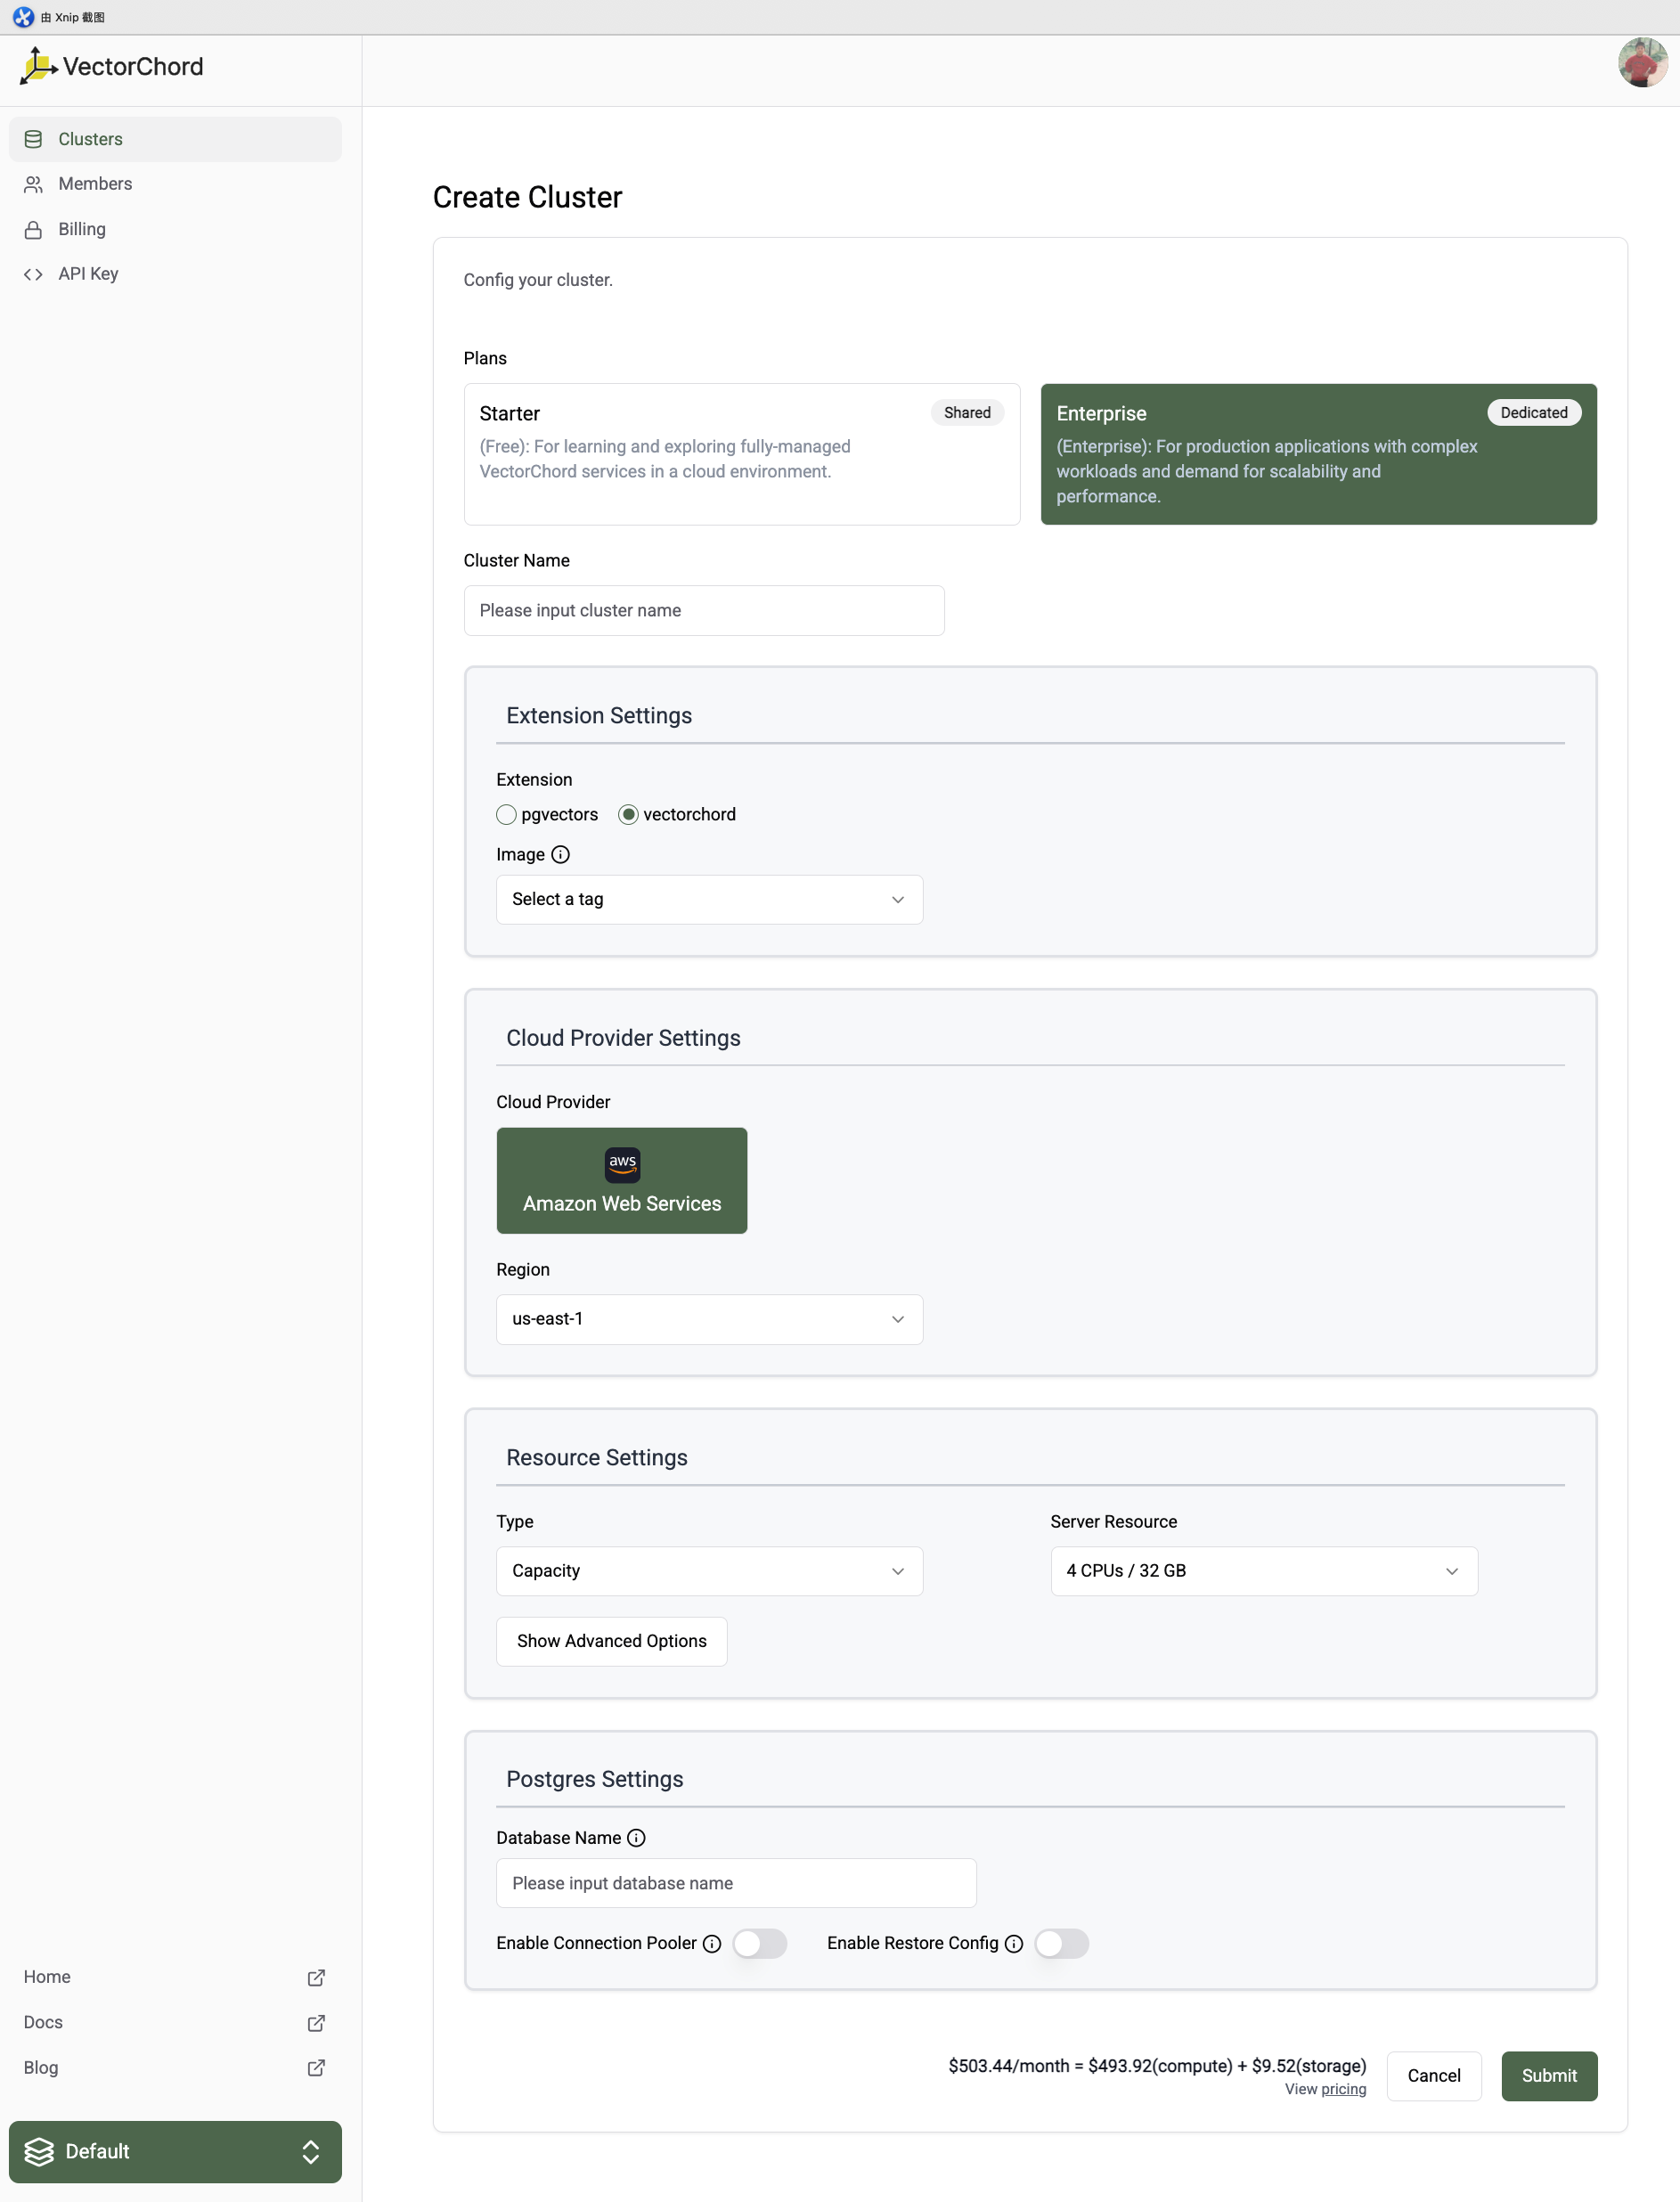
您需要指定以下信息:

  • 必填项:
    • Plan(套餐):您希望用于该集群的套餐。有关 Cloud 付费套餐选项的详细信息,请参阅 Cloud 套餐。
    • Cluster Name(集群名称):集群的唯一名称。
    • Extension Settings(扩展设置):
      • Extension(扩展):我们支持两种向量搜索扩展:pgvectors 及其继任者 vectorchord

        • vectorchord:Postgres 中可扩展、快速且磁盘友好的向量搜索扩展
        • pgvectors:Postgres 中可扩展、低延迟且支持混合搜索的向量搜索扩展。革新向量搜索,而非更换数据库。
        警告

        vectorchord 仅支持配备 NVMe SSD 的服务器资源规格。

      • Image(镜像):

        • 对于 VectorChord,我们提供语义化版本格式的标签,例如 16-v0.1.0:
          • 16 表示 Postgres 主版本号
          • v0.1.0 表示 VectorChord 版本号
        • 对于 pgvecto.rs,我们提供语义化版本格式的标签,例如 16-v0.4.0-vectors-exts:
          • 16 表示 Postgres 主版本号
          • v0.4.0 表示 pgvecto.rs 版本号
          • vectors 表示 pgvecto.rs schema 的安装位置,可选值为 vectors、extensions、public。如果您希望在 AWS RDS 上搭配使用 VectorChord Cloud,请选择 public。如果您打算在 Supabase 上使用 FDW,请选择 extensions。
          • exts 表示集群支持从 https://pgt.dev/ 安装扩展。
    • Cloud Provider Settings(云厂商设置):
      • Cloud Provider(云厂商):部署集群的云服务提供商,目前仅支持 AWS。
      • Region(区域):部署集群所在的区域。
    • Resource Settings(资源设置):
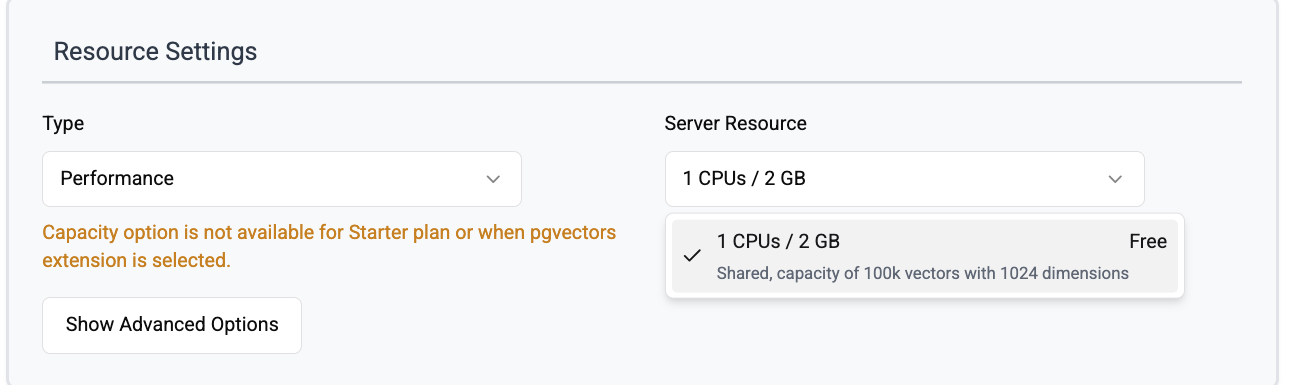
      • Type(类型):我们提供两种资源类型:Performance(性能型)和 Capacity(容量型)。
      • Server Resource(服务器资源规格):
        • Performance(性能型):
          • 1C/2G:免费套餐,1 核 CPU、2GB 内存和 3Gi 磁盘空间。
          • 2C/8G:企业版套餐,2 核 CPU、8GB 内存和 15Gi 磁盘空间。
          • 2C/16G:企业版套餐,2 核 CPU、16GB 内存和 15Gi 磁盘空间。
          • 4C/32G:企业版套餐,4 核 CPU、32GB 内存和 90Gi 磁盘空间。
        • Capacity(容量型):
          • 4C/32G NVMe SSD:企业版套餐,4 核 CPU、32GB 内存和 850Gi NVMe SSD 磁盘空间。
    • Postgres Settings(Postgres 设置):
      • Database Name(数据库名称):用于存储向量数据的数据库名称。
      • Enable Connection Pooler(启用连接池,默认值:false):为集群启用连接池。
      • Enable Restore Config(启用恢复配置,默认值:false):启用恢复配置,以从其他集群创建的备份进行恢复。
      • Optional(可选项):
        • Disk Size(磁盘大小):Postgres PGData 磁盘大小,将覆盖默认磁盘大小。
        • Instances(实例数):集群中的实例数量,默认值为 1。
        警告

        目前向量索引尚不支持流复制(Streaming Replication)。

集群信息

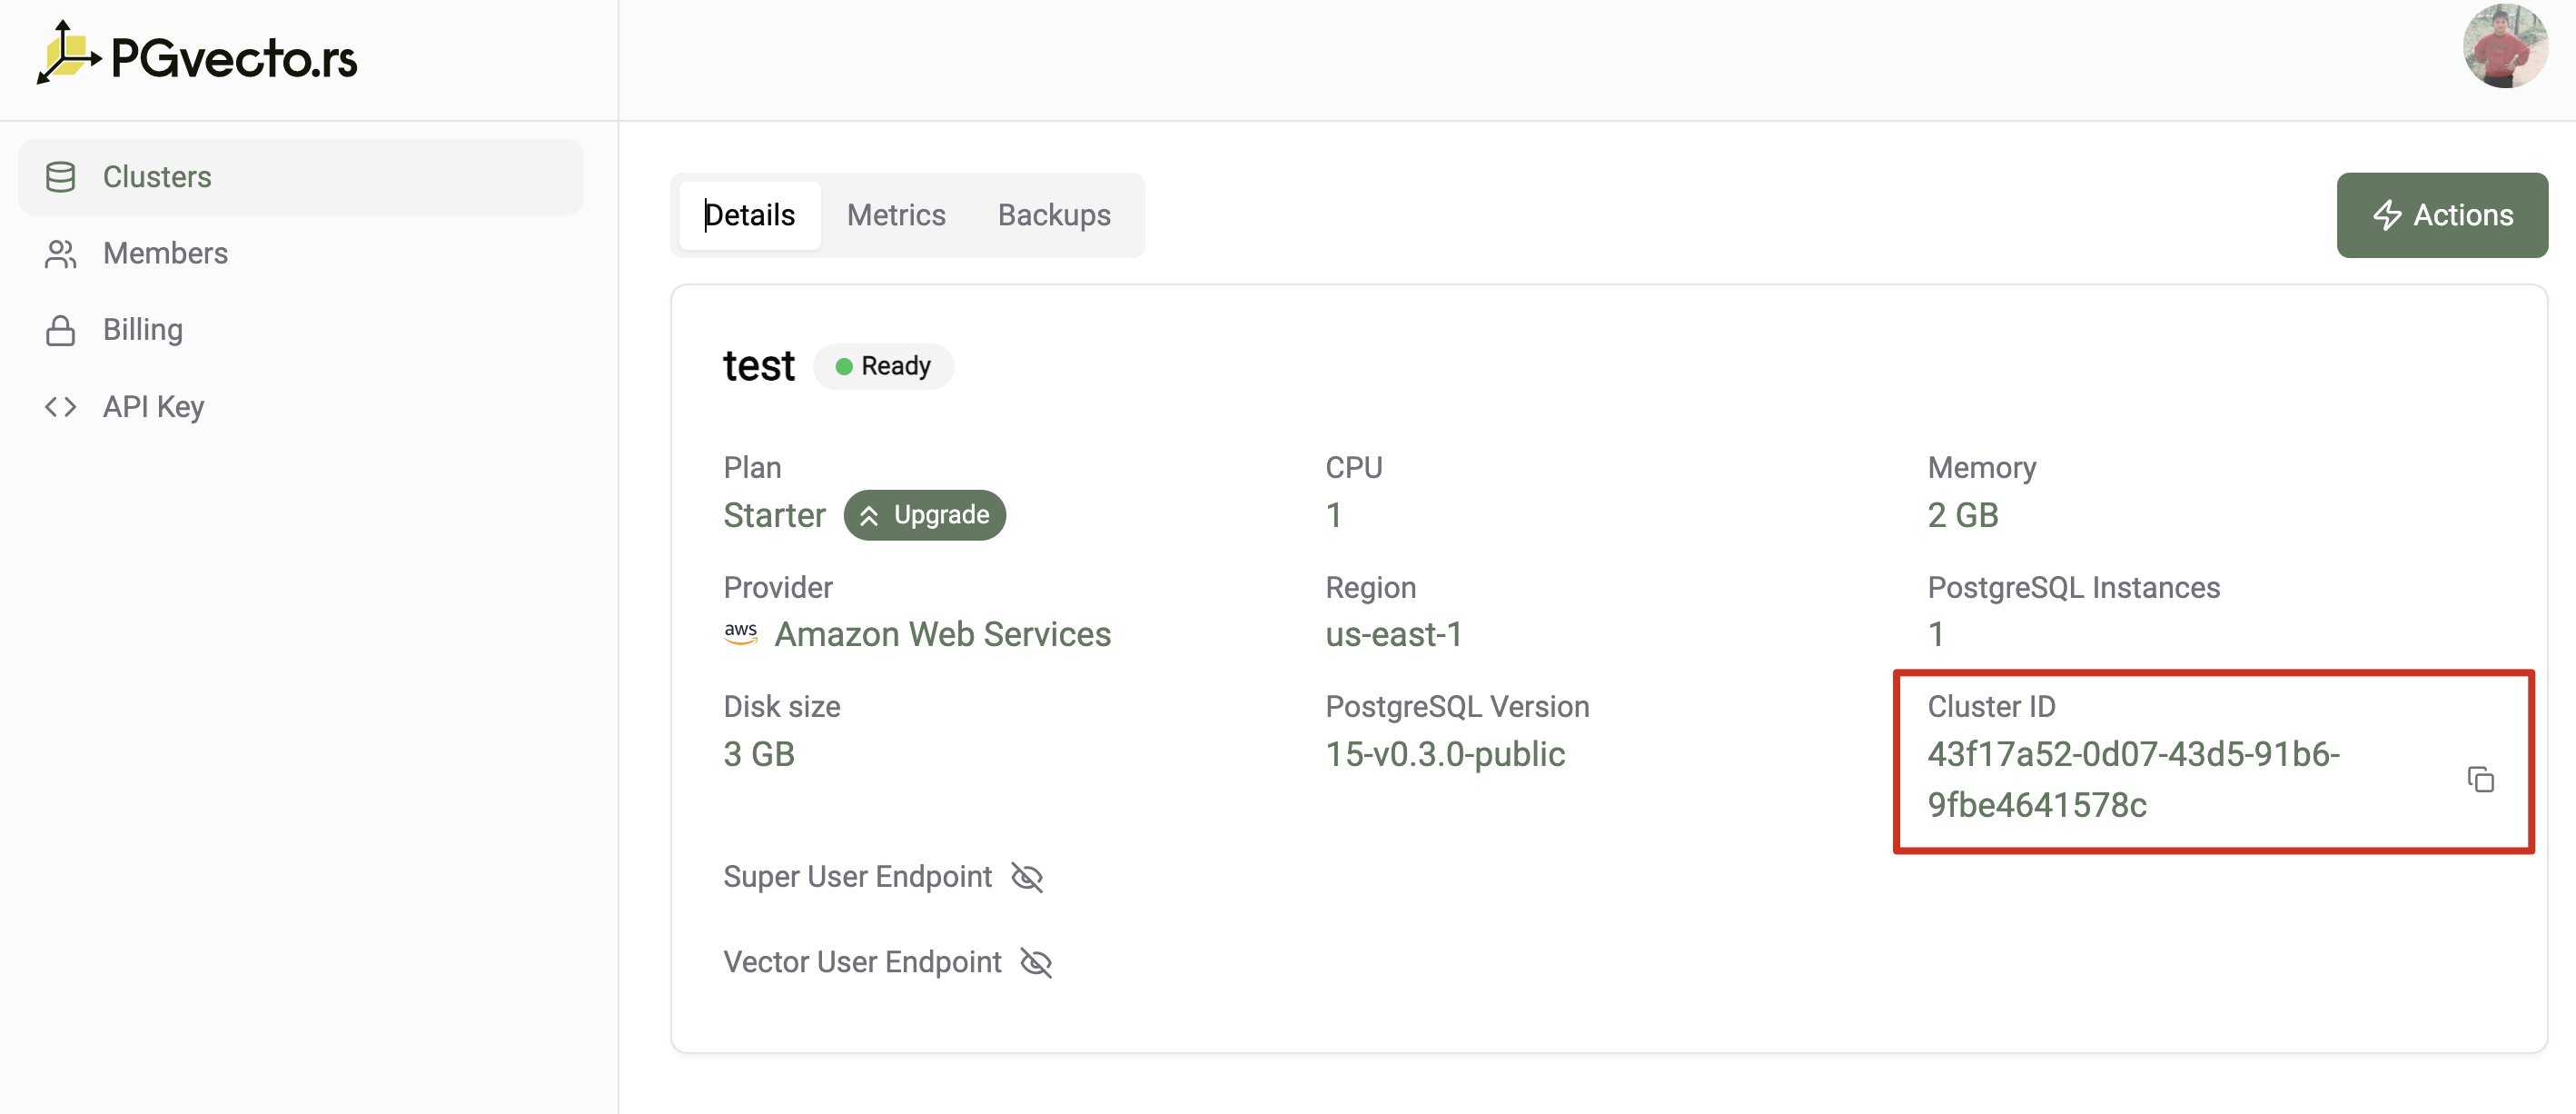
创建集群后,系统会将您引导至集群信息页面。在这里,您可以查看集群的详细信息,例如连接字符串、集群状态以及集群的资源使用情况。
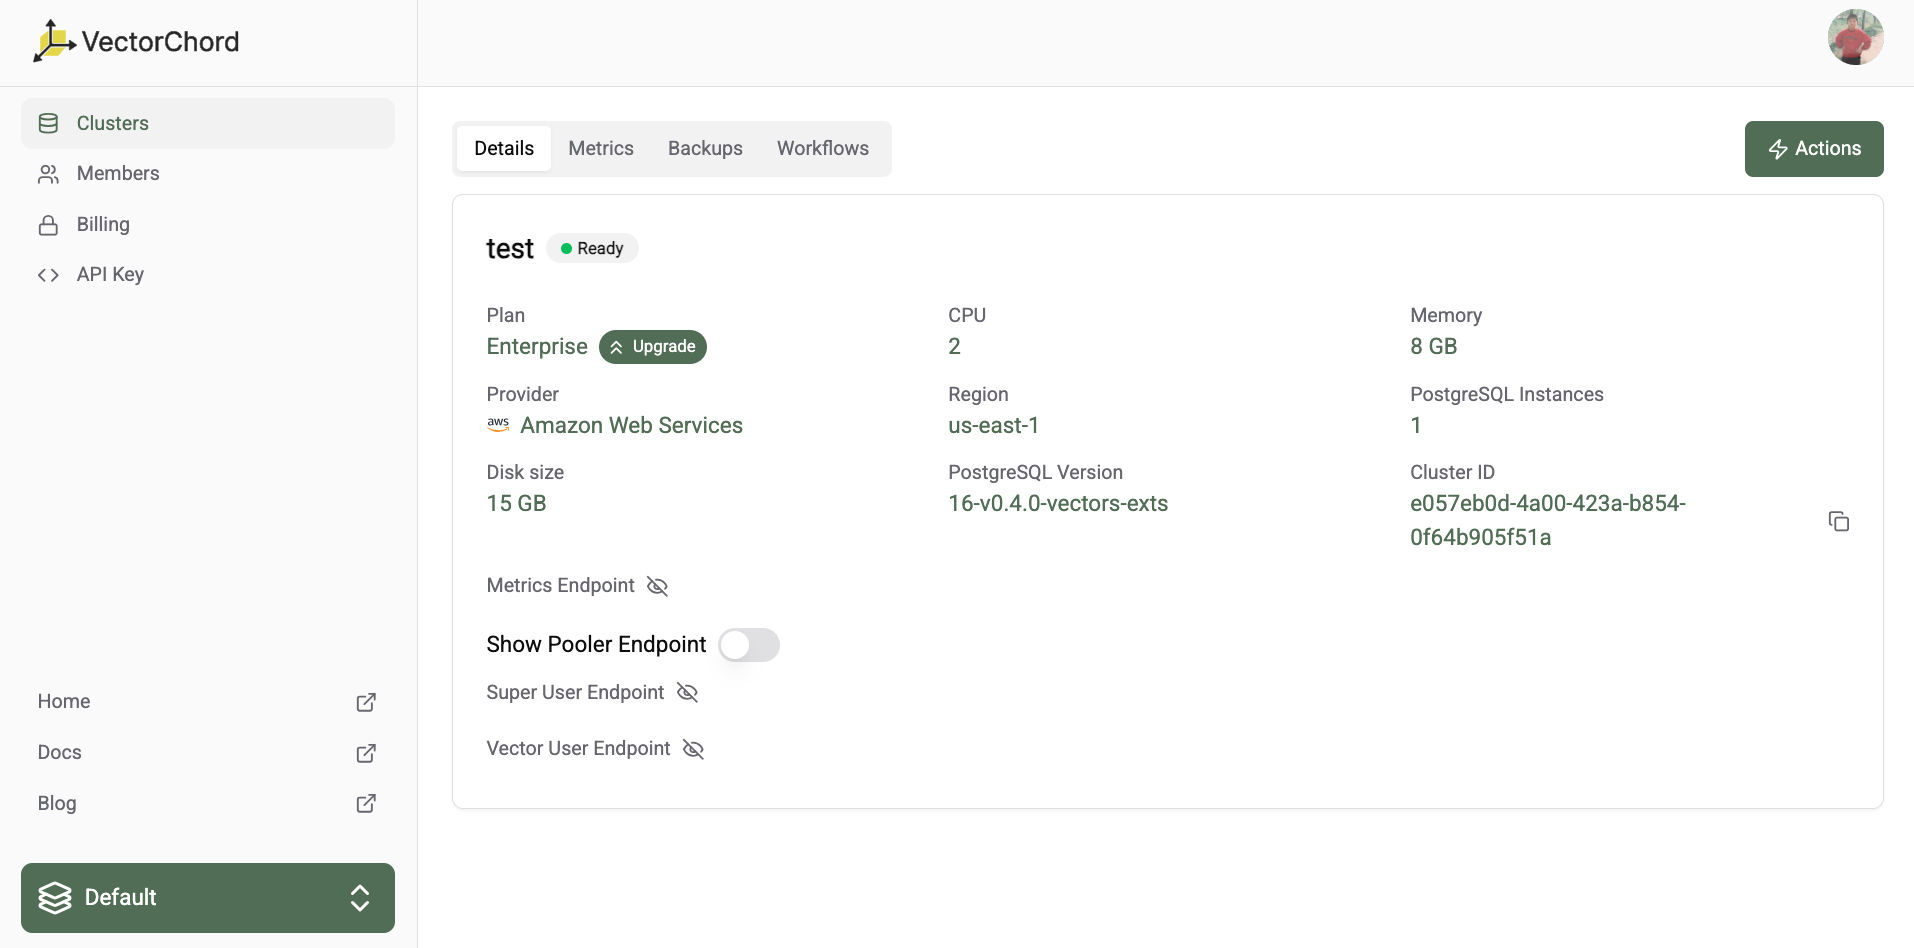
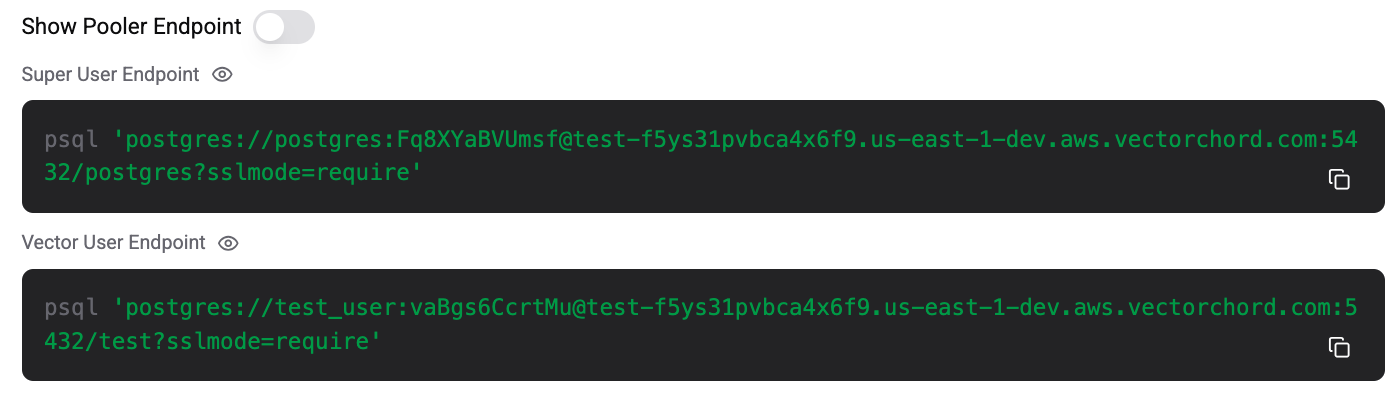
我们提供两种类型的连接端点,分别是 Super User Endpoint(超级用户端点)和 Vector User Endpoint(向量用户端点)。有关这两种连接方式的更多信息,请参阅使用 psql 连接。
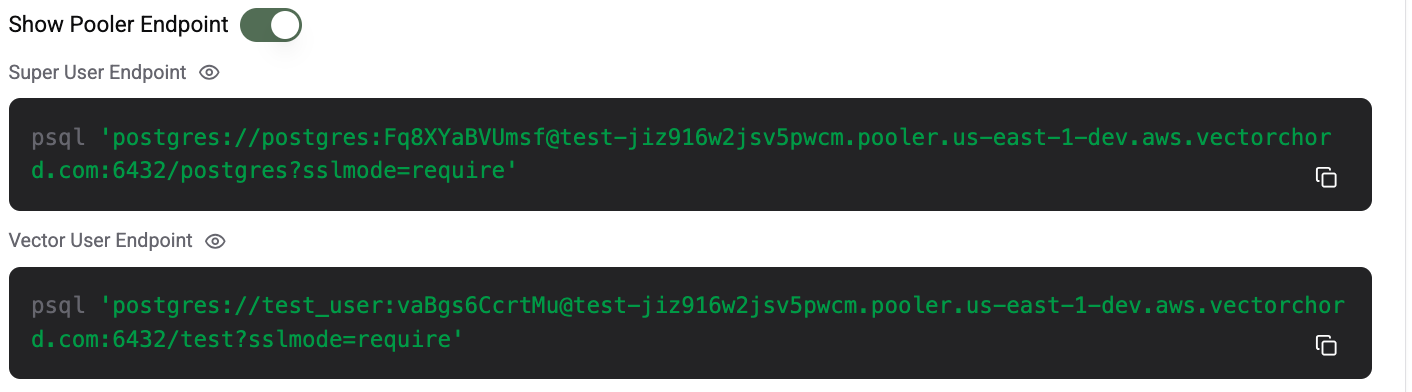
如果在创建集群时勾选了 Enable Connection Pooler,您可以点击 Show Pooler Endpoint 按钮获取连接池端点。
连接到集群

要连接到集群,您可以使用页面提供的连接字符串,并通过 psql 命令行工具进行连接。有关如何连接到集群的详细说明,请参阅使用 psql 连接 VectorChord Cloud。连接到集群后,我们可以执行 \dx 命令来验证 vectors 扩展是否已成功安装。

$ psql 'postgres://test_user:vaBgs6CcrtMu@test-f5ys31pvbca4x6f9.us-east-1-dev.aws.vectorchord.com:5432/test?sslmode=require'
psql (15.3, server 16.5)
WARNING: psql major version 15, server major version 16.
         Some psql features might not work.
SSL connection (protocol: TLSv1.3, cipher: TLS_AES_256_GCM_SHA384, compression: off)
Type "help" for help.

test=> \dx
                                                 List of installed extensions
  Name   | Version |   Schema   |                                         Description
---------+---------+------------+----------------------------------------------------------------------------------------------
 pgaudit | 16.0    | public     | provides auditing functionality
 plpgsql | 1.0     | pg_catalog | PL/pgSQL procedural language
 vectors | 0.4.0   | vectors    | vectors: Vector database plugin for Postgres, written in Rust, specifically designed for LLM
(3 rows)

创建索引

在快速开始中,我们将创建一个简单的索引。如果您想创建更高级的索引,请参阅索引参考文档。我们还提供了丰富的使用场景示例,请参阅使用案例。

test=> CREATE TABLE test (id integer PRIMARY KEY, embedding vector(3) NOT NULL);
CREATE TABLE
test=> INSERT INTO test SELECT i, ARRAY[random(), random(), random()]::real[] FROM generate_series(1, 100) i;
INSERT 0 100
test=> CREATE INDEX ON test USING vectors (embedding vector_l2_ops) WITH (options = "[indexing.hnsw]");
CREATE INDEX
test=> SELECT * FROM test ORDER BY embedding <-> '[0.40671515, 0.24202824, 0.37059402]' LIMIT 10;
 id |              embedding
----+--------------------------------------
 53 | [0.49730784, 0.3848221, 0.28655913]
 19 | [0.54001766, 0.40314186, 0.44689152]
 62 | [0.6388231, 0.20029141, 0.34409937]
 97 | [0.5666403, 0.24310996, 0.1873124]
 30 | [0.21831545, 0.31599918, 0.21045132]
 10 | [0.5354302, 0.44377843, 0.26784408]
 48 | [0.19506525, 0.3632655, 0.24503356]
 76 | [0.283386, 0.5032842, 0.32678106]
 35 | [0.23225804, 0.051908802, 0.5431633]
 56 | [0.5288183, 0.28127462, 0.078518875]
(10 rows)

监控

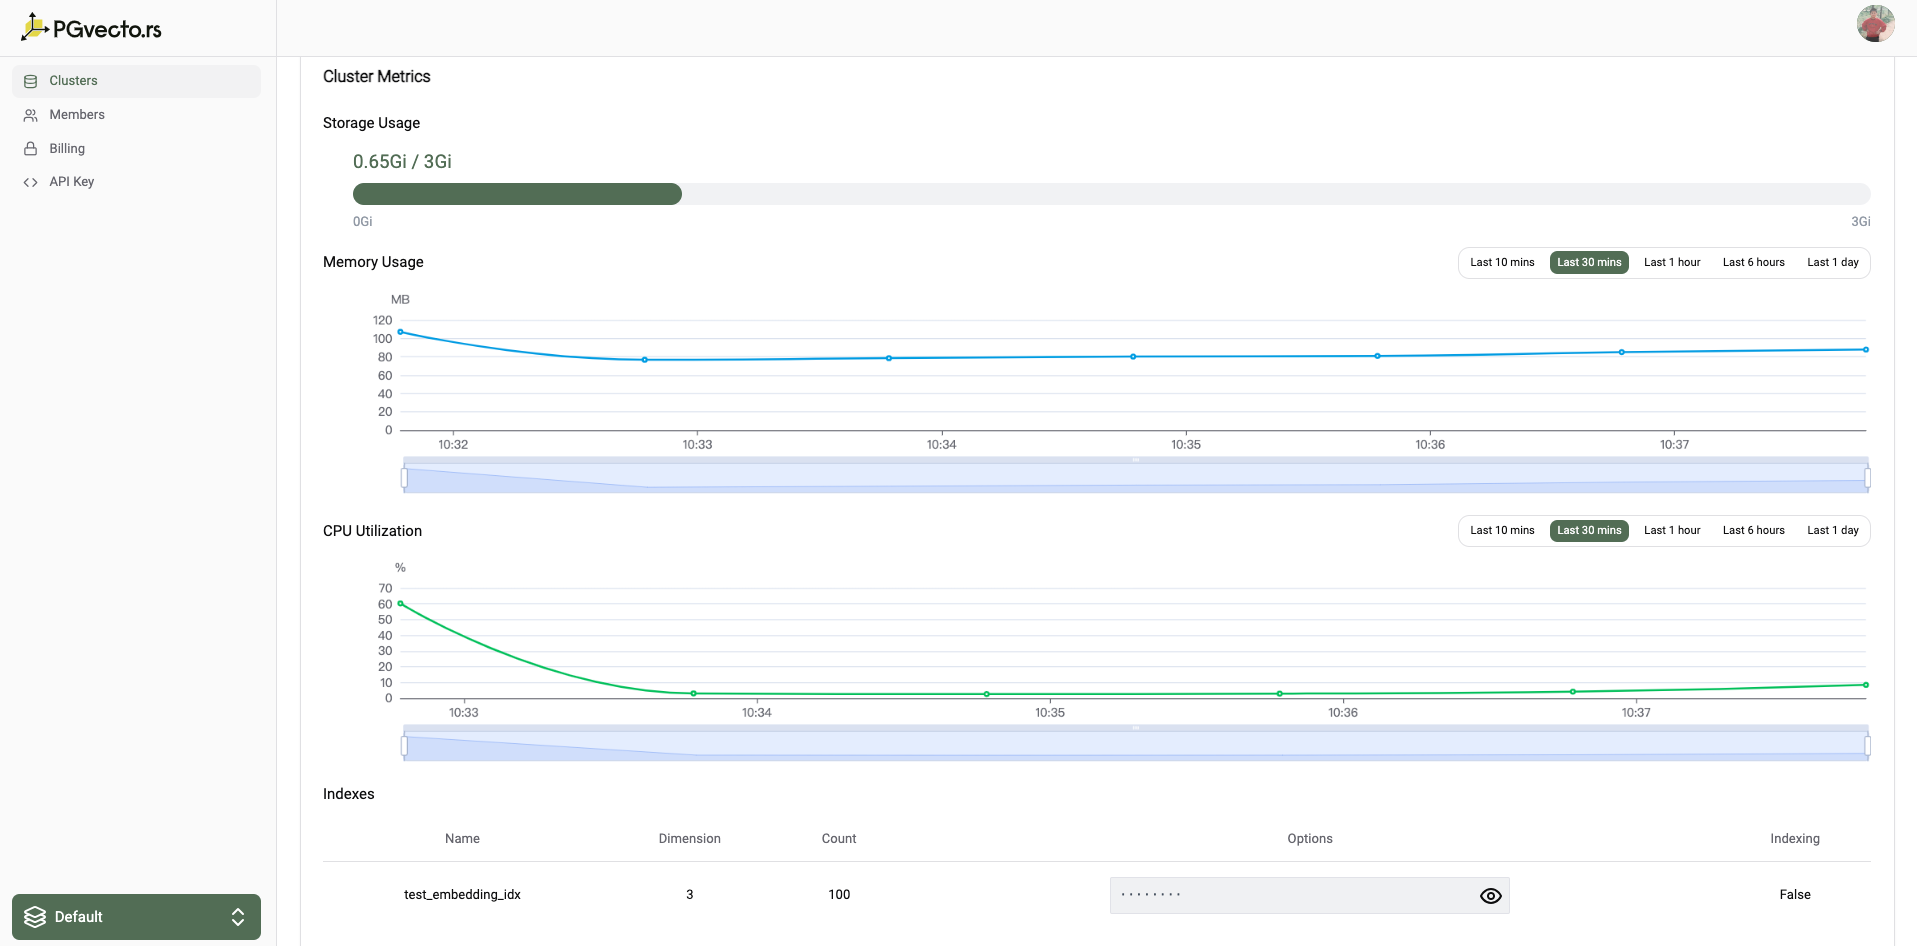
您可以在监控指标(Metrics)页面查看集群的 CPU 使用率、内存使用量以及 PGData 磁盘总量与已用空间。您还可以查看索引信息,例如索引中的向量数量、向量维度等。有关监控的详细信息,请参阅监控。
2 - 连接到集群

通过直接 PostgreSQL 端点或 PgBouncer 连接池连接到 VectorChord Cloud。

2.1 - 使用 psql 连接

以下操作说明要求您已安装并可正常使用 psql。psql 客户端是 Postgres 的原生命令行客户端,提供交互式会话以向 Postgres 发送命令并运行即席查询。

以下操作说明要求您已安装并可正常使用 psql。psql 客户端是 Postgres 的原生命令行客户端,提供交互式会话,用于向 Postgres 发送命令并运行即席查询。有关 psql 的更多信息,请参阅 PostgreSQL 文档中的 psql 参考手册。

警告

集群实例运行的是标准 Postgres,这意味着任何 Postgres 应用程序或标准工具(如 psql)都与 VectorChord Cloud 兼容。您也可以使用各类 Postgres 客户端库和驱动程序进行连接。但请注意,部分较旧的客户端库和驱动程序(包括较旧版本的 psql 可执行文件)在编译时未启用 服务器名称指示(SNI) 支持,需要额外的变通方案。

使用 psql 连接 VectorChord Cloud 最简单的方法是使用连接端点(Connection Endpoint)。您可以从控制台仪表盘的**集群详情(Cluster Details)**页面获取连接端点。

我们提供两种类型的连接端点:

  • Super User Endpoint(超级用户端点):该连接字符串用于以超级用户(postgres)身份连接到集群。您可以使用此连接字符串创建数据库、创建用户以及管理集群。
  • Vector User Endpoint(向量用户端点):该连接字符串用于以向量用户身份连接到集群。您可以使用此连接字符串存储和查询向量数据。

如果在创建集群时勾选了 Enable Connection Pooler,您可以点击 Show Pooler Endpoint 按钮获取连接池连接端点。

在终端或命令提示符下,使用从 Dashboard 复制的连接端点运行 psql 客户端:

$ psql postgres://[user]:[password]@[hostname]/[dbname]
警告

VectorChord Cloud 要求所有连接均使用 SSL/TLS 加密,您也可以通过在连接字符串后追加 sslmode 参数设置来进一步提升安全保护级别。

3 - 监控

监控 CPU、内存、存储,并从 VectorChord Cloud 抓取 Prometheus 监控指标。

3.1 - 监控指标

VectorChord Cloud 提供多张图表,用于监控系统和数据库指标。您可以从 VectorChord Cloud 控制台的集群详情页进入 Metrics 仪表盘。

VectorChord Cloud 提供多张图表,用于监控系统和数据库指标。您可以从 VectorChord Cloud 控制台的集群详情页进入 Metrics 仪表盘。可观测的指标包括:

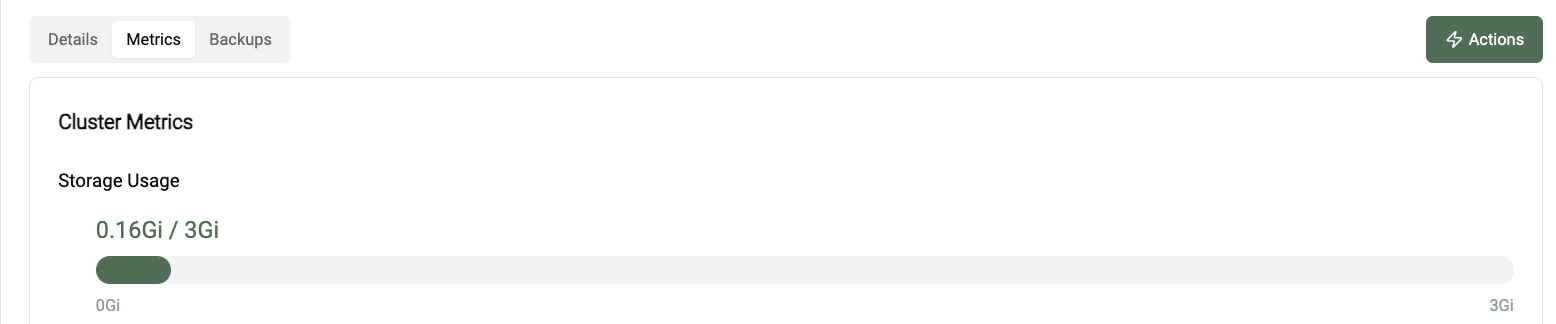
存储使用量

该图表展示了 Postgres 实例的存储总量与已用空间。
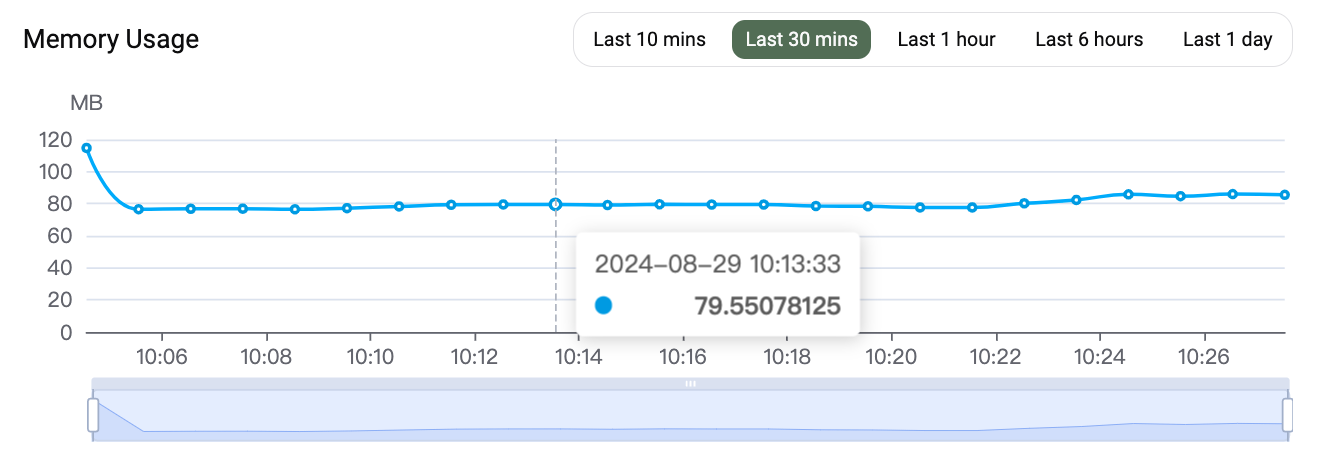
内存(RAM)

该图表展示了 Postgres 实例的平均内存使用量,单位为 MB。
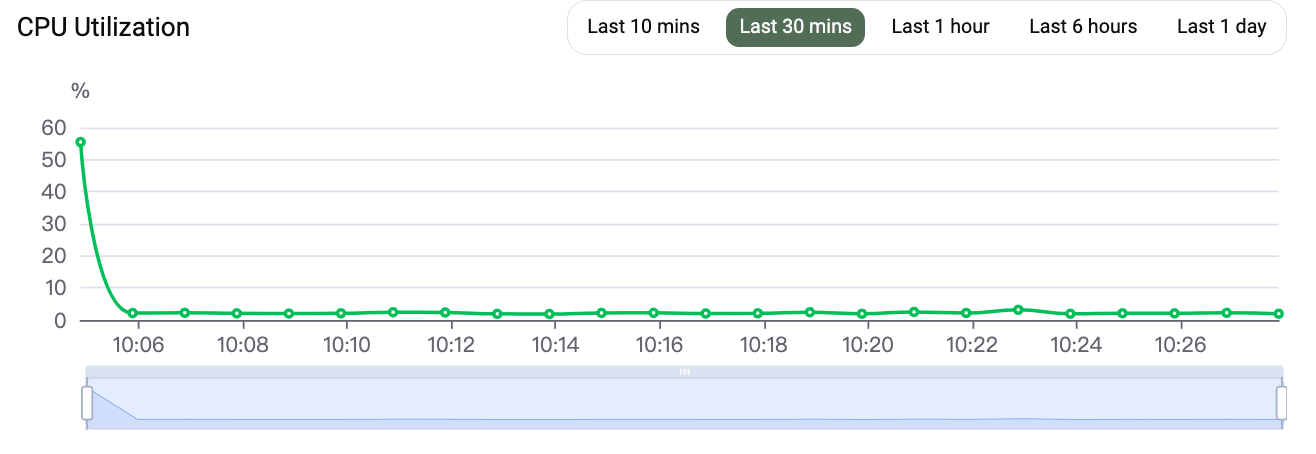
CPU

该图表展示了过去 5 分钟内 Postgres 实例的平均 CPU 使用率百分比。
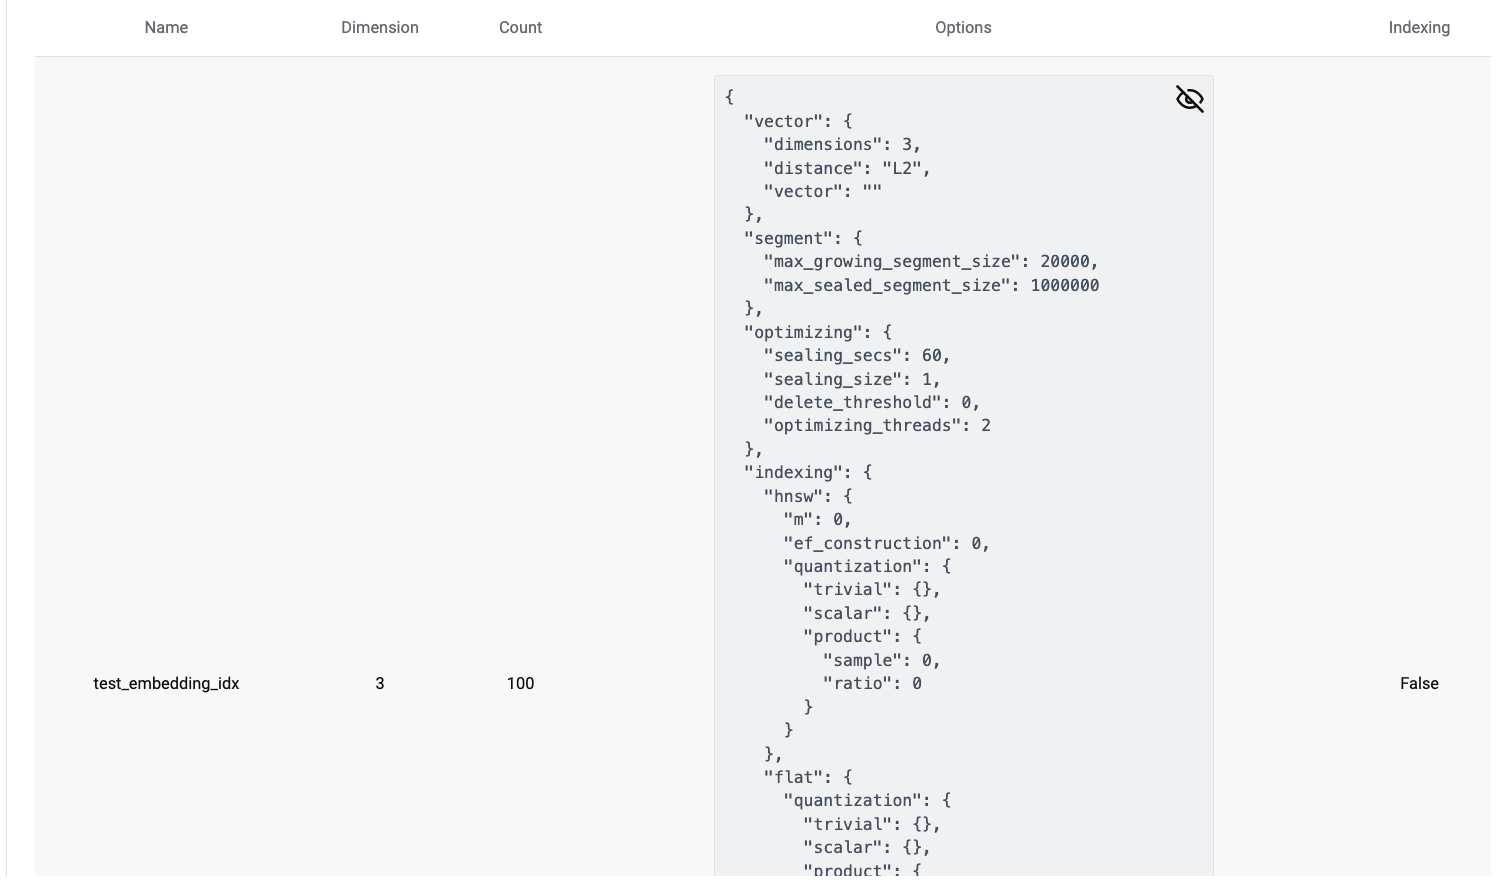
向量索引

该图表展示了向量索引的详细信息,包含以下指标:

  • Index Name(索引名称):索引的名称。
  • Index Dimension(索引维度):索引中向量的维度。
  • Index Vector Count(索引向量数量):索引中的向量条数。
  • Index Options(索引选项):有关索引选项的详细信息,请参阅索引选项。
  • Indexing(构建状态):如果为 True,则表示该索引正在对数据进行索引构建。
3.2 - 采集监控指标

VectorChord Cloud 在 cloud.vectorchord.ai 上展示了常用的数据库监控指标。如果您想将数据库的监控指标采集到自建监控系统中,可以参考本指南。

VectorChord Cloud 在 cloud.vectorchord.ai 上展示了部分常用的数据库监控指标。如果您希望将数据库的监控指标采集到自建的监控系统中,可以参考本指南。详细指标列表请参阅附录章节。

如何获取监控指标

您可以通过数据库域名下的监控指标端点(Metrics Endpoint)获取监控指标。访问这些指标必须提供 VectorChord Cloud API 密钥。您可以在 API 密钥页面生成 API 密钥。

您可以在集群详情页面中找到监控指标端点。
# 您的 VectorChord Cloud API 令牌
APIKey="****"

curl -H "X-API-Key: ${APIKey}" \
     https://cloud.vectorchord.ai/api/v1/users/5c3cb62b-d00b-4dda-85e6-2c0452d50138/cnpgs/e057eb0d-4a00-423a-b854-0f64b905f51a/metrics

配置 Prometheus

Prometheus 是一个按计划定期抓取指标的监控服务端。要配置 Prometheus 从 VectorChord Cloud 实例采集指标,必须为抓取目标配置身份认证令牌。

以下是一个 Prometheus 配置文件示例:

global:
  scrape_interval: 30s

scrape_configs:
  - job_name: 'example_target'
    scheme: https
    static_configs:
      # 使用您的 Postgres 连接字符串中的域名
      - targets: ['cloud.vectorchord.ai']
    metrics_path: '/api/v1/users/5c3cb62b-d00b-4dda-85e6-2c0452d50138/cnpgs/e057eb0d-4a00-423a-b854-0f64b905f51a/metrics'
    authorization:
      type: Bearer
      # 替换为您的 vectorchord.ai API 密钥
      credentials: pgrs-57cc0d484e7e1d00444201eexxxxxxxx 

您也可以通过从外部文件加载令牌的方式,避免将令牌直接明文写入配置文件中。具体配置方式请参阅 Prometheus 官方文档,特别是 scrape_config 中的 authorization 部分。

Prometheus 快速开始

按照本节中的示例操作,您可以快速了解如何将本地 Prometheus 服务端连接到 VectorChord Cloud。

要快速启动并运行本地 Prometheus 服务端,请按以下步骤操作:

  • 安装 Docker
  • 生成一个 vectorchord.ai API 密钥
  • 创建一个名为 docker-compose.yml 的文件,内容如下:
version: '3.7'
services:
    prometheus:
        image: prom/prometheus:v2.33.1
        volumes:
            - ./prometheus.yml:/etc/prometheus/prometheus.yml
        ports:
            - '9090:9090'
        command:
            - '--config.file=/etc/prometheus/prometheus.yml'
  • 在同一目录下创建 prometheus.yml 文件并填入 Prometheus 配置。格式可参考上一节中的配置示例,请将其中的目标路径替换为您的 Postgres 集群监控指标路径,并将令牌替换为您的 VectorChord Cloud API 密钥。
  • 运行 docker-compose up

在 30 秒内,您在浏览器中访问本地 Prometheus 服务端 http://localhost:9090/targets,即可看到 Prometheus 正在正常抓取监控指标。

附录

点击查看所有监控指标
提示

除了 Postgres 集群数据库的专项指标外,我们还提供集群的整体监控指标,例如 PGData 磁盘总量与已用空间、CPU 使用率以及内存使用量。

# HELP cnpg_backends_max_tx_duration_seconds Maximum duration of a transaction in seconds
# TYPE cnpg_backends_max_tx_duration_seconds gauge
cnpg_backends_max_tx_duration_seconds{application_name="cnpg_metrics_exporter",datname="bb",state="active",usename="postgres"} 0
# HELP cnpg_backends_total Number of backends
# TYPE cnpg_backends_total gauge
cnpg_backends_total{application_name="cnpg_metrics_exporter",datname="bb",state="active",usename="postgres"} 1
# HELP cnpg_backends_waiting_total Total number of backends that are currently waiting on other queries
# TYPE cnpg_backends_waiting_total gauge
cnpg_backends_waiting_total 0
# HELP cnpg_collector_collection_duration_seconds Collection time duration in seconds
# TYPE cnpg_collector_collection_duration_seconds gauge
cnpg_collector_collection_duration_seconds{collector="Collect.cnpg"} 0.05290234
cnpg_collector_collection_duration_seconds{collector="Collect.up"} 0.002278657
# HELP cnpg_collector_collections_total Total number of times PostgreSQL was accessed for metrics.
# TYPE cnpg_collector_collections_total counter
cnpg_collector_collections_total 272
# HELP cnpg_collector_fencing_on 1 if the instance is fenced, 0 otherwise
# TYPE cnpg_collector_fencing_on gauge
cnpg_collector_fencing_on 0
# HELP cnpg_collector_first_recoverability_point The first point of recoverability for the cluster as a unix timestamp
# TYPE cnpg_collector_first_recoverability_point gauge
cnpg_collector_first_recoverability_point 1.733281603e+09
# HELP cnpg_collector_last_available_backup_timestamp The last available backup as a unix timestamp
# TYPE cnpg_collector_last_available_backup_timestamp gauge
cnpg_collector_last_available_backup_timestamp 1.733281603e+09
# HELP cnpg_collector_last_collection_error 1 if the last collection ended with error, 0 otherwise.
# TYPE cnpg_collector_last_collection_error gauge
cnpg_collector_last_collection_error 0
# HELP cnpg_collector_last_failed_backup_timestamp The last failed backup as a unix timestamp
# TYPE cnpg_collector_last_failed_backup_timestamp gauge
cnpg_collector_last_failed_backup_timestamp 0
# HELP cnpg_collector_lo_pages Estimated number of pages in the pg_largeobject table
# TYPE cnpg_collector_lo_pages gauge
cnpg_collector_lo_pages{datname="bb"} 0
cnpg_collector_lo_pages{datname="postgres"} 0
# HELP cnpg_collector_manual_switchover_required 1 if a manual switchover is required, 0 otherwise
# TYPE cnpg_collector_manual_switchover_required gauge
cnpg_collector_manual_switchover_required 0
# HELP cnpg_collector_nodes_used NodesUsed represents the count of distinct nodes accommodating the instances. A value of '-1' suggests that the metric is not available. A value of '1' suggests that all instances are hosted on a single node, implying the absence of High Availability (HA). Ideally this value should match the number of instances in the cluster.
# TYPE cnpg_collector_nodes_used gauge
cnpg_collector_nodes_used 1
# HELP cnpg_collector_pg_wal Total size in bytes of WAL segments in the '/var/lib/postgresql/data/pgdata/pg_wal' directory  computed as (wal_segment_size * count)
# TYPE cnpg_collector_pg_wal gauge
cnpg_collector_pg_wal{value="count"} 7
cnpg_collector_pg_wal{value="keep"} 32
cnpg_collector_pg_wal{value="max"} 512
cnpg_collector_pg_wal{value="min"} 128
cnpg_collector_pg_wal{value="size"} 1.17440512e+08
cnpg_collector_pg_wal{value="slots_max"} NaN
cnpg_collector_pg_wal{value="volume_max"} NaN
cnpg_collector_pg_wal{value="volume_size"} NaN
# HELP cnpg_collector_pg_wal_archive_status Number of WAL segments in the '/var/lib/postgresql/data/pgdata/pg_wal/archive_status' directory (ready, done)
# TYPE cnpg_collector_pg_wal_archive_status gauge
cnpg_collector_pg_wal_archive_status{value="done"} 7
cnpg_collector_pg_wal_archive_status{value="ready"} 0
# HELP cnpg_collector_postgres_version Postgres version
# TYPE cnpg_collector_postgres_version gauge
cnpg_collector_postgres_version{cluster="bb",full="16.5"} 16.5
# HELP cnpg_collector_replica_mode 1 if the cluster is in replica mode, 0 otherwise
# TYPE cnpg_collector_replica_mode gauge
cnpg_collector_replica_mode 0
# HELP cnpg_collector_sync_replicas Number of requested synchronous replicas (synchronous_standby_names)
# TYPE cnpg_collector_sync_replicas gauge
cnpg_collector_sync_replicas{value="expected"} 0
cnpg_collector_sync_replicas{value="max"} 0
cnpg_collector_sync_replicas{value="min"} 0
cnpg_collector_sync_replicas{value="observed"} 0
# HELP cnpg_collector_up 1 if PostgreSQL is up, 0 otherwise.
# TYPE cnpg_collector_up gauge
cnpg_collector_up{cluster="bb"} 1
# HELP cnpg_collector_wal_buffers_full Number of times WAL data was written to disk because WAL buffers became full. Only available on PG 14+
# TYPE cnpg_collector_wal_buffers_full gauge
cnpg_collector_wal_buffers_full{stats_reset="2024-12-04T03:05:50.40867Z"} 0
# HELP cnpg_collector_wal_bytes Total amount of WAL generated in bytes. Only available on PG 14+
# TYPE cnpg_collector_wal_bytes gauge
cnpg_collector_wal_bytes{stats_reset="2024-12-04T03:05:50.40867Z"} 1.3429908e+07
# HELP cnpg_collector_wal_fpi Total number of WAL full page images generated. Only available on PG 14+
# TYPE cnpg_collector_wal_fpi gauge
cnpg_collector_wal_fpi{stats_reset="2024-12-04T03:05:50.40867Z"} 1867
# HELP cnpg_collector_wal_records Total number of WAL records generated. Only available on PG 14+
# TYPE cnpg_collector_wal_records gauge
cnpg_collector_wal_records{stats_reset="2024-12-04T03:05:50.40867Z"} 32123
# HELP cnpg_collector_wal_sync Number of times WAL files were synced to disk via issue_xlog_fsync request (if fsync is on and wal_sync_method is either fdatasync, fsync or fsync_writethrough, otherwise zero). Only available on PG 14+
# TYPE cnpg_collector_wal_sync gauge
cnpg_collector_wal_sync{stats_reset="2024-12-04T03:05:50.40867Z"} 54
# HELP cnpg_collector_wal_sync_time Total amount of time spent syncing WAL files to disk via issue_xlog_fsync request, in milliseconds (if track_wal_io_timing is enabled, fsync is on, and wal_sync_method is either fdatasync, fsync or fsync_writethrough, otherwise zero). Only available on PG 14+
# TYPE cnpg_collector_wal_sync_time gauge
cnpg_collector_wal_sync_time{stats_reset="2024-12-04T03:05:50.40867Z"} 0
# HELP cnpg_collector_wal_write Number of times WAL buffers were written out to disk via XLogWrite request. Only available on PG 14+
# TYPE cnpg_collector_wal_write gauge
cnpg_collector_wal_write{stats_reset="2024-12-04T03:05:50.40867Z"} 792
# HELP cnpg_collector_wal_write_time Total amount of time spent writing WAL buffers to disk via XLogWrite request, in milliseconds (if track_wal_io_timing is enabled, otherwise zero). This includes the sync time when wal_sync_method is either open_datasync or open_sync. Only available on PG 14+
# TYPE cnpg_collector_wal_write_time gauge
cnpg_collector_wal_write_time{stats_reset="2024-12-04T03:05:50.40867Z"} 0
# HELP cnpg_last_error 1 if the last collection ended with error, 0 otherwise.
# TYPE cnpg_last_error gauge
cnpg_last_error 0
# HELP cnpg_pg_database_mxid_age Number of multiple transactions (Multixact) from the frozen XID to the current one
# TYPE cnpg_pg_database_mxid_age gauge
cnpg_pg_database_mxid_age{datname="bb"} 0
cnpg_pg_database_mxid_age{datname="postgres"} 0
cnpg_pg_database_mxid_age{datname="template0"} 0
cnpg_pg_database_mxid_age{datname="template1"} 0
# HELP cnpg_pg_database_size_bytes Disk space used by the database
# TYPE cnpg_pg_database_size_bytes gauge
cnpg_pg_database_size_bytes{datname="bb"} 7.934435e+06
cnpg_pg_database_size_bytes{datname="postgres"} 7.688675e+06
cnpg_pg_database_size_bytes{datname="template0"} 7.504399e+06
cnpg_pg_database_size_bytes{datname="template1"} 7.754211e+06
# HELP cnpg_pg_database_xid_age Number of transactions from the frozen XID to the current one
# TYPE cnpg_pg_database_xid_age gauge
cnpg_pg_database_xid_age{datname="bb"} 34
cnpg_pg_database_xid_age{datname="postgres"} 34
cnpg_pg_database_xid_age{datname="template0"} 34
cnpg_pg_database_xid_age{datname="template1"} 34
# HELP cnpg_pg_postmaster_start_time Time at which postgres started (based on epoch)
# TYPE cnpg_pg_postmaster_start_time gauge
cnpg_pg_postmaster_start_time 1.733281559515339e+09
# HELP cnpg_pg_replication_in_recovery Whether the instance is in recovery
# TYPE cnpg_pg_replication_in_recovery gauge
cnpg_pg_replication_in_recovery 0
# HELP cnpg_pg_replication_is_wal_receiver_up Whether the instance wal_receiver is up
# TYPE cnpg_pg_replication_is_wal_receiver_up gauge
cnpg_pg_replication_is_wal_receiver_up 0
# HELP cnpg_pg_replication_lag Replication lag behind primary in seconds
# TYPE cnpg_pg_replication_lag gauge
cnpg_pg_replication_lag 0
# HELP cnpg_pg_replication_streaming_replicas Number of streaming replicas connected to the instance
# TYPE cnpg_pg_replication_streaming_replicas gauge
cnpg_pg_replication_streaming_replicas 0
# HELP cnpg_pg_settings_setting Setting value
# TYPE cnpg_pg_settings_setting gauge
cnpg_pg_settings_setting{name="allow_in_place_tablespaces"} 0
cnpg_pg_settings_setting{name="allow_system_table_mods"} 0
cnpg_pg_settings_setting{name="archive_timeout"} 300
cnpg_pg_settings_setting{name="array_nulls"} 1
cnpg_pg_settings_setting{name="authentication_timeout"} 60
cnpg_pg_settings_setting{name="autovacuum"} 1
cnpg_pg_settings_setting{name="autovacuum_analyze_scale_factor"} 0.1
cnpg_pg_settings_setting{name="autovacuum_analyze_threshold"} 50
cnpg_pg_settings_setting{name="autovacuum_freeze_max_age"} 2e+08
cnpg_pg_settings_setting{name="autovacuum_max_workers"} 3
cnpg_pg_settings_setting{name="autovacuum_multixact_freeze_max_age"} 4e+08
cnpg_pg_settings_setting{name="autovacuum_naptime"} 60
cnpg_pg_settings_setting{name="autovacuum_vacuum_cost_delay"} 2
cnpg_pg_settings_setting{name="autovacuum_vacuum_cost_limit"} -1
cnpg_pg_settings_setting{name="autovacuum_vacuum_insert_scale_factor"} 0.2
cnpg_pg_settings_setting{name="autovacuum_vacuum_insert_threshold"} 1000
cnpg_pg_settings_setting{name="autovacuum_vacuum_scale_factor"} 0.2
cnpg_pg_settings_setting{name="autovacuum_vacuum_threshold"} 50
cnpg_pg_settings_setting{name="autovacuum_work_mem"} -1
cnpg_pg_settings_setting{name="backend_flush_after"} 0
cnpg_pg_settings_setting{name="bgwriter_delay"} 200
cnpg_pg_settings_setting{name="bgwriter_flush_after"} 64
cnpg_pg_settings_setting{name="bgwriter_lru_maxpages"} 100
cnpg_pg_settings_setting{name="bgwriter_lru_multiplier"} 2
cnpg_pg_settings_setting{name="block_size"} 8192
cnpg_pg_settings_setting{name="bonjour"} 0
cnpg_pg_settings_setting{name="check_function_bodies"} 1
cnpg_pg_settings_setting{name="checkpoint_completion_target"} 0.9
cnpg_pg_settings_setting{name="checkpoint_flush_after"} 32
cnpg_pg_settings_setting{name="checkpoint_timeout"} 1800
cnpg_pg_settings_setting{name="checkpoint_warning"} 30
cnpg_pg_settings_setting{name="client_connection_check_interval"} 0
cnpg_pg_settings_setting{name="commit_delay"} 0
cnpg_pg_settings_setting{name="commit_siblings"} 5
cnpg_pg_settings_setting{name="cpu_index_tuple_cost"} 0.005
cnpg_pg_settings_setting{name="cpu_operator_cost"} 0.0025
cnpg_pg_settings_setting{name="cpu_tuple_cost"} 0.01
cnpg_pg_settings_setting{name="cursor_tuple_fraction"} 0.1
cnpg_pg_settings_setting{name="data_checksums"} 1
cnpg_pg_settings_setting{name="data_directory_mode"} 700
cnpg_pg_settings_setting{name="data_sync_retry"} 0
cnpg_pg_settings_setting{name="db_user_namespace"} 0
cnpg_pg_settings_setting{name="deadlock_timeout"} 1000
cnpg_pg_settings_setting{name="debug_assertions"} 0
cnpg_pg_settings_setting{name="debug_discard_caches"} 0
cnpg_pg_settings_setting{name="debug_pretty_print"} 1
cnpg_pg_settings_setting{name="debug_print_parse"} 0
cnpg_pg_settings_setting{name="debug_print_plan"} 0
cnpg_pg_settings_setting{name="debug_print_rewritten"} 0
cnpg_pg_settings_setting{name="default_statistics_target"} 100
cnpg_pg_settings_setting{name="default_transaction_deferrable"} 0
cnpg_pg_settings_setting{name="default_transaction_read_only"} 0
cnpg_pg_settings_setting{name="effective_cache_size"} 786432
cnpg_pg_settings_setting{name="effective_io_concurrency"} 200
cnpg_pg_settings_setting{name="enable_async_append"} 1
cnpg_pg_settings_setting{name="enable_bitmapscan"} 1
cnpg_pg_settings_setting{name="enable_gathermerge"} 1
cnpg_pg_settings_setting{name="enable_hashagg"} 1
cnpg_pg_settings_setting{name="enable_hashjoin"} 1
cnpg_pg_settings_setting{name="enable_incremental_sort"} 1
cnpg_pg_settings_setting{name="enable_indexonlyscan"} 1
cnpg_pg_settings_setting{name="enable_indexscan"} 1
cnpg_pg_settings_setting{name="enable_material"} 1
cnpg_pg_settings_setting{name="enable_memoize"} 1
cnpg_pg_settings_setting{name="enable_mergejoin"} 1
cnpg_pg_settings_setting{name="enable_nestloop"} 1
cnpg_pg_settings_setting{name="enable_parallel_append"} 1
cnpg_pg_settings_setting{name="enable_parallel_hash"} 1
cnpg_pg_settings_setting{name="enable_partition_pruning"} 1
cnpg_pg_settings_setting{name="enable_partitionwise_aggregate"} 0
cnpg_pg_settings_setting{name="enable_partitionwise_join"} 0
cnpg_pg_settings_setting{name="enable_presorted_aggregate"} 1
cnpg_pg_settings_setting{name="enable_seqscan"} 1
cnpg_pg_settings_setting{name="enable_sort"} 1
cnpg_pg_settings_setting{name="enable_tidscan"} 1
cnpg_pg_settings_setting{name="escape_string_warning"} 1
cnpg_pg_settings_setting{name="exit_on_error"} 0
cnpg_pg_settings_setting{name="extra_float_digits"} 1
cnpg_pg_settings_setting{name="from_collapse_limit"} 8
cnpg_pg_settings_setting{name="fsync"} 1
cnpg_pg_settings_setting{name="full_page_writes"} 1
cnpg_pg_settings_setting{name="geqo"} 1
cnpg_pg_settings_setting{name="geqo_effort"} 5
cnpg_pg_settings_setting{name="geqo_generations"} 0
cnpg_pg_settings_setting{name="geqo_pool_size"} 0
cnpg_pg_settings_setting{name="geqo_seed"} 0
cnpg_pg_settings_setting{name="geqo_selection_bias"} 2
cnpg_pg_settings_setting{name="geqo_threshold"} 12
cnpg_pg_settings_setting{name="gin_fuzzy_search_limit"} 0
cnpg_pg_settings_setting{name="gin_pending_list_limit"} 4096
cnpg_pg_settings_setting{name="gss_accept_delegation"} 0
cnpg_pg_settings_setting{name="hash_mem_multiplier"} 2
cnpg_pg_settings_setting{name="hot_standby"} 1
cnpg_pg_settings_setting{name="hot_standby_feedback"} 0
cnpg_pg_settings_setting{name="huge_page_size"} 0
cnpg_pg_settings_setting{name="idle_in_transaction_session_timeout"} 0
cnpg_pg_settings_setting{name="idle_session_timeout"} 0
cnpg_pg_settings_setting{name="ignore_checksum_failure"} 0
cnpg_pg_settings_setting{name="ignore_invalid_pages"} 0
cnpg_pg_settings_setting{name="ignore_system_indexes"} 0
cnpg_pg_settings_setting{name="in_hot_standby"} 0
cnpg_pg_settings_setting{name="integer_datetimes"} 1
cnpg_pg_settings_setting{name="jit"} 1
cnpg_pg_settings_setting{name="jit_above_cost"} 100000
cnpg_pg_settings_setting{name="jit_debugging_support"} 0
cnpg_pg_settings_setting{name="jit_dump_bitcode"} 0
cnpg_pg_settings_setting{name="jit_expressions"} 1
cnpg_pg_settings_setting{name="jit_inline_above_cost"} 500000
cnpg_pg_settings_setting{name="jit_optimize_above_cost"} 500000
cnpg_pg_settings_setting{name="jit_profiling_support"} 0
cnpg_pg_settings_setting{name="jit_tuple_deforming"} 1
cnpg_pg_settings_setting{name="join_collapse_limit"} 8
cnpg_pg_settings_setting{name="krb_caseins_users"} 0
cnpg_pg_settings_setting{name="lo_compat_privileges"} 0
cnpg_pg_settings_setting{name="lock_timeout"} 0
cnpg_pg_settings_setting{name="log_autovacuum_min_duration"} 600000
cnpg_pg_settings_setting{name="log_checkpoints"} 1
cnpg_pg_settings_setting{name="log_connections"} 0
cnpg_pg_settings_setting{name="log_disconnections"} 0
cnpg_pg_settings_setting{name="log_duration"} 0
cnpg_pg_settings_setting{name="log_executor_stats"} 0
cnpg_pg_settings_setting{name="log_file_mode"} 600
cnpg_pg_settings_setting{name="log_hostname"} 0
cnpg_pg_settings_setting{name="log_lock_waits"} 0
cnpg_pg_settings_setting{name="log_min_duration_sample"} -1
cnpg_pg_settings_setting{name="log_min_duration_statement"} -1
cnpg_pg_settings_setting{name="log_parameter_max_length"} -1
cnpg_pg_settings_setting{name="log_parameter_max_length_on_error"} 0
cnpg_pg_settings_setting{name="log_parser_stats"} 0
cnpg_pg_settings_setting{name="log_planner_stats"} 0
cnpg_pg_settings_setting{name="log_recovery_conflict_waits"} 0
cnpg_pg_settings_setting{name="log_replication_commands"} 0
cnpg_pg_settings_setting{name="log_rotation_age"} 0
cnpg_pg_settings_setting{name="log_rotation_size"} 0
cnpg_pg_settings_setting{name="log_startup_progress_interval"} 10000
cnpg_pg_settings_setting{name="log_statement_sample_rate"} 1
cnpg_pg_settings_setting{name="log_statement_stats"} 0
cnpg_pg_settings_setting{name="log_temp_files"} -1
cnpg_pg_settings_setting{name="log_transaction_sample_rate"} 0
cnpg_pg_settings_setting{name="log_truncate_on_rotation"} 0
cnpg_pg_settings_setting{name="logging_collector"} 1
cnpg_pg_settings_setting{name="logical_decoding_work_mem"} 65536
cnpg_pg_settings_setting{name="maintenance_io_concurrency"} 10
cnpg_pg_settings_setting{name="maintenance_work_mem"} 524288
cnpg_pg_settings_setting{name="max_connections"} 100
cnpg_pg_settings_setting{name="max_files_per_process"} 1000
cnpg_pg_settings_setting{name="max_function_args"} 100
cnpg_pg_settings_setting{name="max_identifier_length"} 63
cnpg_pg_settings_setting{name="max_index_keys"} 32
cnpg_pg_settings_setting{name="max_locks_per_transaction"} 64
cnpg_pg_settings_setting{name="max_logical_replication_workers"} 4
cnpg_pg_settings_setting{name="max_parallel_apply_workers_per_subscription"} 2
cnpg_pg_settings_setting{name="max_parallel_maintenance_workers"} 1
cnpg_pg_settings_setting{name="max_parallel_workers"} 2
cnpg_pg_settings_setting{name="max_parallel_workers_per_gather"} 1
cnpg_pg_settings_setting{name="max_pred_locks_per_page"} 2
cnpg_pg_settings_setting{name="max_pred_locks_per_relation"} -2
cnpg_pg_settings_setting{name="max_pred_locks_per_transaction"} 64
cnpg_pg_settings_setting{name="max_prepared_transactions"} 0
cnpg_pg_settings_setting{name="max_replication_slots"} 32
cnpg_pg_settings_setting{name="max_slot_wal_keep_size"} -1
cnpg_pg_settings_setting{name="max_stack_depth"} 2048
cnpg_pg_settings_setting{name="max_standby_archive_delay"} 30000
cnpg_pg_settings_setting{name="max_standby_streaming_delay"} 30000
cnpg_pg_settings_setting{name="max_sync_workers_per_subscription"} 2
cnpg_pg_settings_setting{name="max_wal_senders"} 10
cnpg_pg_settings_setting{name="max_wal_size"} 8192
cnpg_pg_settings_setting{name="max_worker_processes"} 2
cnpg_pg_settings_setting{name="min_dynamic_shared_memory"} 0
cnpg_pg_settings_setting{name="min_parallel_index_scan_size"} 64
cnpg_pg_settings_setting{name="min_parallel_table_scan_size"} 1024
cnpg_pg_settings_setting{name="min_wal_size"} 2048
cnpg_pg_settings_setting{name="old_snapshot_threshold"} -1
cnpg_pg_settings_setting{name="parallel_leader_participation"} 1
cnpg_pg_settings_setting{name="parallel_setup_cost"} 1000
cnpg_pg_settings_setting{name="parallel_tuple_cost"} 0.1
cnpg_pg_settings_setting{name="pgaudit.log_catalog"} 0
cnpg_pg_settings_setting{name="pgaudit.log_client"} 0
cnpg_pg_settings_setting{name="pgaudit.log_parameter"} 1
cnpg_pg_settings_setting{name="pgaudit.log_parameter_max_size"} 0
cnpg_pg_settings_setting{name="pgaudit.log_relation"} 1
cnpg_pg_settings_setting{name="pgaudit.log_rows"} 0
cnpg_pg_settings_setting{name="pgaudit.log_statement"} 1
cnpg_pg_settings_setting{name="pgaudit.log_statement_once"} 0
cnpg_pg_settings_setting{name="port"} 5432
cnpg_pg_settings_setting{name="post_auth_delay"} 0
cnpg_pg_settings_setting{name="pre_auth_delay"} 0
cnpg_pg_settings_setting{name="quote_all_identifiers"} 0
cnpg_pg_settings_setting{name="random_page_cost"} 1.1
cnpg_pg_settings_setting{name="recovery_min_apply_delay"} 0
cnpg_pg_settings_setting{name="recovery_target_inclusive"} 1
cnpg_pg_settings_setting{name="recursive_worktable_factor"} 10
cnpg_pg_settings_setting{name="remove_temp_files_after_crash"} 1
cnpg_pg_settings_setting{name="reserved_connections"} 0
cnpg_pg_settings_setting{name="restart_after_crash"} 0
cnpg_pg_settings_setting{name="row_security"} 1
cnpg_pg_settings_setting{name="scram_iterations"} 4096
cnpg_pg_settings_setting{name="segment_size"} 131072
cnpg_pg_settings_setting{name="send_abort_for_crash"} 0
cnpg_pg_settings_setting{name="send_abort_for_kill"} 0
cnpg_pg_settings_setting{name="seq_page_cost"} 1
cnpg_pg_settings_setting{name="server_version_num"} 160005
cnpg_pg_settings_setting{name="shared_buffers"} 262144
cnpg_pg_settings_setting{name="shared_memory_size"} 2120
cnpg_pg_settings_setting{name="shared_memory_size_in_huge_pages"} 1060
cnpg_pg_settings_setting{name="ssl"} 1
cnpg_pg_settings_setting{name="ssl_passphrase_command_supports_reload"} 0
cnpg_pg_settings_setting{name="ssl_prefer_server_ciphers"} 1
cnpg_pg_settings_setting{name="standard_conforming_strings"} 1
cnpg_pg_settings_setting{name="statement_timeout"} 0
cnpg_pg_settings_setting{name="superuser_reserved_connections"} 3
cnpg_pg_settings_setting{name="synchronize_seqscans"} 1
cnpg_pg_settings_setting{name="syslog_sequence_numbers"} 1
cnpg_pg_settings_setting{name="syslog_split_messages"} 1
cnpg_pg_settings_setting{name="tcp_keepalives_count"} 0
cnpg_pg_settings_setting{name="tcp_keepalives_idle"} 0
cnpg_pg_settings_setting{name="tcp_keepalives_interval"} 0
cnpg_pg_settings_setting{name="tcp_user_timeout"} 0
cnpg_pg_settings_setting{name="temp_buffers"} 1024
cnpg_pg_settings_setting{name="temp_file_limit"} -1
cnpg_pg_settings_setting{name="trace_notify"} 0
cnpg_pg_settings_setting{name="trace_sort"} 0
cnpg_pg_settings_setting{name="track_activities"} 1
cnpg_pg_settings_setting{name="track_activity_query_size"} 1024
cnpg_pg_settings_setting{name="track_commit_timestamp"} 0
cnpg_pg_settings_setting{name="track_counts"} 1
cnpg_pg_settings_setting{name="track_io_timing"} 0
cnpg_pg_settings_setting{name="track_wal_io_timing"} 0
cnpg_pg_settings_setting{name="transaction_deferrable"} 0
cnpg_pg_settings_setting{name="transaction_read_only"} 1
cnpg_pg_settings_setting{name="transform_null_equals"} 0
cnpg_pg_settings_setting{name="unix_socket_permissions"} 777
cnpg_pg_settings_setting{name="update_process_title"} 1
cnpg_pg_settings_setting{name="vacuum_buffer_usage_limit"} 256
cnpg_pg_settings_setting{name="vacuum_cost_delay"} 0
cnpg_pg_settings_setting{name="vacuum_cost_limit"} 200
cnpg_pg_settings_setting{name="vacuum_cost_page_dirty"} 20
cnpg_pg_settings_setting{name="vacuum_cost_page_hit"} 1
cnpg_pg_settings_setting{name="vacuum_cost_page_miss"} 2
cnpg_pg_settings_setting{name="vacuum_failsafe_age"} 1.6e+09
cnpg_pg_settings_setting{name="vacuum_freeze_min_age"} 5e+07
cnpg_pg_settings_setting{name="vacuum_freeze_table_age"} 1.5e+08
cnpg_pg_settings_setting{name="vacuum_multixact_failsafe_age"} 1.6e+09
cnpg_pg_settings_setting{name="vacuum_multixact_freeze_min_age"} 5e+06
cnpg_pg_settings_setting{name="vacuum_multixact_freeze_table_age"} 1.5e+08
cnpg_pg_settings_setting{name="vectors.enable_index"} 1
cnpg_pg_settings_setting{name="vectors.hnsw_ef_search"} 100
cnpg_pg_settings_setting{name="vectors.ivf_nprobe"} 10
cnpg_pg_settings_setting{name="vectors.pgvector_compatibility"} 1
cnpg_pg_settings_setting{name="vectors.pq_fast_scan"} 0
cnpg_pg_settings_setting{name="vectors.pq_rerank_size"} 0
cnpg_pg_settings_setting{name="vectors.rq_fast_scan"} 0
cnpg_pg_settings_setting{name="vectors.sq_fast_scan"} 0
cnpg_pg_settings_setting{name="vectors.sq_rerank_size"} 0
cnpg_pg_settings_setting{name="wal_block_size"} 8192
cnpg_pg_settings_setting{name="wal_buffers"} 2048
cnpg_pg_settings_setting{name="wal_decode_buffer_size"} 524288
cnpg_pg_settings_setting{name="wal_init_zero"} 1
cnpg_pg_settings_setting{name="wal_keep_size"} 512
cnpg_pg_settings_setting{name="wal_log_hints"} 1
cnpg_pg_settings_setting{name="wal_receiver_create_temp_slot"} 0
cnpg_pg_settings_setting{name="wal_receiver_status_interval"} 10
cnpg_pg_settings_setting{name="wal_receiver_timeout"} 5000
cnpg_pg_settings_setting{name="wal_recycle"} 1
cnpg_pg_settings_setting{name="wal_retrieve_retry_interval"} 5000
cnpg_pg_settings_setting{name="wal_segment_size"} 1.6777216e+07
cnpg_pg_settings_setting{name="wal_sender_timeout"} 5000
cnpg_pg_settings_setting{name="wal_skip_threshold"} 2048
cnpg_pg_settings_setting{name="wal_writer_delay"} 200
cnpg_pg_settings_setting{name="wal_writer_flush_after"} 128
cnpg_pg_settings_setting{name="work_mem"} 20971
cnpg_pg_settings_setting{name="zero_damaged_pages"} 0
# HELP cnpg_pg_stat_archiver_archived_count Number of WAL files that have been successfully archived
# TYPE cnpg_pg_stat_archiver_archived_count counter
cnpg_pg_stat_archiver_archived_count 7
# HELP cnpg_pg_stat_archiver_failed_count Number of failed attempts for archiving WAL files
# TYPE cnpg_pg_stat_archiver_failed_count counter
cnpg_pg_stat_archiver_failed_count 0
# HELP cnpg_pg_stat_archiver_last_archived_time Epoch of the last time WAL archiving succeeded
# TYPE cnpg_pg_stat_archiver_last_archived_time gauge
cnpg_pg_stat_archiver_last_archived_time 1.733283406713513e+09
# HELP cnpg_pg_stat_archiver_last_archived_wal_start_lsn Archived WAL start LSN
# TYPE cnpg_pg_stat_archiver_last_archived_wal_start_lsn gauge
cnpg_pg_stat_archiver_last_archived_wal_start_lsn 6
# HELP cnpg_pg_stat_archiver_last_failed_time Epoch of the last time WAL archiving failed
# TYPE cnpg_pg_stat_archiver_last_failed_time gauge
cnpg_pg_stat_archiver_last_failed_time -1
# HELP cnpg_pg_stat_archiver_last_failed_wal_start_lsn Last failed WAL LSN
# TYPE cnpg_pg_stat_archiver_last_failed_wal_start_lsn gauge
cnpg_pg_stat_archiver_last_failed_wal_start_lsn -1
# HELP cnpg_pg_stat_archiver_seconds_since_last_archival Seconds since the last successful archival operation
# TYPE cnpg_pg_stat_archiver_seconds_since_last_archival gauge
cnpg_pg_stat_archiver_seconds_since_last_archival 6104.299629
# HELP cnpg_pg_stat_archiver_seconds_since_last_failure Seconds since the last failed archival operation
# TYPE cnpg_pg_stat_archiver_seconds_since_last_failure gauge
cnpg_pg_stat_archiver_seconds_since_last_failure -1
# HELP cnpg_pg_stat_archiver_stats_reset_time Time at which these statistics were last reset
# TYPE cnpg_pg_stat_archiver_stats_reset_time gauge
cnpg_pg_stat_archiver_stats_reset_time 1.73328155040867e+09
# HELP cnpg_pg_stat_bgwriter_buffers_alloc Number of buffers allocated
# TYPE cnpg_pg_stat_bgwriter_buffers_alloc counter
cnpg_pg_stat_bgwriter_buffers_alloc 2770
# HELP cnpg_pg_stat_bgwriter_buffers_backend Number of buffers written directly by a backend
# TYPE cnpg_pg_stat_bgwriter_buffers_backend counter
cnpg_pg_stat_bgwriter_buffers_backend 346
# HELP cnpg_pg_stat_bgwriter_buffers_backend_fsync Number of times a backend had to execute its own fsync call (normally the background writer handles those even when the backend does its own write)
# TYPE cnpg_pg_stat_bgwriter_buffers_backend_fsync counter
cnpg_pg_stat_bgwriter_buffers_backend_fsync 0
# HELP cnpg_pg_stat_bgwriter_buffers_checkpoint Number of buffers written during checkpoints
# TYPE cnpg_pg_stat_bgwriter_buffers_checkpoint counter
cnpg_pg_stat_bgwriter_buffers_checkpoint 1145
# HELP cnpg_pg_stat_bgwriter_buffers_clean Number of buffers written by the background writer
# TYPE cnpg_pg_stat_bgwriter_buffers_clean counter
cnpg_pg_stat_bgwriter_buffers_clean 0
# HELP cnpg_pg_stat_bgwriter_checkpoint_sync_time Total amount of time that has been spent in the portion of checkpoint processing where files are synchronized to disk, in milliseconds
# TYPE cnpg_pg_stat_bgwriter_checkpoint_sync_time counter
cnpg_pg_stat_bgwriter_checkpoint_sync_time 11
# HELP cnpg_pg_stat_bgwriter_checkpoint_write_time Total amount of time that has been spent in the portion of checkpoint processing where files are written to disk, in milliseconds
# TYPE cnpg_pg_stat_bgwriter_checkpoint_write_time counter
cnpg_pg_stat_bgwriter_checkpoint_write_time 18902
# HELP cnpg_pg_stat_bgwriter_checkpoints_req Number of requested checkpoints that have been performed
# TYPE cnpg_pg_stat_bgwriter_checkpoints_req counter
cnpg_pg_stat_bgwriter_checkpoints_req 2
# HELP cnpg_pg_stat_bgwriter_checkpoints_timed Number of scheduled checkpoints that have been performed
# TYPE cnpg_pg_stat_bgwriter_checkpoints_timed counter
cnpg_pg_stat_bgwriter_checkpoints_timed 4
# HELP cnpg_pg_stat_bgwriter_maxwritten_clean Number of times the background writer stopped a cleaning scan because it had written too many buffers
# TYPE cnpg_pg_stat_bgwriter_maxwritten_clean counter
cnpg_pg_stat_bgwriter_maxwritten_clean 0
# HELP cnpg_pg_stat_database_blk_read_time Time spent reading data file blocks by backends in this database, in milliseconds
# TYPE cnpg_pg_stat_database_blk_read_time counter
cnpg_pg_stat_database_blk_read_time{datname=""} 0
cnpg_pg_stat_database_blk_read_time{datname="bb"} 0
cnpg_pg_stat_database_blk_read_time{datname="postgres"} 0
cnpg_pg_stat_database_blk_read_time{datname="template0"} 0
cnpg_pg_stat_database_blk_read_time{datname="template1"} 0
# HELP cnpg_pg_stat_database_blk_write_time Time spent writing data file blocks by backends in this database, in milliseconds
# TYPE cnpg_pg_stat_database_blk_write_time counter
cnpg_pg_stat_database_blk_write_time{datname=""} 0
cnpg_pg_stat_database_blk_write_time{datname="bb"} 0
cnpg_pg_stat_database_blk_write_time{datname="postgres"} 0
cnpg_pg_stat_database_blk_write_time{datname="template0"} 0
cnpg_pg_stat_database_blk_write_time{datname="template1"} 0
# HELP cnpg_pg_stat_database_blks_hit Number of times disk blocks were found already in the buffer cache, so that a read was not necessary (this only includes hits in the PostgreSQL buffer cache, not the operating system's file system cache)
# TYPE cnpg_pg_stat_database_blks_hit counter
cnpg_pg_stat_database_blks_hit{datname=""} 195433
cnpg_pg_stat_database_blks_hit{datname="bb"} 1.284724e+06
cnpg_pg_stat_database_blks_hit{datname="postgres"} 226804
cnpg_pg_stat_database_blks_hit{datname="template0"} 0
cnpg_pg_stat_database_blks_hit{datname="template1"} 99880
# HELP cnpg_pg_stat_database_blks_read Number of disk blocks read in this database
# TYPE cnpg_pg_stat_database_blks_read counter
cnpg_pg_stat_database_blks_read{datname=""} 94
cnpg_pg_stat_database_blks_read{datname="bb"} 316
cnpg_pg_stat_database_blks_read{datname="postgres"} 402
cnpg_pg_stat_database_blks_read{datname="template0"} 0
cnpg_pg_stat_database_blks_read{datname="template1"} 891
# HELP cnpg_pg_stat_database_conflicts Number of queries canceled due to conflicts with recovery in this database
# TYPE cnpg_pg_stat_database_conflicts counter
cnpg_pg_stat_database_conflicts{datname=""} 0
cnpg_pg_stat_database_conflicts{datname="bb"} 0
cnpg_pg_stat_database_conflicts{datname="postgres"} 0
cnpg_pg_stat_database_conflicts{datname="template0"} 0
cnpg_pg_stat_database_conflicts{datname="template1"} 0
# HELP cnpg_pg_stat_database_deadlocks Number of deadlocks detected in this database
# TYPE cnpg_pg_stat_database_deadlocks counter
cnpg_pg_stat_database_deadlocks{datname=""} 0
cnpg_pg_stat_database_deadlocks{datname="bb"} 0
cnpg_pg_stat_database_deadlocks{datname="postgres"} 0
cnpg_pg_stat_database_deadlocks{datname="template0"} 0
cnpg_pg_stat_database_deadlocks{datname="template1"} 0
# HELP cnpg_pg_stat_database_temp_bytes Total amount of data written to temporary files by queries in this database
# TYPE cnpg_pg_stat_database_temp_bytes counter
cnpg_pg_stat_database_temp_bytes{datname=""} 0
cnpg_pg_stat_database_temp_bytes{datname="bb"} 0
cnpg_pg_stat_database_temp_bytes{datname="postgres"} 0
cnpg_pg_stat_database_temp_bytes{datname="template0"} 0
cnpg_pg_stat_database_temp_bytes{datname="template1"} 0
# HELP cnpg_pg_stat_database_temp_files Number of temporary files created by queries in this database
# TYPE cnpg_pg_stat_database_temp_files counter
cnpg_pg_stat_database_temp_files{datname=""} 0
cnpg_pg_stat_database_temp_files{datname="bb"} 0
cnpg_pg_stat_database_temp_files{datname="postgres"} 0
cnpg_pg_stat_database_temp_files{datname="template0"} 0
cnpg_pg_stat_database_temp_files{datname="template1"} 0
# HELP cnpg_pg_stat_database_tup_deleted Number of rows deleted by queries in this database
# TYPE cnpg_pg_stat_database_tup_deleted counter
cnpg_pg_stat_database_tup_deleted{datname=""} 0
cnpg_pg_stat_database_tup_deleted{datname="bb"} 41
cnpg_pg_stat_database_tup_deleted{datname="postgres"} 0
cnpg_pg_stat_database_tup_deleted{datname="template0"} 0
cnpg_pg_stat_database_tup_deleted{datname="template1"} 34
# HELP cnpg_pg_stat_database_tup_fetched Number of rows fetched by queries in this database
# TYPE cnpg_pg_stat_database_tup_fetched counter
cnpg_pg_stat_database_tup_fetched{datname=""} 51500
cnpg_pg_stat_database_tup_fetched{datname="bb"} 807164
cnpg_pg_stat_database_tup_fetched{datname="postgres"} 121616
cnpg_pg_stat_database_tup_fetched{datname="template0"} 0
cnpg_pg_stat_database_tup_fetched{datname="template1"} 29147
# HELP cnpg_pg_stat_database_tup_inserted Number of rows inserted by queries in this database
# TYPE cnpg_pg_stat_database_tup_inserted counter
cnpg_pg_stat_database_tup_inserted{datname=""} 36
cnpg_pg_stat_database_tup_inserted{datname="bb"} 1401
cnpg_pg_stat_database_tup_inserted{datname="postgres"} 15
cnpg_pg_stat_database_tup_inserted{datname="template0"} 0
cnpg_pg_stat_database_tup_inserted{datname="template1"} 17593
# HELP cnpg_pg_stat_database_tup_returned Number of rows returned by queries in this database
# TYPE cnpg_pg_stat_database_tup_returned counter
cnpg_pg_stat_database_tup_returned{datname=""} 60743
cnpg_pg_stat_database_tup_returned{datname="bb"} 1.045589e+06
cnpg_pg_stat_database_tup_returned{datname="postgres"} 240174
cnpg_pg_stat_database_tup_returned{datname="template0"} 0
cnpg_pg_stat_database_tup_returned{datname="template1"} 191401
# HELP cnpg_pg_stat_database_tup_updated Number of rows updated by queries in this database
# TYPE cnpg_pg_stat_database_tup_updated counter
cnpg_pg_stat_database_tup_updated{datname=""} 7
cnpg_pg_stat_database_tup_updated{datname="bb"} 107
cnpg_pg_stat_database_tup_updated{datname="postgres"} 4
cnpg_pg_stat_database_tup_updated{datname="template0"} 0
cnpg_pg_stat_database_tup_updated{datname="template1"} 754
# HELP cnpg_pg_stat_database_xact_commit Number of transactions in this database that have been committed
# TYPE cnpg_pg_stat_database_xact_commit counter
cnpg_pg_stat_database_xact_commit{datname=""} 0
cnpg_pg_stat_database_xact_commit{datname="bb"} 7887
cnpg_pg_stat_database_xact_commit{datname="postgres"} 5928
cnpg_pg_stat_database_xact_commit{datname="template0"} 0
cnpg_pg_stat_database_xact_commit{datname="template1"} 1177
# HELP cnpg_pg_stat_database_xact_rollback Number of transactions in this database that have been rolled back
# TYPE cnpg_pg_stat_database_xact_rollback counter
cnpg_pg_stat_database_xact_rollback{datname=""} 0
cnpg_pg_stat_database_xact_rollback{datname="bb"} 0
cnpg_pg_stat_database_xact_rollback{datname="postgres"} 0
cnpg_pg_stat_database_xact_rollback{datname="template0"} 0
cnpg_pg_stat_database_xact_rollback{datname="template1"} 0
# HELP go_gc_duration_seconds A summary of the pause duration of garbage collection cycles.
# TYPE go_gc_duration_seconds summary
go_gc_duration_seconds{quantile="0"} 1.6777e-05
go_gc_duration_seconds{quantile="0.25"} 4.737e-05
go_gc_duration_seconds{quantile="0.5"} 6.074e-05
go_gc_duration_seconds{quantile="0.75"} 7.1193e-05
go_gc_duration_seconds{quantile="1"} 0.000370254
go_gc_duration_seconds_sum 0.005222777
go_gc_duration_seconds_count 76
# HELP go_goroutines Number of goroutines that currently exist.
# TYPE go_goroutines gauge
go_goroutines 77
# HELP go_info Information about the Go environment.
# TYPE go_info gauge
go_info{version="go1.22.4"} 1
# HELP go_memstats_alloc_bytes Number of bytes allocated and still in use.
# TYPE go_memstats_alloc_bytes gauge
go_memstats_alloc_bytes 7.9226e+06
# HELP go_memstats_alloc_bytes_total Total number of bytes allocated, even if freed.
# TYPE go_memstats_alloc_bytes_total counter
go_memstats_alloc_bytes_total 3.23233208e+08
# HELP go_memstats_buck_hash_sys_bytes Number of bytes used by the profiling bucket hash table.
# TYPE go_memstats_buck_hash_sys_bytes gauge
go_memstats_buck_hash_sys_bytes 1.532818e+06
# HELP go_memstats_frees_total Total number of frees.
# TYPE go_memstats_frees_total counter
go_memstats_frees_total 3.568269e+06
# HELP go_memstats_gc_sys_bytes Number of bytes used for garbage collection system metadata.
# TYPE go_memstats_gc_sys_bytes gauge
go_memstats_gc_sys_bytes 3.737056e+06
# HELP go_memstats_heap_alloc_bytes Number of heap bytes allocated and still in use.
# TYPE go_memstats_heap_alloc_bytes gauge
go_memstats_heap_alloc_bytes 7.9226e+06
# HELP go_memstats_heap_idle_bytes Number of heap bytes waiting to be used.
# TYPE go_memstats_heap_idle_bytes gauge
go_memstats_heap_idle_bytes 8.634368e+06
# HELP go_memstats_heap_inuse_bytes Number of heap bytes that are in use.
# TYPE go_memstats_heap_inuse_bytes gauge
go_memstats_heap_inuse_bytes 1.1190272e+07
# HELP go_memstats_heap_objects Number of allocated objects.
# TYPE go_memstats_heap_objects gauge
go_memstats_heap_objects 38430
# HELP go_memstats_heap_released_bytes Number of heap bytes released to OS.
# TYPE go_memstats_heap_released_bytes gauge
go_memstats_heap_released_bytes 5.758976e+06
# HELP go_memstats_heap_sys_bytes Number of heap bytes obtained from system.
# TYPE go_memstats_heap_sys_bytes gauge
go_memstats_heap_sys_bytes 1.982464e+07
# HELP go_memstats_last_gc_time_seconds Number of seconds since 1970 of last garbage collection.
# TYPE go_memstats_last_gc_time_seconds gauge
go_memstats_last_gc_time_seconds 1.7332894597458868e+09
# HELP go_memstats_lookups_total Total number of pointer lookups.
# TYPE go_memstats_lookups_total counter
go_memstats_lookups_total 0
# HELP go_memstats_mallocs_total Total number of mallocs.
# TYPE go_memstats_mallocs_total counter
go_memstats_mallocs_total 3.606699e+06
# HELP go_memstats_mcache_inuse_bytes Number of bytes in use by mcache structures.
# TYPE go_memstats_mcache_inuse_bytes gauge
go_memstats_mcache_inuse_bytes 2400
# HELP go_memstats_mcache_sys_bytes Number of bytes used for mcache structures obtained from system.
# TYPE go_memstats_mcache_sys_bytes gauge
go_memstats_mcache_sys_bytes 15600
# HELP go_memstats_mspan_inuse_bytes Number of bytes in use by mspan structures.
# TYPE go_memstats_mspan_inuse_bytes gauge
go_memstats_mspan_inuse_bytes 156960
# HELP go_memstats_mspan_sys_bytes Number of bytes used for mspan structures obtained from system.
# TYPE go_memstats_mspan_sys_bytes gauge
go_memstats_mspan_sys_bytes 212160
# HELP go_memstats_next_gc_bytes Number of heap bytes when next garbage collection will take place.
# TYPE go_memstats_next_gc_bytes gauge
go_memstats_next_gc_bytes 1.488544e+07
# HELP go_memstats_other_sys_bytes Number of bytes used for other system allocations.
# TYPE go_memstats_other_sys_bytes gauge
go_memstats_other_sys_bytes 651750
# HELP go_memstats_stack_inuse_bytes Number of bytes in use by the stack allocator.
# TYPE go_memstats_stack_inuse_bytes gauge
go_memstats_stack_inuse_bytes 1.114112e+06
# HELP go_memstats_stack_sys_bytes Number of bytes obtained from system for stack allocator.
# TYPE go_memstats_stack_sys_bytes gauge
go_memstats_stack_sys_bytes 1.114112e+06
# HELP go_memstats_sys_bytes Number of bytes obtained from system.
# TYPE go_memstats_sys_bytes gauge
go_memstats_sys_bytes 2.7088136e+07
# HELP go_threads Number of OS threads created.
# TYPE go_threads gauge
go_threads 12
# HELP cluster_pg_data_disk_size_total The total size of the data disk of the cluster, unit: GiB.
# TYPE cluster_pg_data_disk_size_total gauge
cluster_pg_data_disk_size_total 15
# HELP cluster_pg_data_disk_size_used The used size of the data disk of the cluster, unit: GiB.
# TYPE cluster_pg_data_disk_size_used gauge
cluster_pg_data_disk_size_used 0.77
# HELP cluster_cpu_utilization The CPU utilization of the cluster, percentage.
# TYPE cluster_cpu_utilization gauge
cluster_cpu_utilization 0.39
# HELP cluster_memory_usage The memory usage of the cluster, unit: MiB.
# TYPE cluster_memory_usage gauge
cluster_memory_usage 108.34

4 - 管理

管理项目、集群、RBAC 权限授权、备份恢复、扩容升级、API 密钥、Terraform 以及外部索引工作流。

4.1 - 云端对象层级结构概览

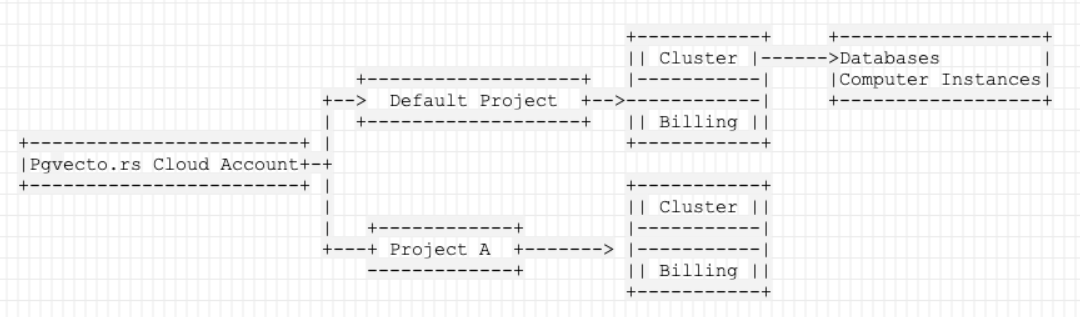
管理您的 VectorChord Cloud 项目需要了解其对象层级结构。下图展示了云端各对象之间的关系,下文对每个对象进行了详细说明。
管理您的 VectorChord Cloud 项目需要了解其对象层级结构。下图展示了云端各对象之间的关系,下文对每个对象进行了详细说明。

VectorChord Cloud 账户

这是您用于注册 VectorChord Cloud 的账户。目前支持使用 GitHub 账户注册。

项目

项目(Project)是层级结构中的顶层对象。它是该项目下所有集群和计费信息的容器。有关更多信息,请参阅项目。

集群

一个项目可以包含一个或多个集群(Cluster)。集群是运行单个 Postgres 集群的一组节点集合。有关更多信息,请参阅集群。

计算实例

一个集群可以包含一个或多个计算实例(Compute Instance)。计算实例是运行 Postgres 实例的虚拟机。

数据库

每个集群包含两个默认数据库:postgres 以及您在创建集群时命名的数据库。集群就绪后,您可以使用 psql 在集群中创建更多数据库。

4.2 - 项目

在 VectorChord Cloud 中,一切都从项目开始。它是层级结构中的顶层对象,一个项目可以根据需要容纳任意数量的 Postgres 集群。

在 VectorChord Cloud 中,一切都从项目(Project)开始。它是层级结构中的顶层对象。一个项目可以根据需要容纳任意数量的 Postgres 集群。您最多可以创建和加入 5 个项目。

通过以下章节进一步了解项目及其管理方式:

项目设置

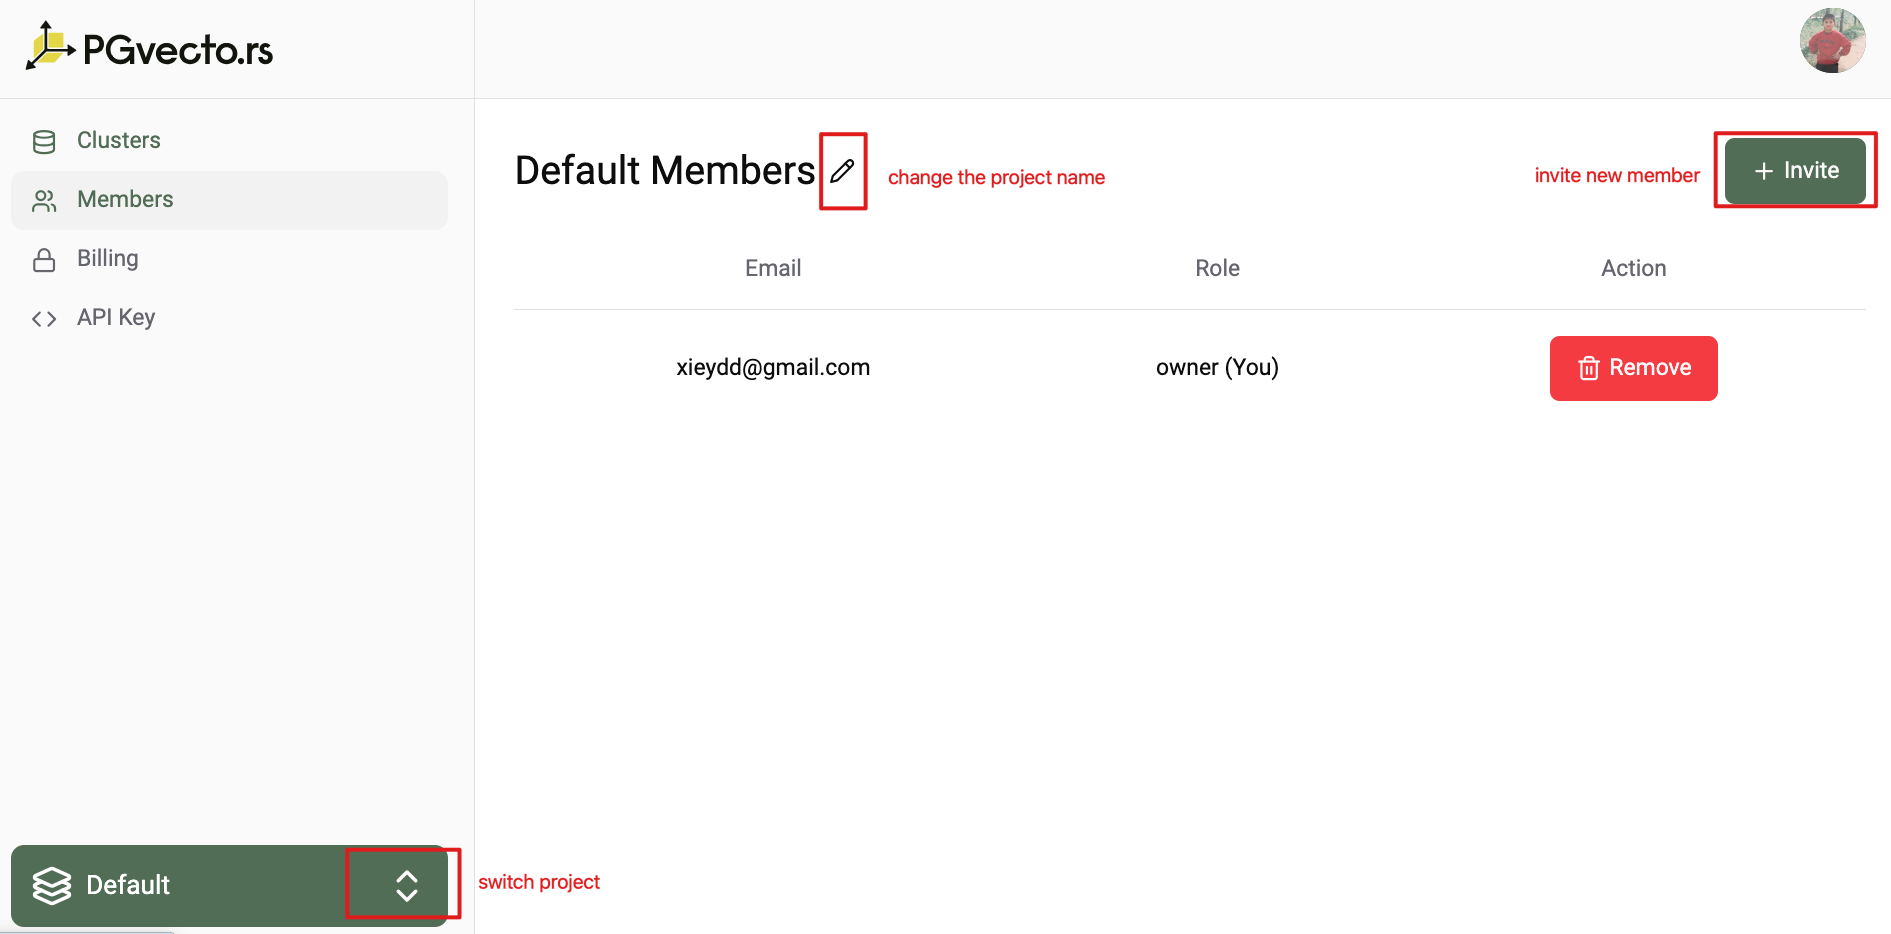
在项目设置中,您可以查看和编辑项目信息。点击页面左下角的项目名称即可切换到其他项目。默认项目是您注册时系统为您创建的第一个项目。如下图所示,您可以修改项目名称、邀请成员加入项目以及退出项目。
项目权限

您可以点击 Invite 按钮邀请其他用户加入您的项目。您可以通过电子邮件地址邀请用户,受邀用户将收到一封包含邀请链接的电子邮件,点击该链接即可接受邀请。

警告

如果受邀用户尚未注册 VectorChord Cloud 账户,则需要先注册一个账户,然后才能接受邀请。
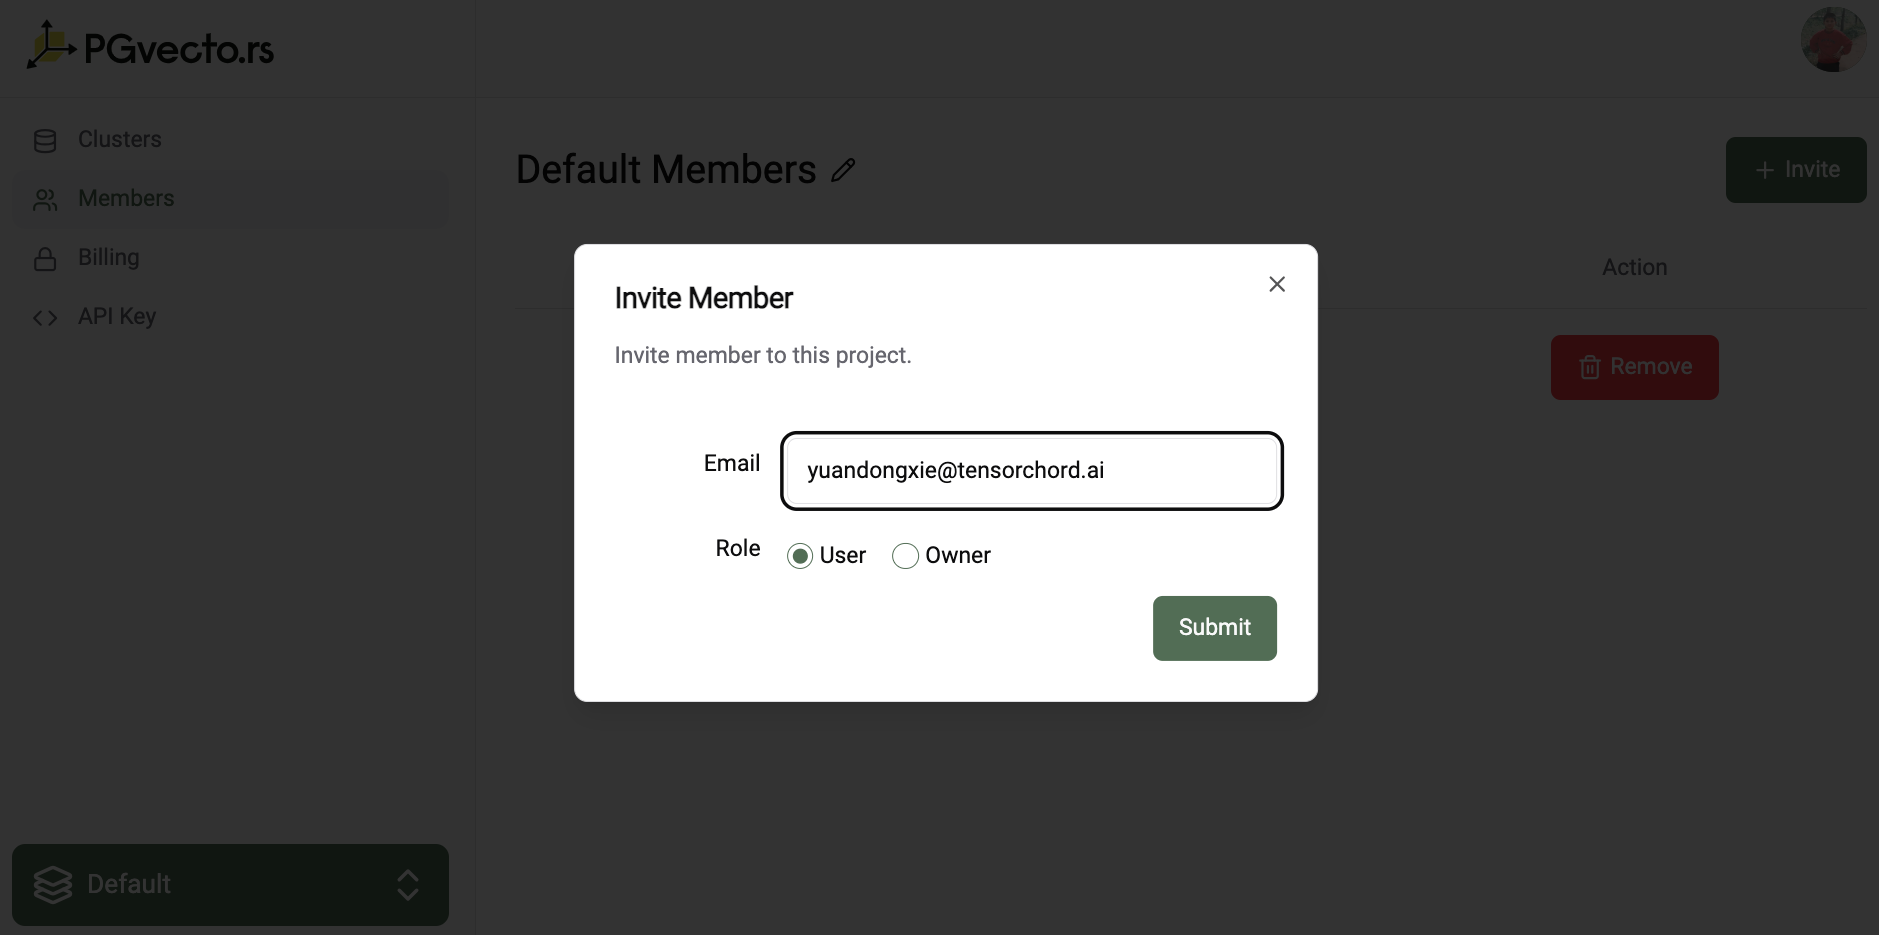
有关各个角色访问权限级别的更多信息,请参阅权限与授权。

项目计费

每个项目都有一个专属计费页面,您可以在其中查看计费信息。在计费页面中,您可以添加支付方式并查看账单发票。
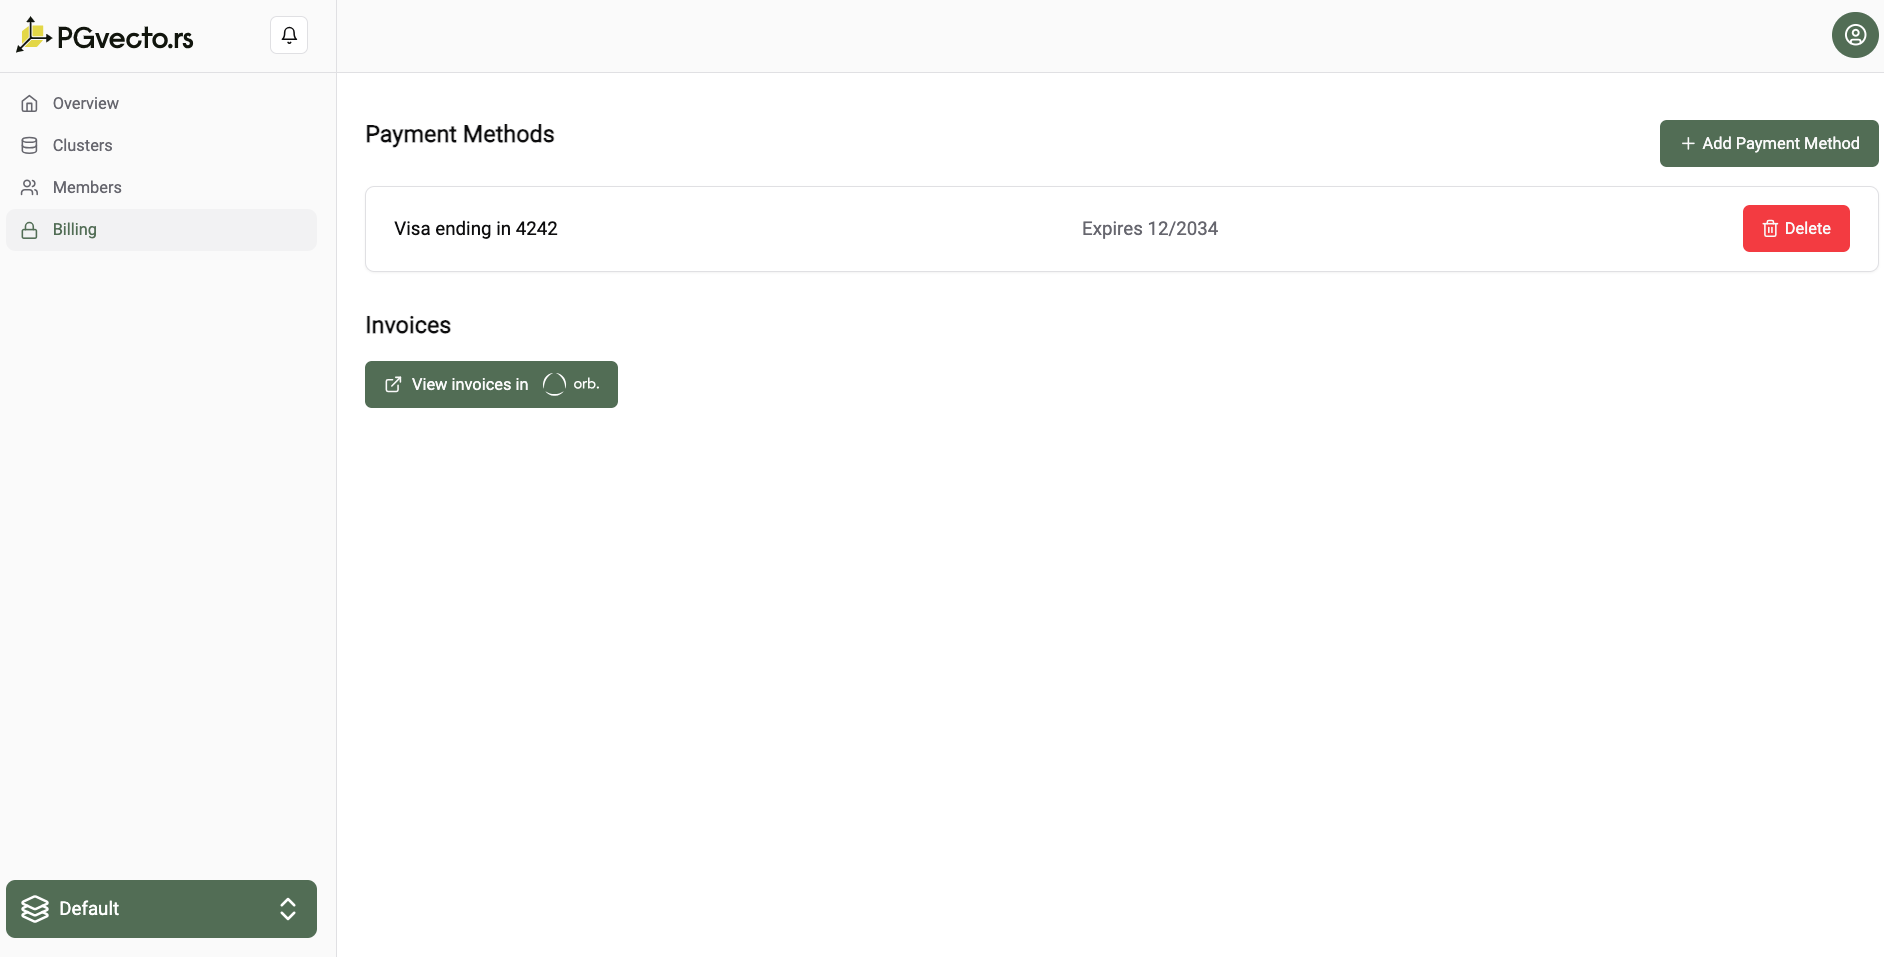
4.3 - 集群

一个项目中可以创建一个或多个集群。集群是运行单个 Postgres 集群的一组节点集合。

一个项目中可以创建一个或多个集群。集群是运行单个 Postgres 集群的一组节点集合。

创建集群

要创建新集群,请前往 VectorChord Cloud 控制台并点击“Create Cluster”按钮。

您需要指定以下信息:

  • 必填项:
    • Plan(套餐):您希望用于该集群的套餐。有关 Cloud 付费套餐选项的详细信息,请参阅 Cloud 套餐。
    • Cluster Name(集群名称):集群的唯一名称。
    • Extension Settings(扩展设置):
      • Extension(扩展):我们支持两种向量搜索扩展:pgvectors 及其继任者 vectorchord

        • vectorchord:Postgres 中可扩展、快速且磁盘友好的向量搜索扩展
        • pgvectors:Postgres 中可扩展、低延迟且支持混合搜索的向量搜索扩展。革新向量搜索,而非更换数据库。
        警告

        vectorchord 仅支持配备 NVMe SSD 的服务器资源规格。

      • Image(镜像):

        • 对于 VectorChord,我们提供语义化版本格式的标签,例如 16-v0.1.0:
          • 16 表示 Postgres 主版本号
          • v0.1.0 表示 VectorChord 版本号
        • 对于 pgvecto.rs,我们提供语义化版本格式的标签,例如 16-v0.4.0-vectors-exts:
          • 16 表示 Postgres 主版本号
          • v0.4.0 表示 pgvecto.rs 版本号
          • vectors 表示 pgvecto.rs schema 的安装位置,可选值为 vectors、extensions、public。如果您希望在 AWS RDS 上搭配使用 VectorChord Cloud,请选择 public。如果您打算在 Supabase 上使用 FDW,请选择 extensions。
          • exts 表示集群支持从 https://pgt.dev/ 安装扩展。
    • Cloud Provider Settings(云厂商设置):
      • Cloud Provider(云厂商):部署集群的云服务提供商,目前仅支持 AWS。
      • Region(区域):部署集群所在的区域。
    • Resource Settings(资源设置):
      • Type(类型):我们提供两种资源类型:Performance(性能型)和 Capacity(容量型)。
      • Server Resource(服务器资源规格):
        • Performance(性能型):
          • 1C/2G:免费套餐,1 核 CPU、2GB 内存和 3Gi 磁盘空间。
          • 2C/8G:企业版套餐,2 核 CPU、8GB 内存和 15Gi 磁盘空间。
          • 2C/16G:企业版套餐,2 核 CPU、16GB 内存和 15Gi 磁盘空间。
          • 4C/32G:企业版套餐,4 核 CPU、32GB 内存和 90Gi 磁盘空间。
        • Capacity(容量型):
          • 4C/32G NVMe SSD:企业版套餐,4 核 CPU、32GB 内存和 850Gi NVMe SSD 磁盘空间。
    • Postgres Settings(Postgres 设置):
      • Database Name(数据库名称):用于存储向量数据的数据库名称。
      • Enable Connection Pooler(启用连接池,默认值:false):为集群启用连接池。
      • Enable Restore Config(启用恢复配置,默认值:false):启用恢复配置,以从其他集群创建的备份进行恢复。
      • Optional(可选项):
        • Disk Size(磁盘大小):Postgres PGData 磁盘大小,将覆盖默认磁盘大小。
        • Instances(实例数):集群中的实例数量,默认值为 1。
        警告

        目前向量索引尚不支持流复制(Streaming Replication)。

删除集群

如果您想删除集群,请前往 VectorChord Cloud 控制台并点击“Delete”按钮。
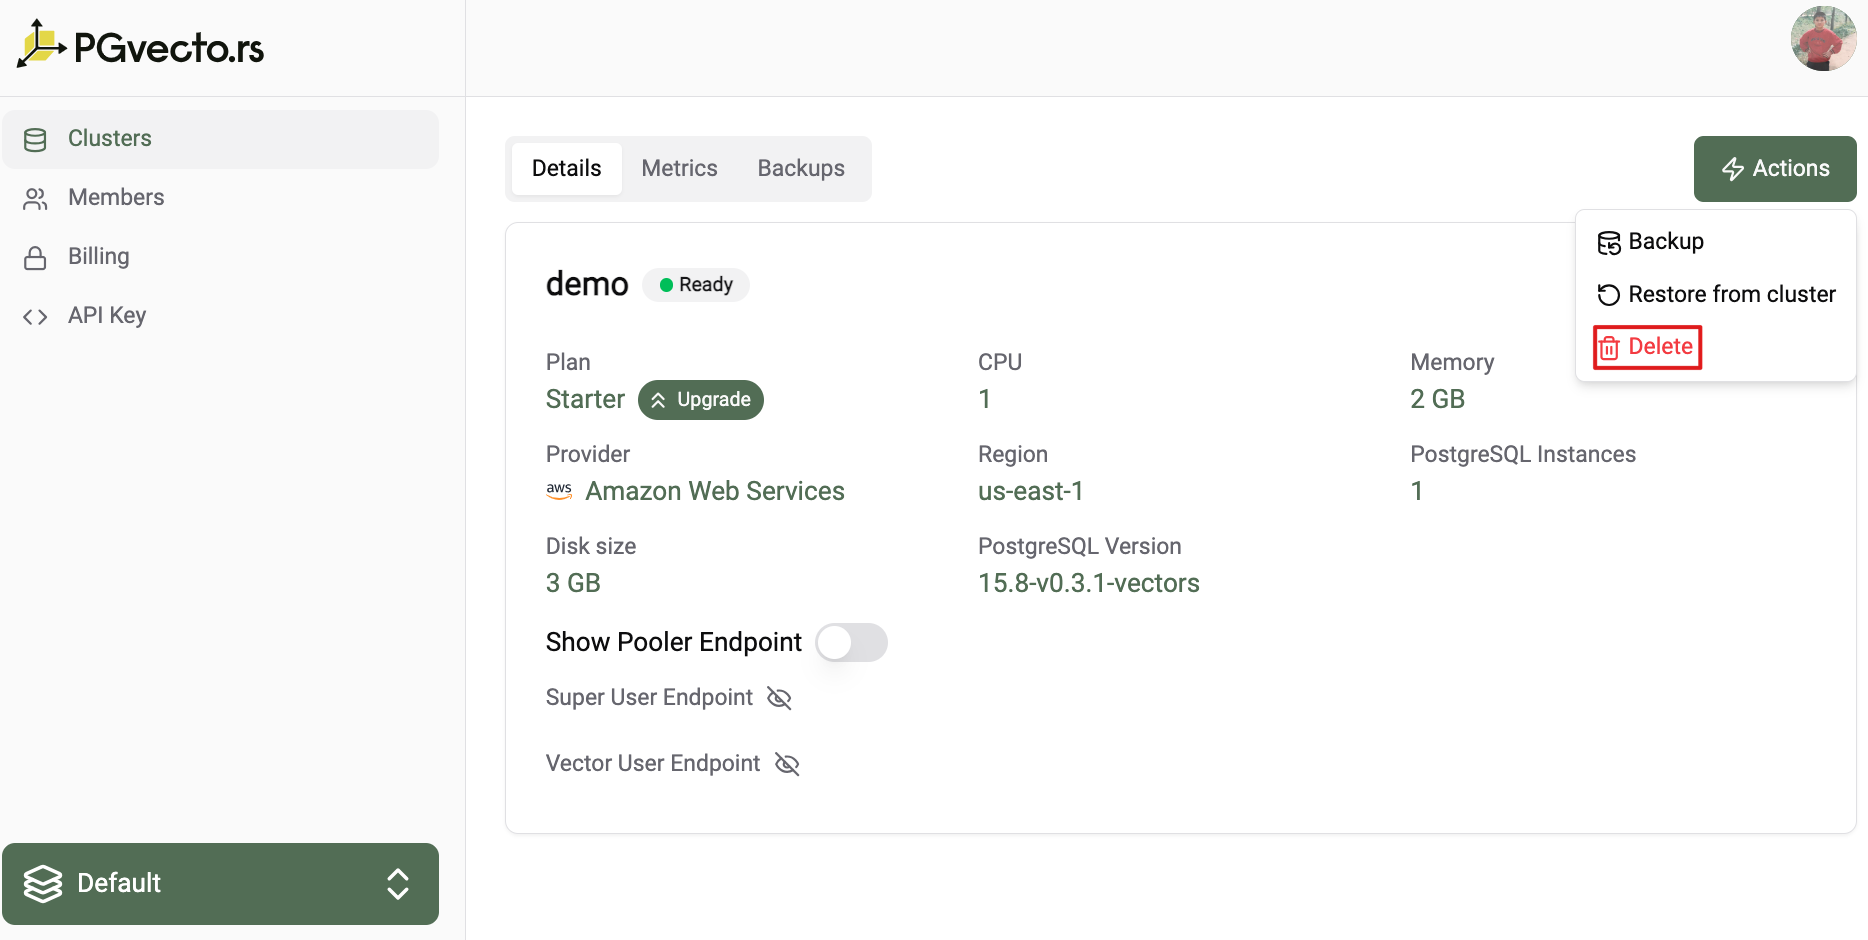
警告

一旦删除该集群,Postgres 中的所有数据(包括 WAL 日志)以及集群中自动创建或按需创建的备份也将一并被删除。

集群监控

您可以在集群信息页面查看集群的 CPU 和内存使用情况,还可以查看索引信息,例如索引中的向量数量、向量维度等。有关监控的详细信息,请参阅监控。

4.4 - 权限与授权

与 VectorChord Cloud 集群上的基于角色的访问控制(RBAC)相关的主题。

与 VectorChord Cloud 集群上的基于角色的访问控制(RBAC)相关的主题。

用户角色

我们为项目提供两种类型的用户角色:Owner(所有者)和 Member(成员)。

  • Owner:所有者对项目拥有完全访问权限。所有者可以邀请成员、创建或删除集群,以及查看计费信息。
  • Member:成员对项目拥有只读访问权限。成员可以查看集群信息,但不能创建或删除集群。

API 密钥角色

API 密钥通过为项目内的用户分配具有特定权限的角色,提供对资源的更细粒度访问控制。我们为 API 密钥提供两种类型的角色:Owner(所有者)和 Member(成员)。

  • Owner:所有者对项目集群拥有完全访问权限。
  • Member:成员对项目集群拥有只读访问权限。不过,您可以指定该成员拥有完全访问权限的特定集群。
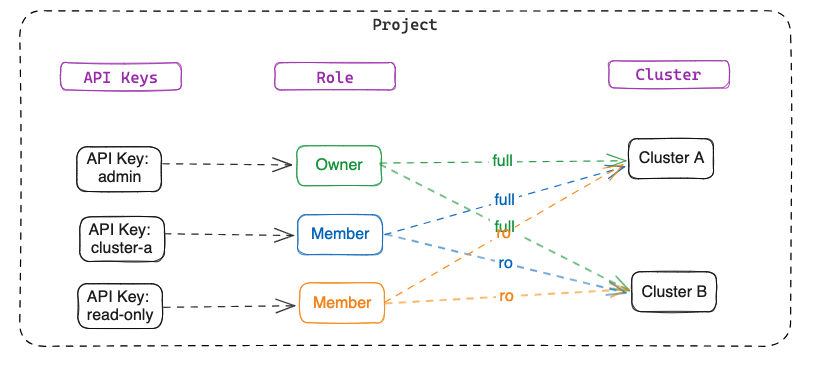
资源层级结构

有关对象层级结构的更多信息,请参阅云端对象层级结构概览。

4.5 - 备份与恢复

数据库备份是任何灾难恢复计划中不可或缺的一部分。通过数据库备份,您可以在灾难发生时将项目恢复到任意时间点,从而化解危机。

数据库备份是任何灾难恢复计划中不可或缺的一部分。灾难的形式多种多样,可能小到不小心误删了表中的一列、数据库崩溃,甚至大到自然灾害彻底损毁了数据库所运行的底层硬件。这些场景带来的风险和影响永远无法完全消除,只能尽可能降低或缓解。拥有数据库备份就像购买了一份保险:它们本质上是数据库在不同时间点的快照。当灾难来临时,数据库备份能够将项目恢复到这些时间点中的任意一个,从而化解危机。

警告

一旦您删除该集群或项目,Postgres 中的所有数据(包括 WAL 日志)以及集群中自动创建或按需创建的备份也将一并被删除。

备份

概念

  • WAL 归档(WAL archive):用于存放 Postgres 持续写入并归档以保障数据持久性的 WAL 文件(事务日志)的存储位置。
  • 物理基础备份(Physical base backups):PostgreSQL 用于在数据库中存储数据的所有文件(主要是 PGDATA 和所有表空间)的完整副本。

自动备份

集群创建完成后,默认启用自动备份功能。系统每天会自动执行一次物理基础备份,并保留 7 天。备份存储在 AWS S3 中,AWS S3 的保留策略设置为 90 天。

与此同时,WAL(预写式日志,Write-Ahead Logging)每 5 分钟归档一次。如果这些文件超过特定的文件大小阈值,则会立即触发备份。因此,在事务量较高的时段,WAL 文件备份会更加频繁;反之,当数据库没有活动时,则不会生成 WAL 文件备份。总体而言,这意味着在最坏情况或发生灾难时,按时间点恢复(PITR,Point-In-Time Recovery)能够实现 5 分钟的恢复点目标(RPO)。

按需备份

如果您希望在特定时间点创建备份,可以创建按需备份(On-demand Backup)。按需备份是数据库集群的物理基础备份,默认保留 7 天。它们存储在 AWS S3 中,最长可保留 90 天。

您可以按照以下步骤创建按需备份:

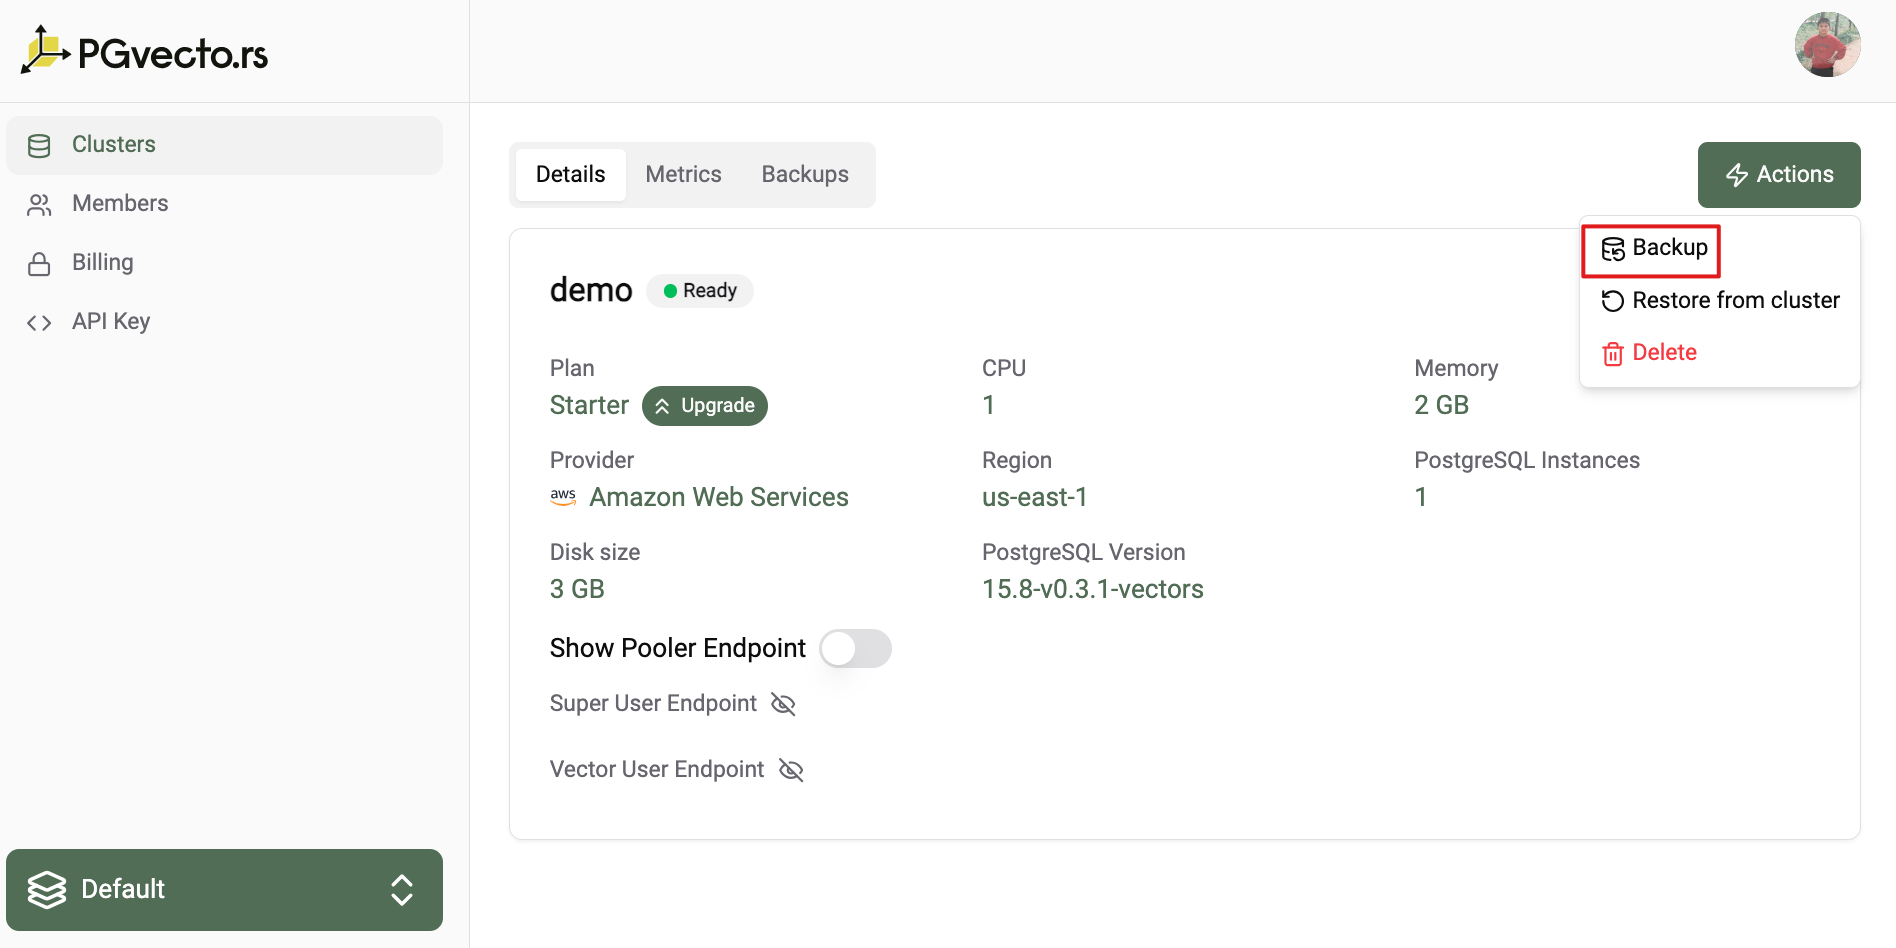
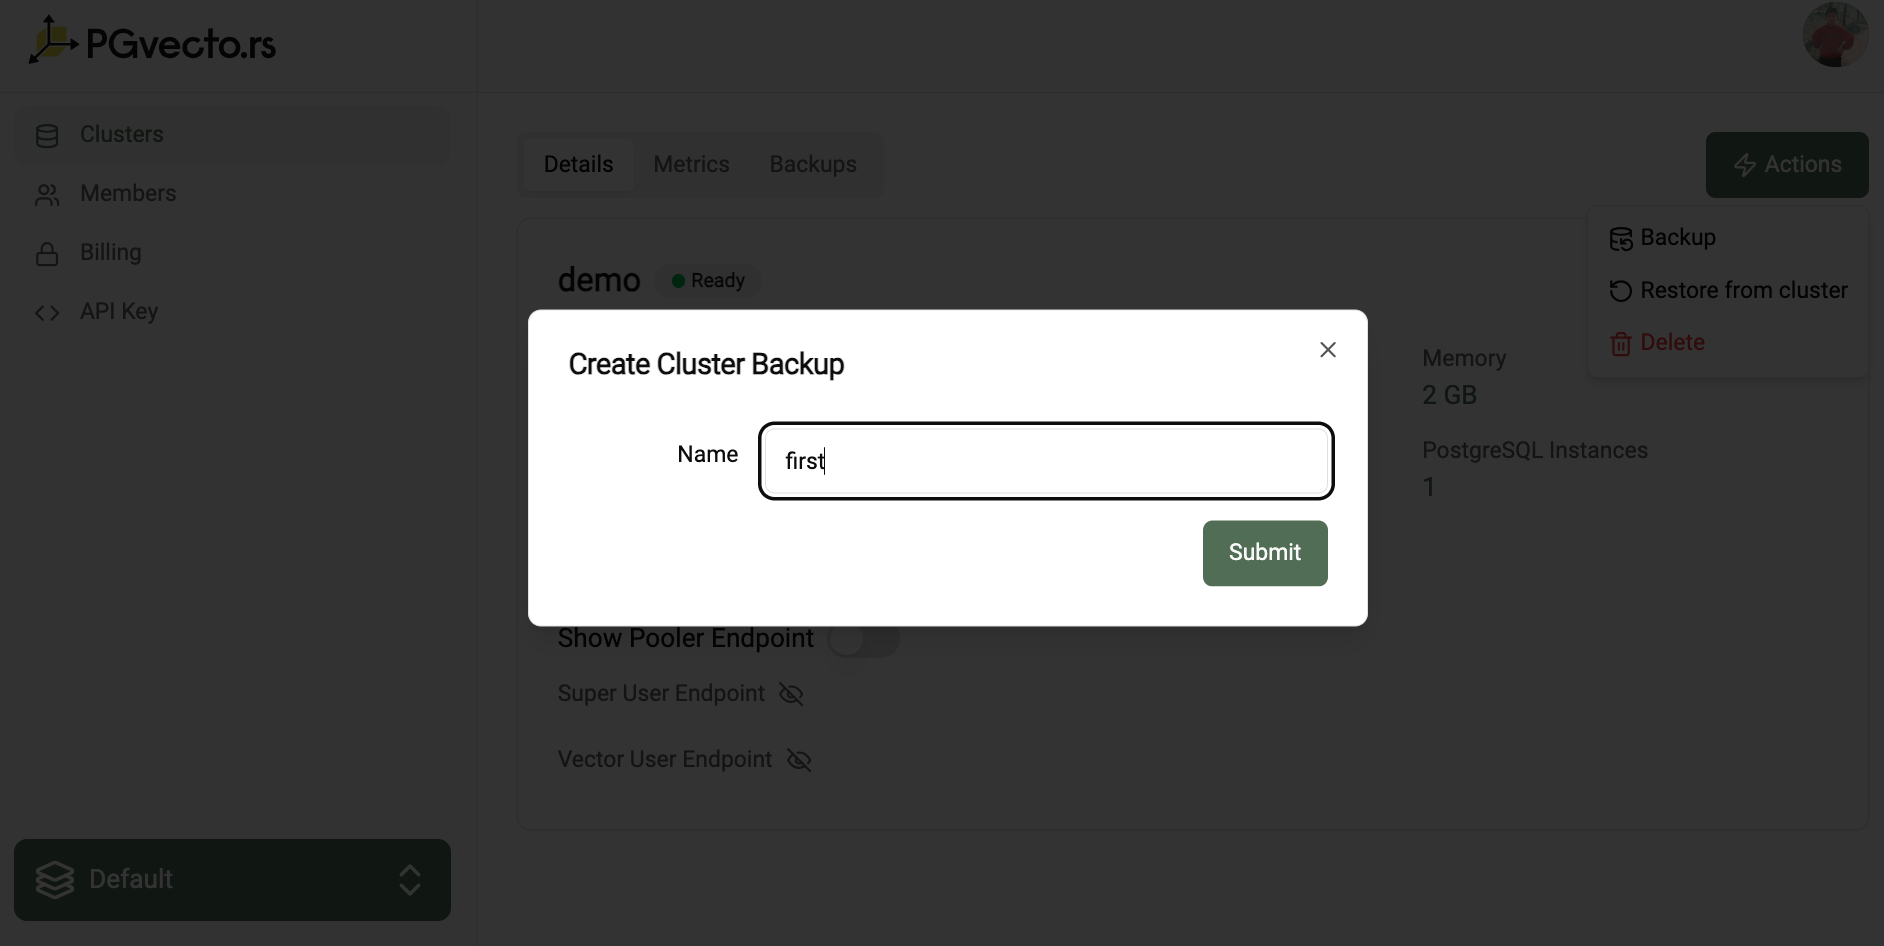
  • 点击 Actions 按钮并选择 Backup。
  • 为备份设置唯一名称。

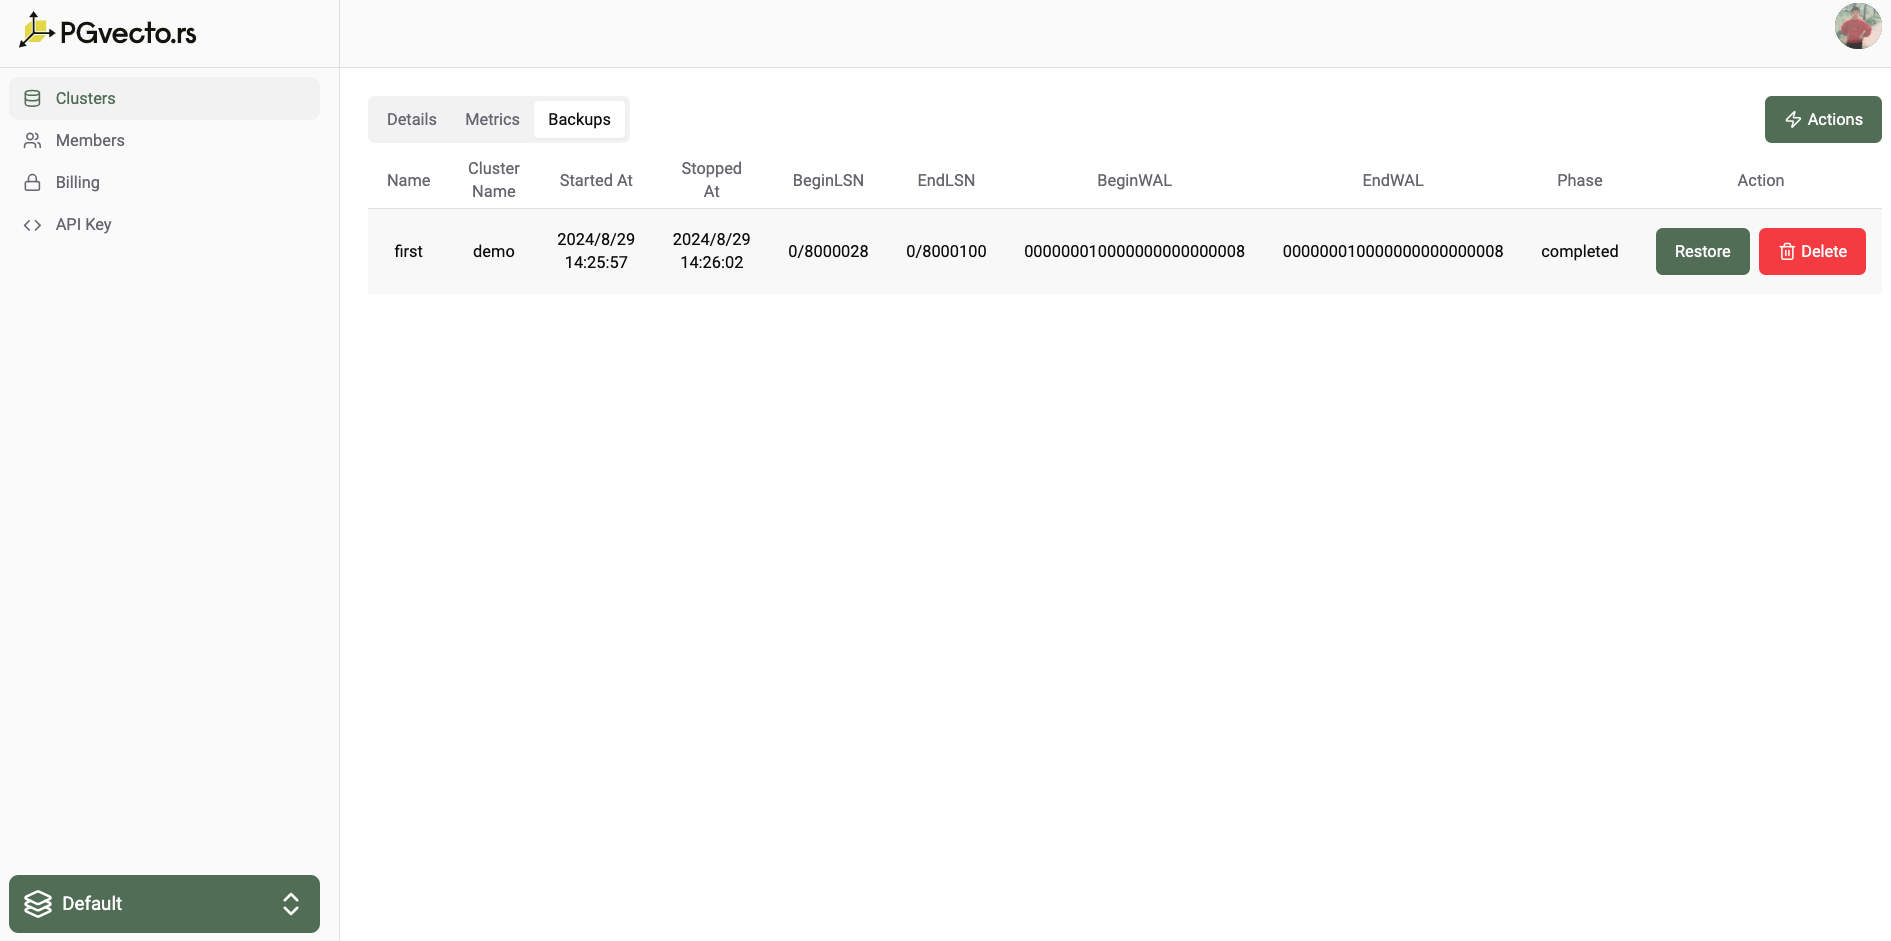
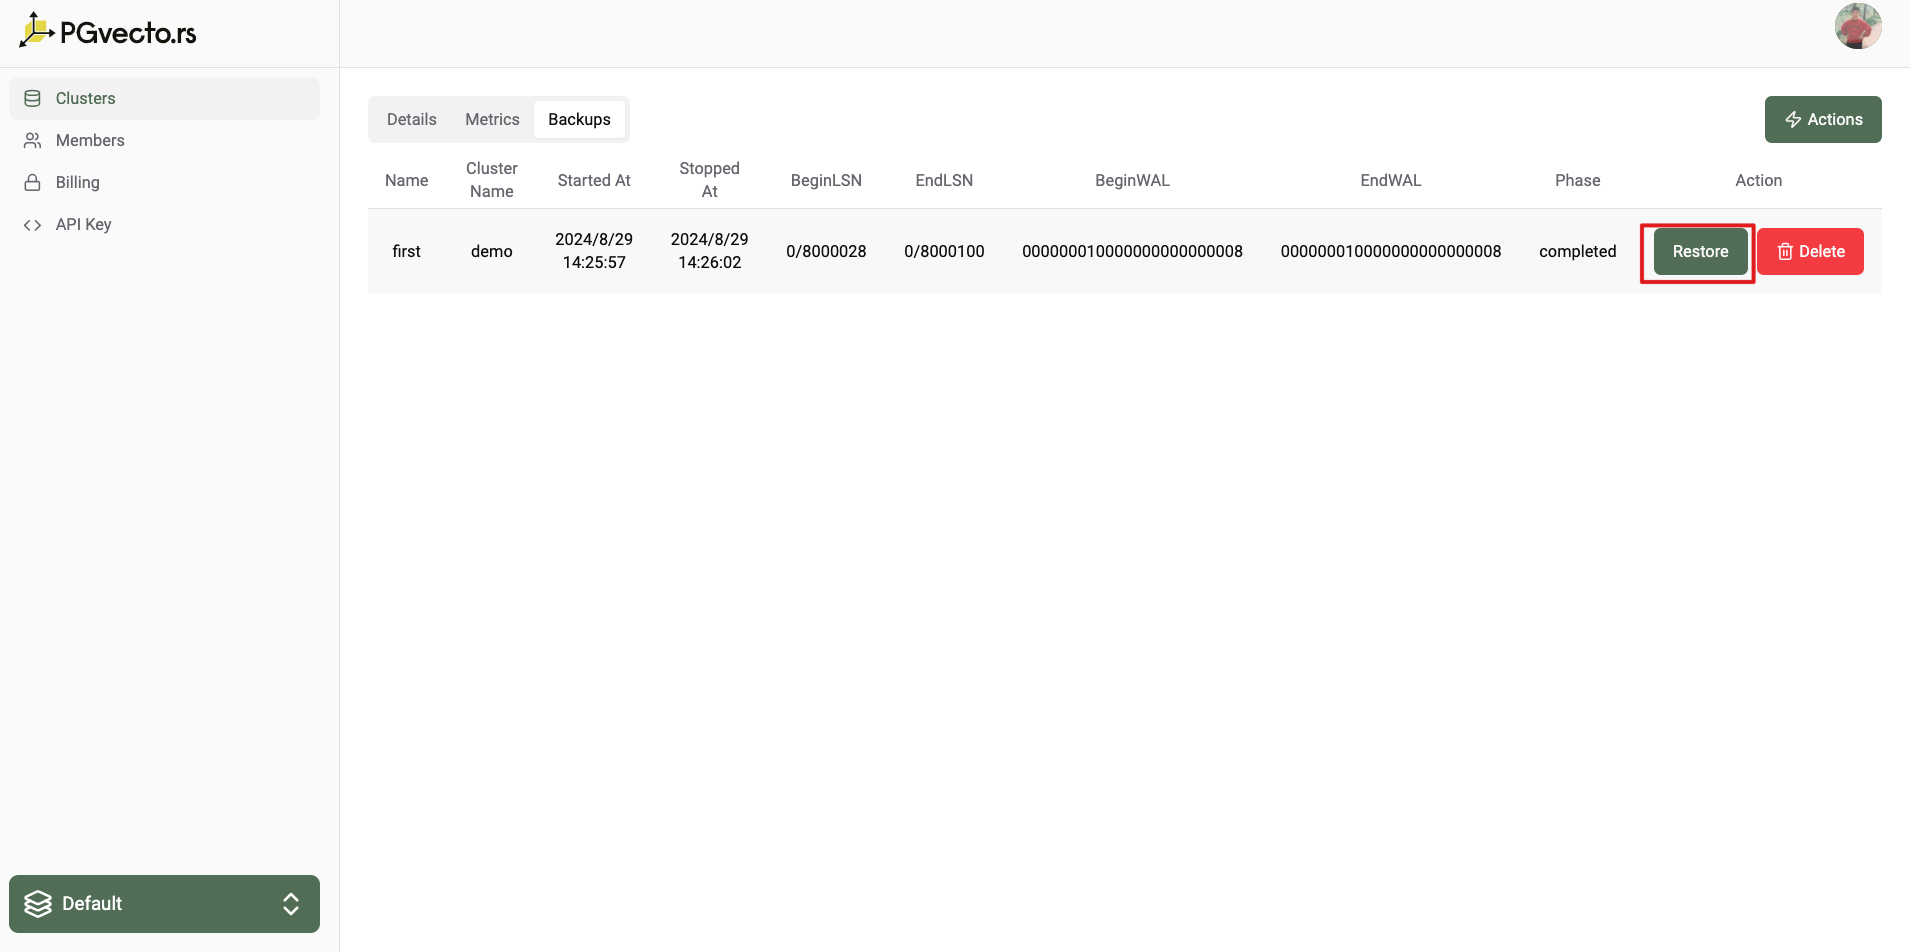
您可以在 Backups 标签页中查看备份信息,其中包括:

  • 备份名称(Backup name)
  • 备份所属的集群
  • 备份开始时间(Backup start time)
  • 备份结束时间(Backup end time)
  • 备份起始 LSN(日志序列号,Log Sequence Number)
  • 备份结束 LSN
  • 备份起始 WAL 段(WAL segment)
  • 备份结束 WAL 段
  • 备份阶段状态(Backup phase)

恢复

从集群恢复

按时间点恢复(PITR)允许以更短的时间间隔对集群进行持续备份保护,为用户提供精确到秒级粒度的任意时间点恢复能力。如果仅依赖每日备份,一旦发生故障仍可能丢失一整天的数据;而借助 PITR,可以将数据恢复到灾难发生前一刻。

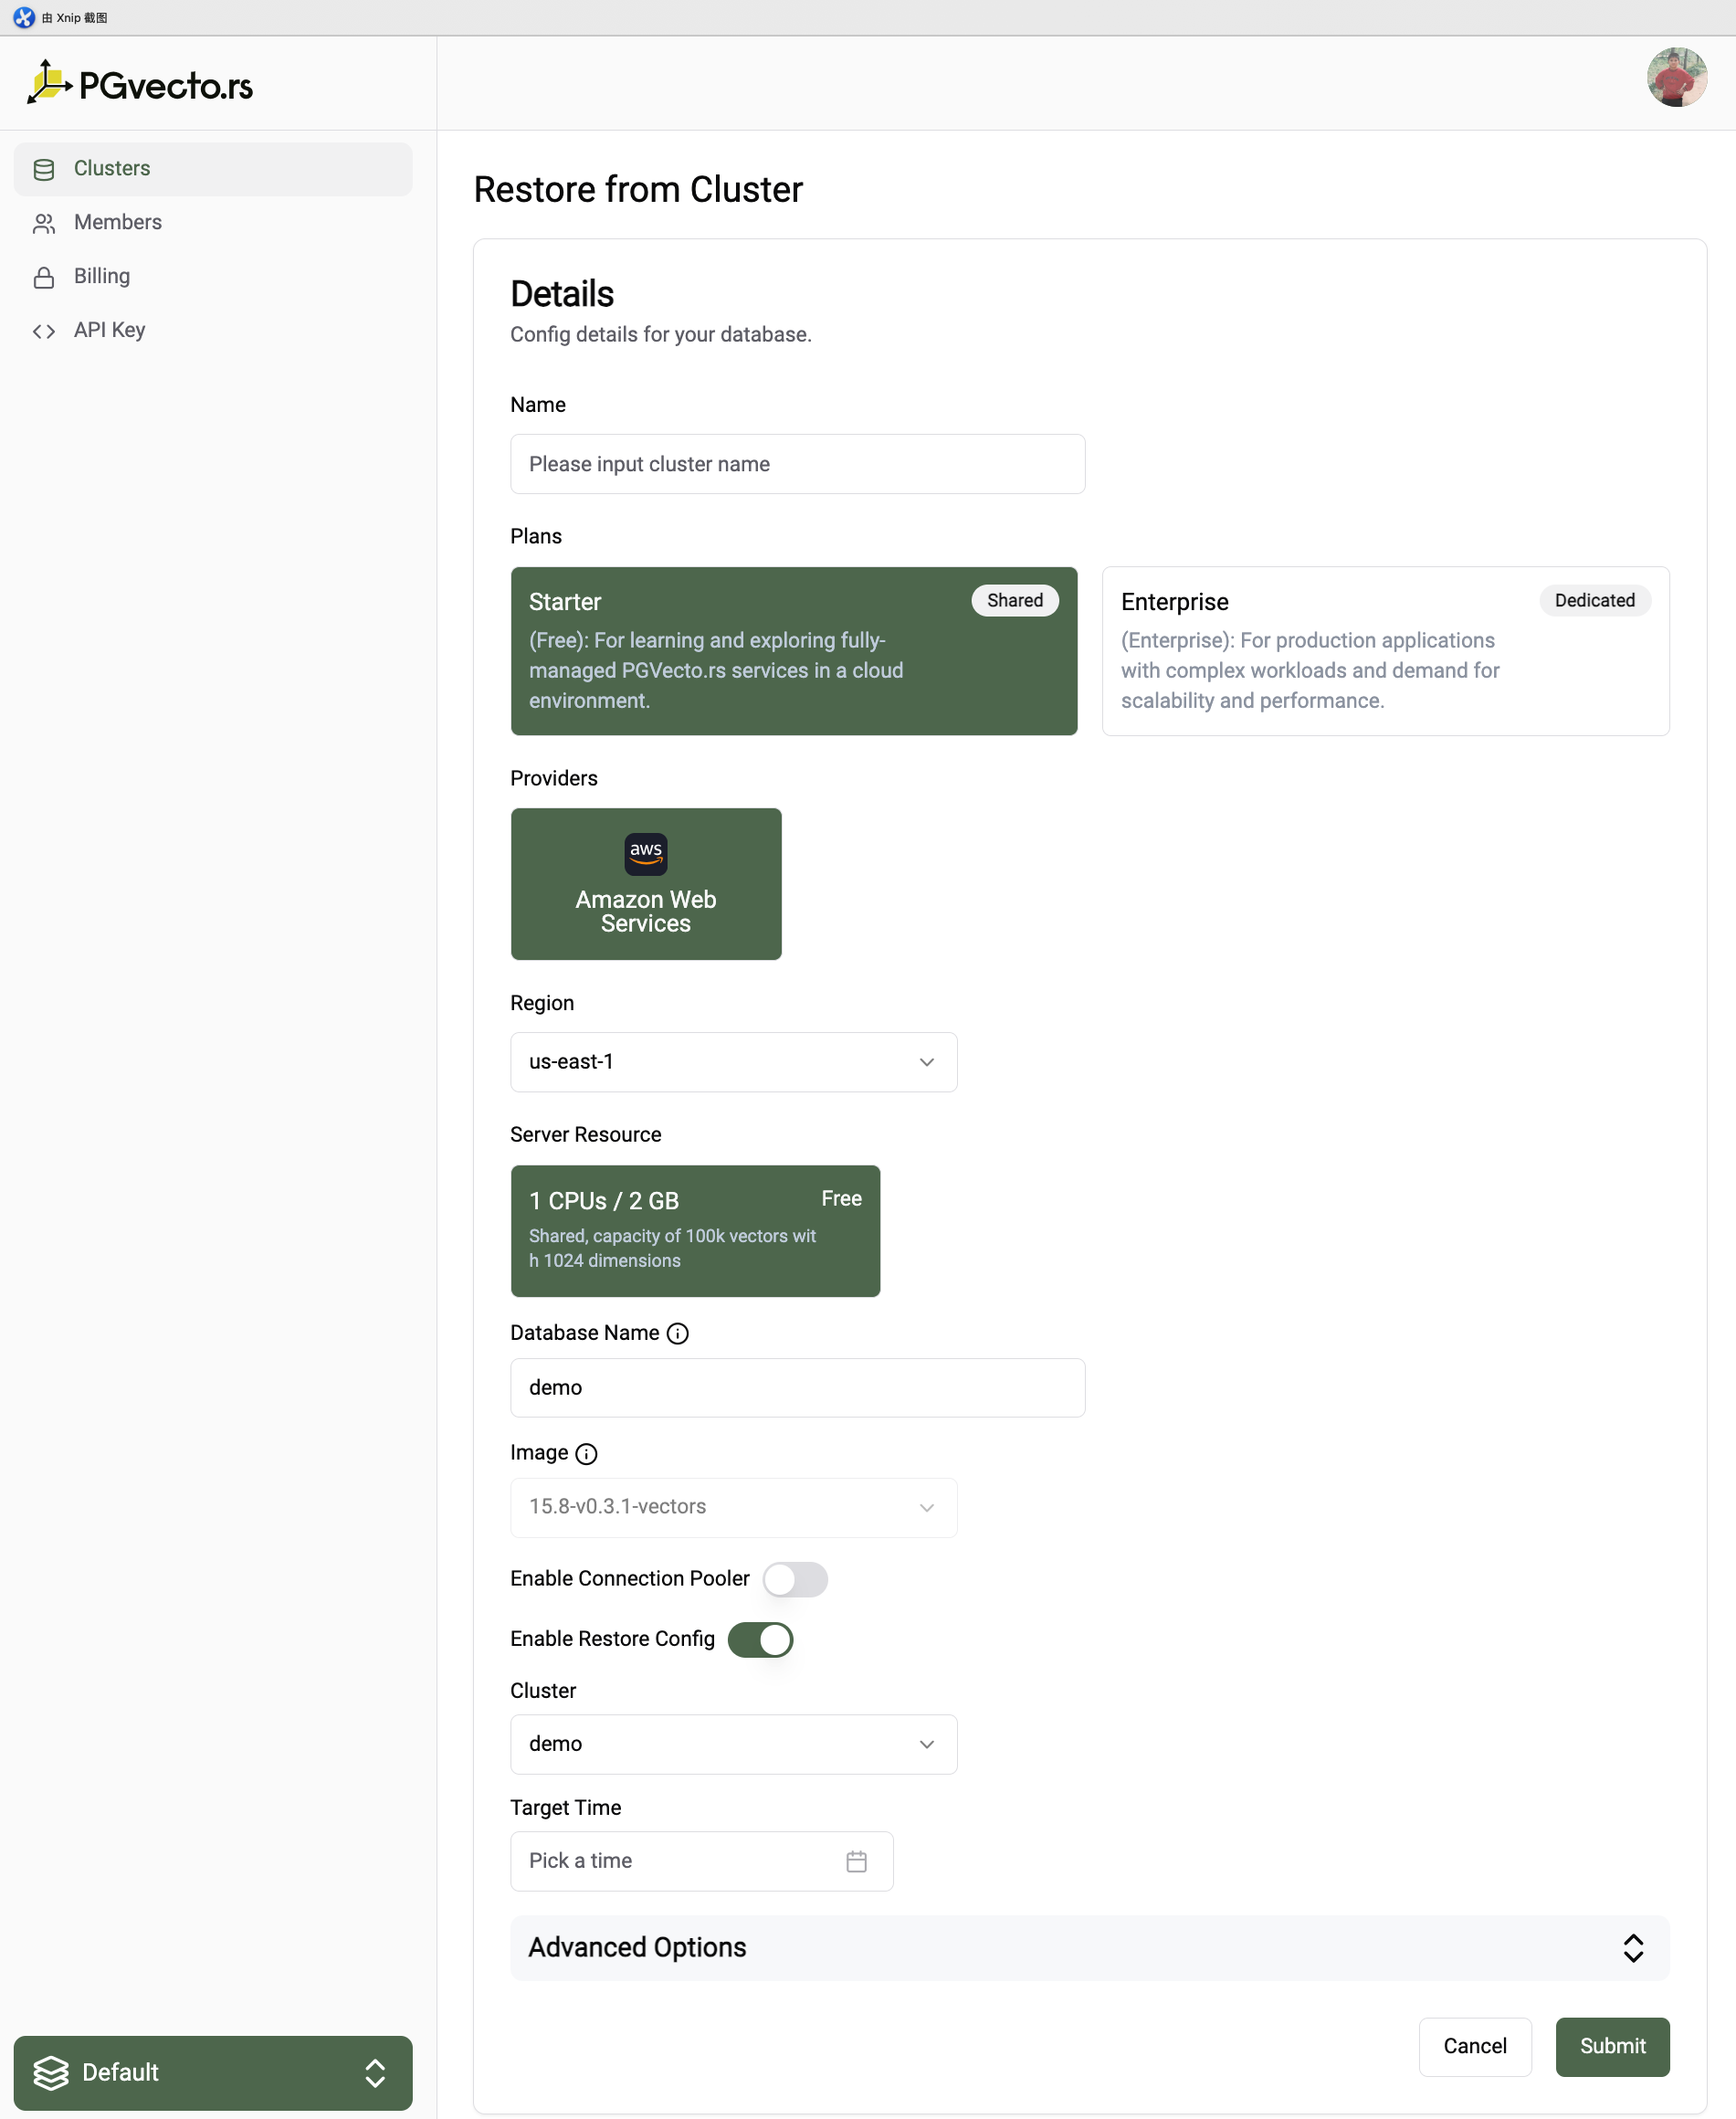
如果您想对集群执行 PITR 恢复,可以按照以下步骤操作:

  • 进入集群详情页面。
  • 点击 Actions 按钮并选择 Restore from Cluster。
  • 选择要恢复到的目标服务器资源规格。
  • 选择要恢复到的目标时间点(Target Time)。
    警告

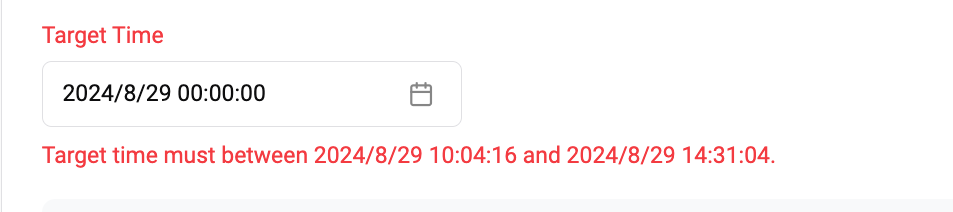
    目标时间点必须介于最早可恢复时间点(First Recoverability Point)与最后归档 WAL 时间(Last Archived WAL Time)之间。

从按需备份恢复

如果您想从按需备份进行恢复,可以按照以下步骤操作:

  • 进入集群的备份详情页面。
  • 点击 Actions 按钮并选择 Restore。
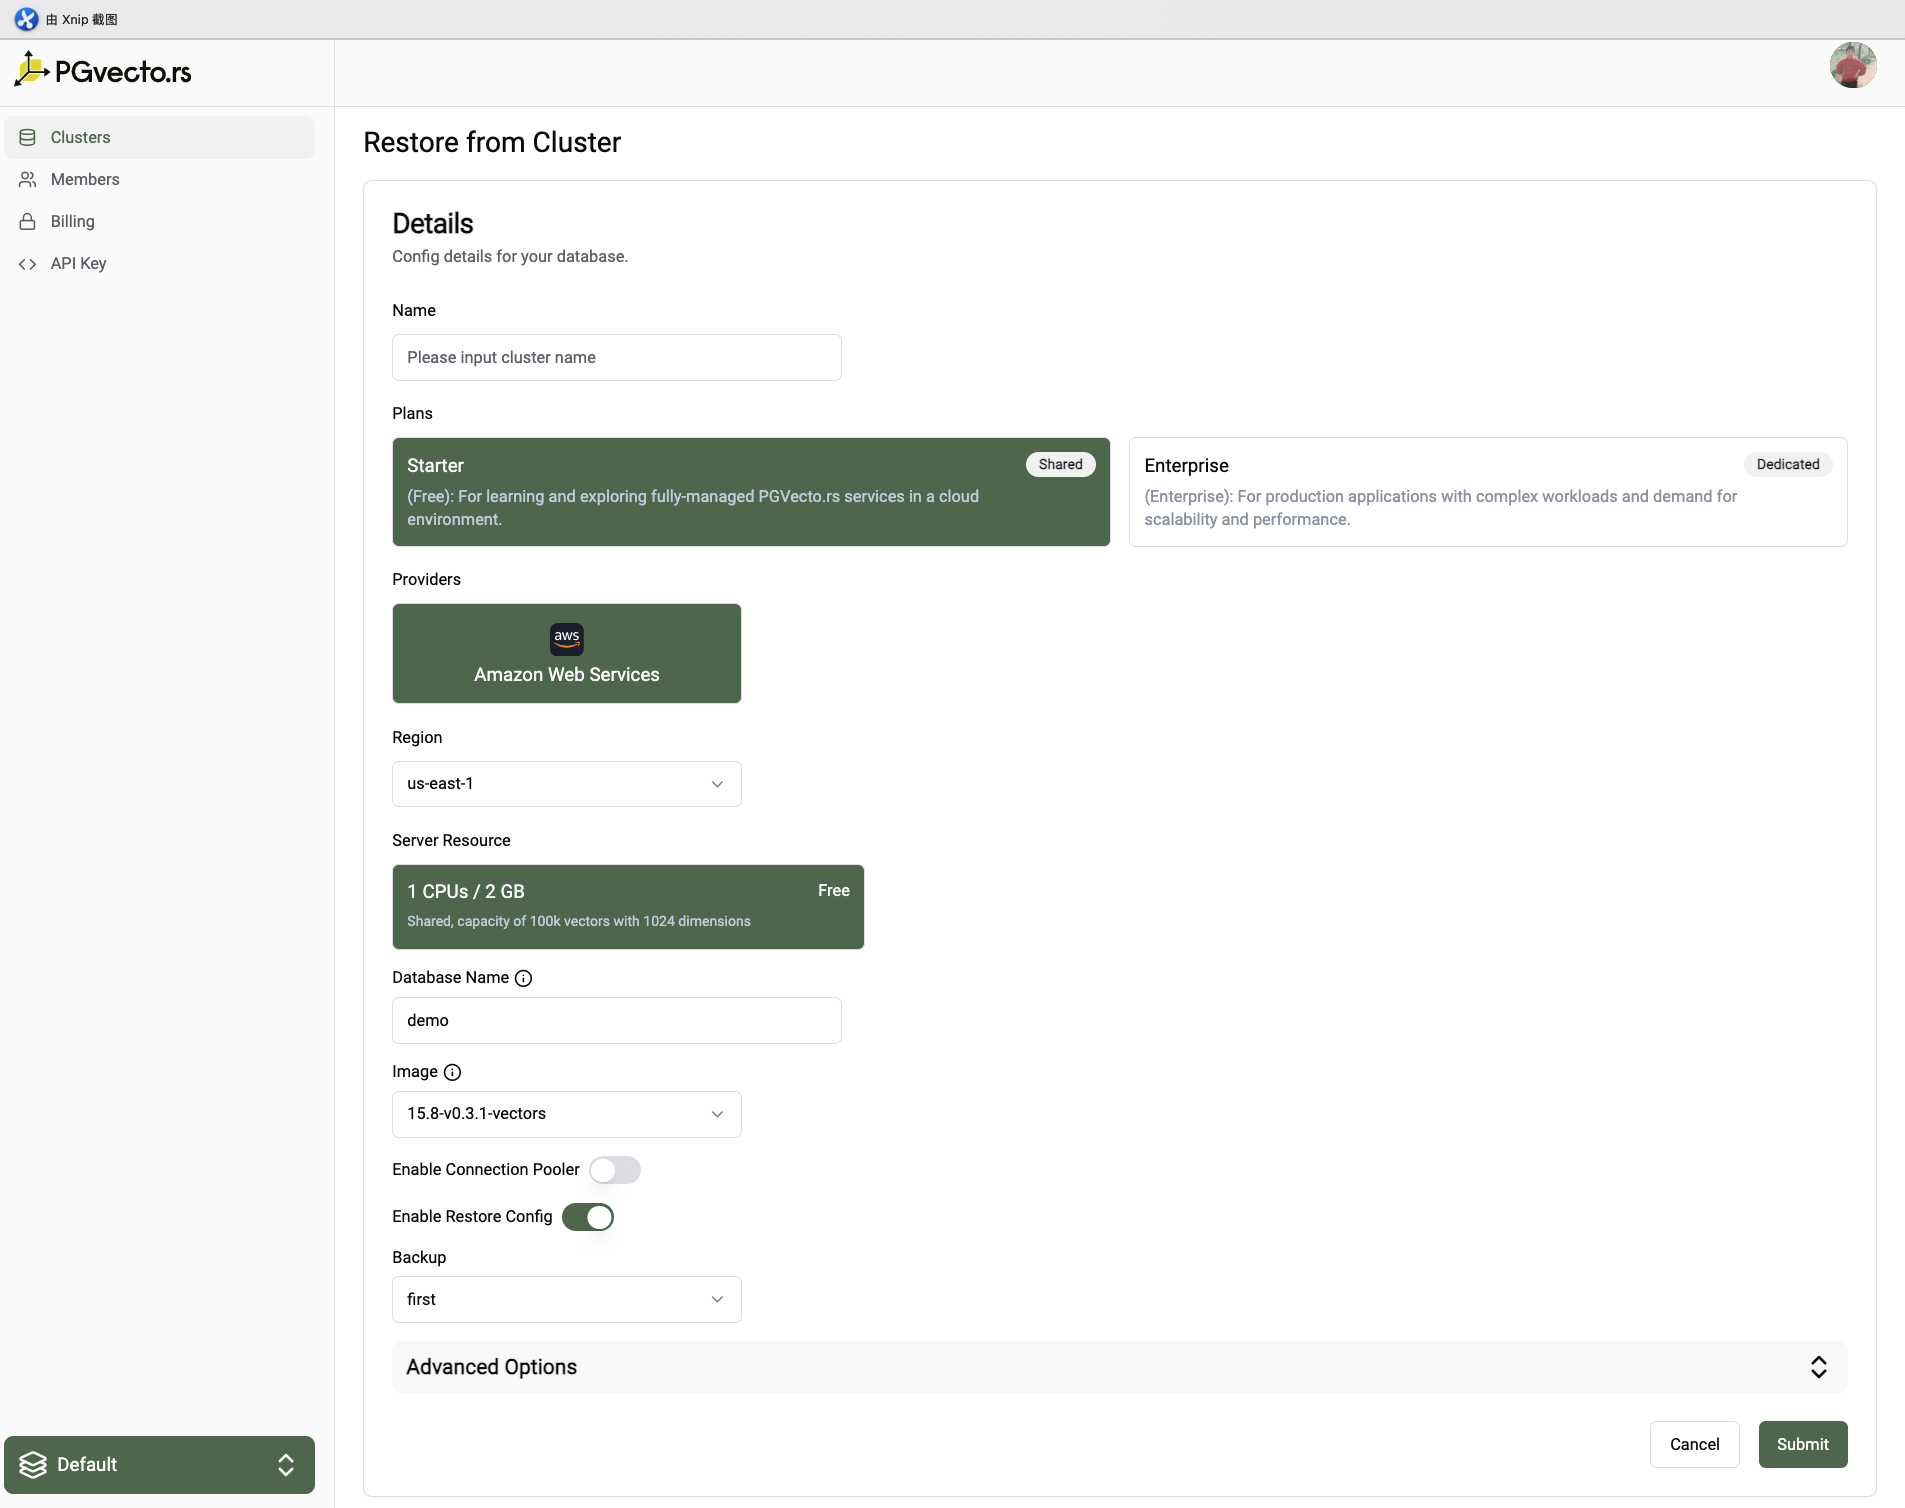
  • 选择要恢复到的目标服务器资源规格。
alt text
警告

恢复目标集群必须与备份具有相同的镜像(Image)、数据库名称(Database Name)和区域(Region),但从集群直接执行恢复(PITR)支持跨区域恢复。

4.6 - 升级集群

您可能需要升级集群且不希望丢失任何数据。您可以升级 CPU、内存等服务器资源,也可以仅扩容存储空间。

您可能需要升级集群且不希望丢失任何数据。您可以升级 CPU、内存等服务器资源,也可以仅扩容存储空间。以下章节将引导您完成集群升级流程。

扩容服务器资源

如果您想扩容 CPU 和内存等服务器资源,集群状态必须处于 Ready。在集群详情页面点击 Upgrade 按钮。
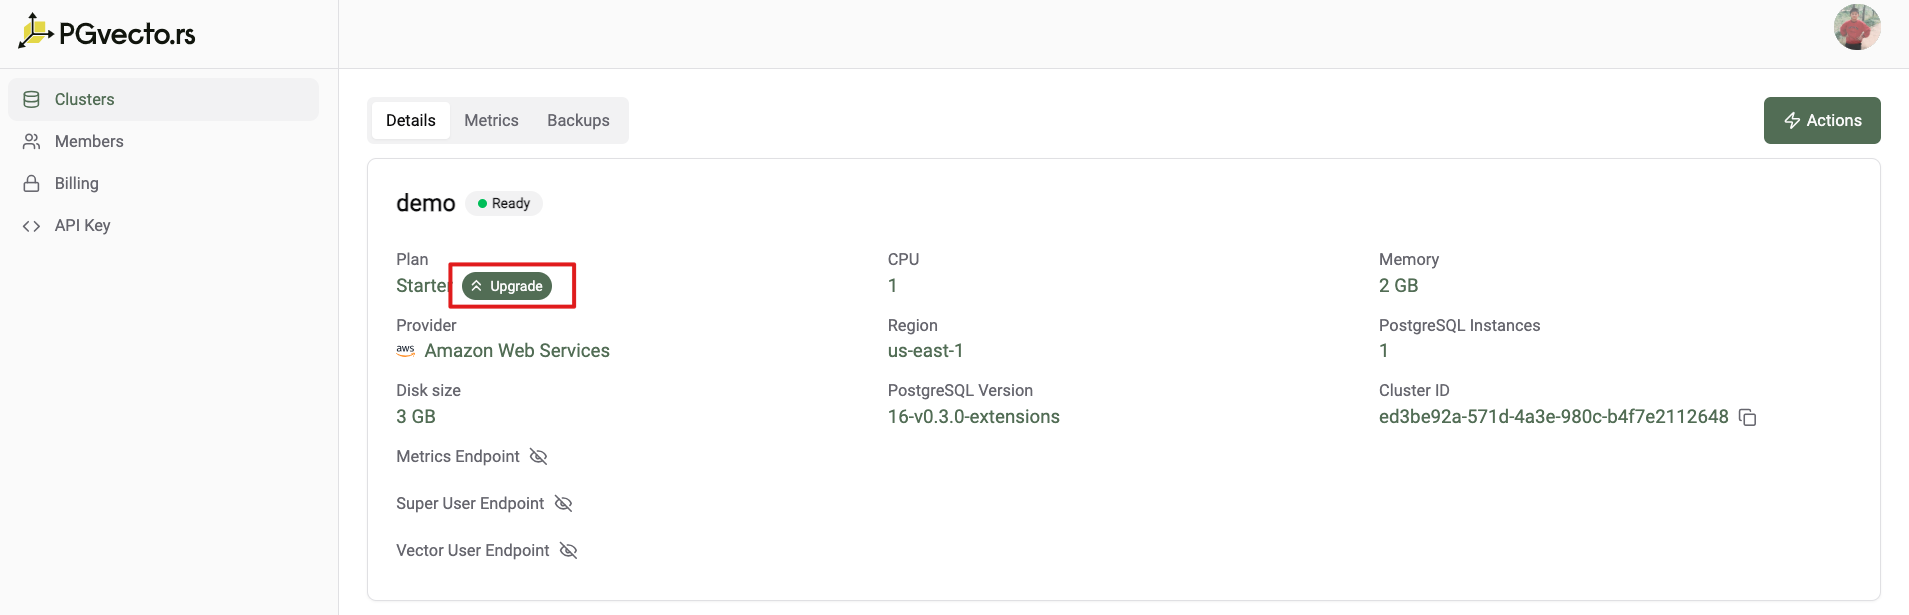
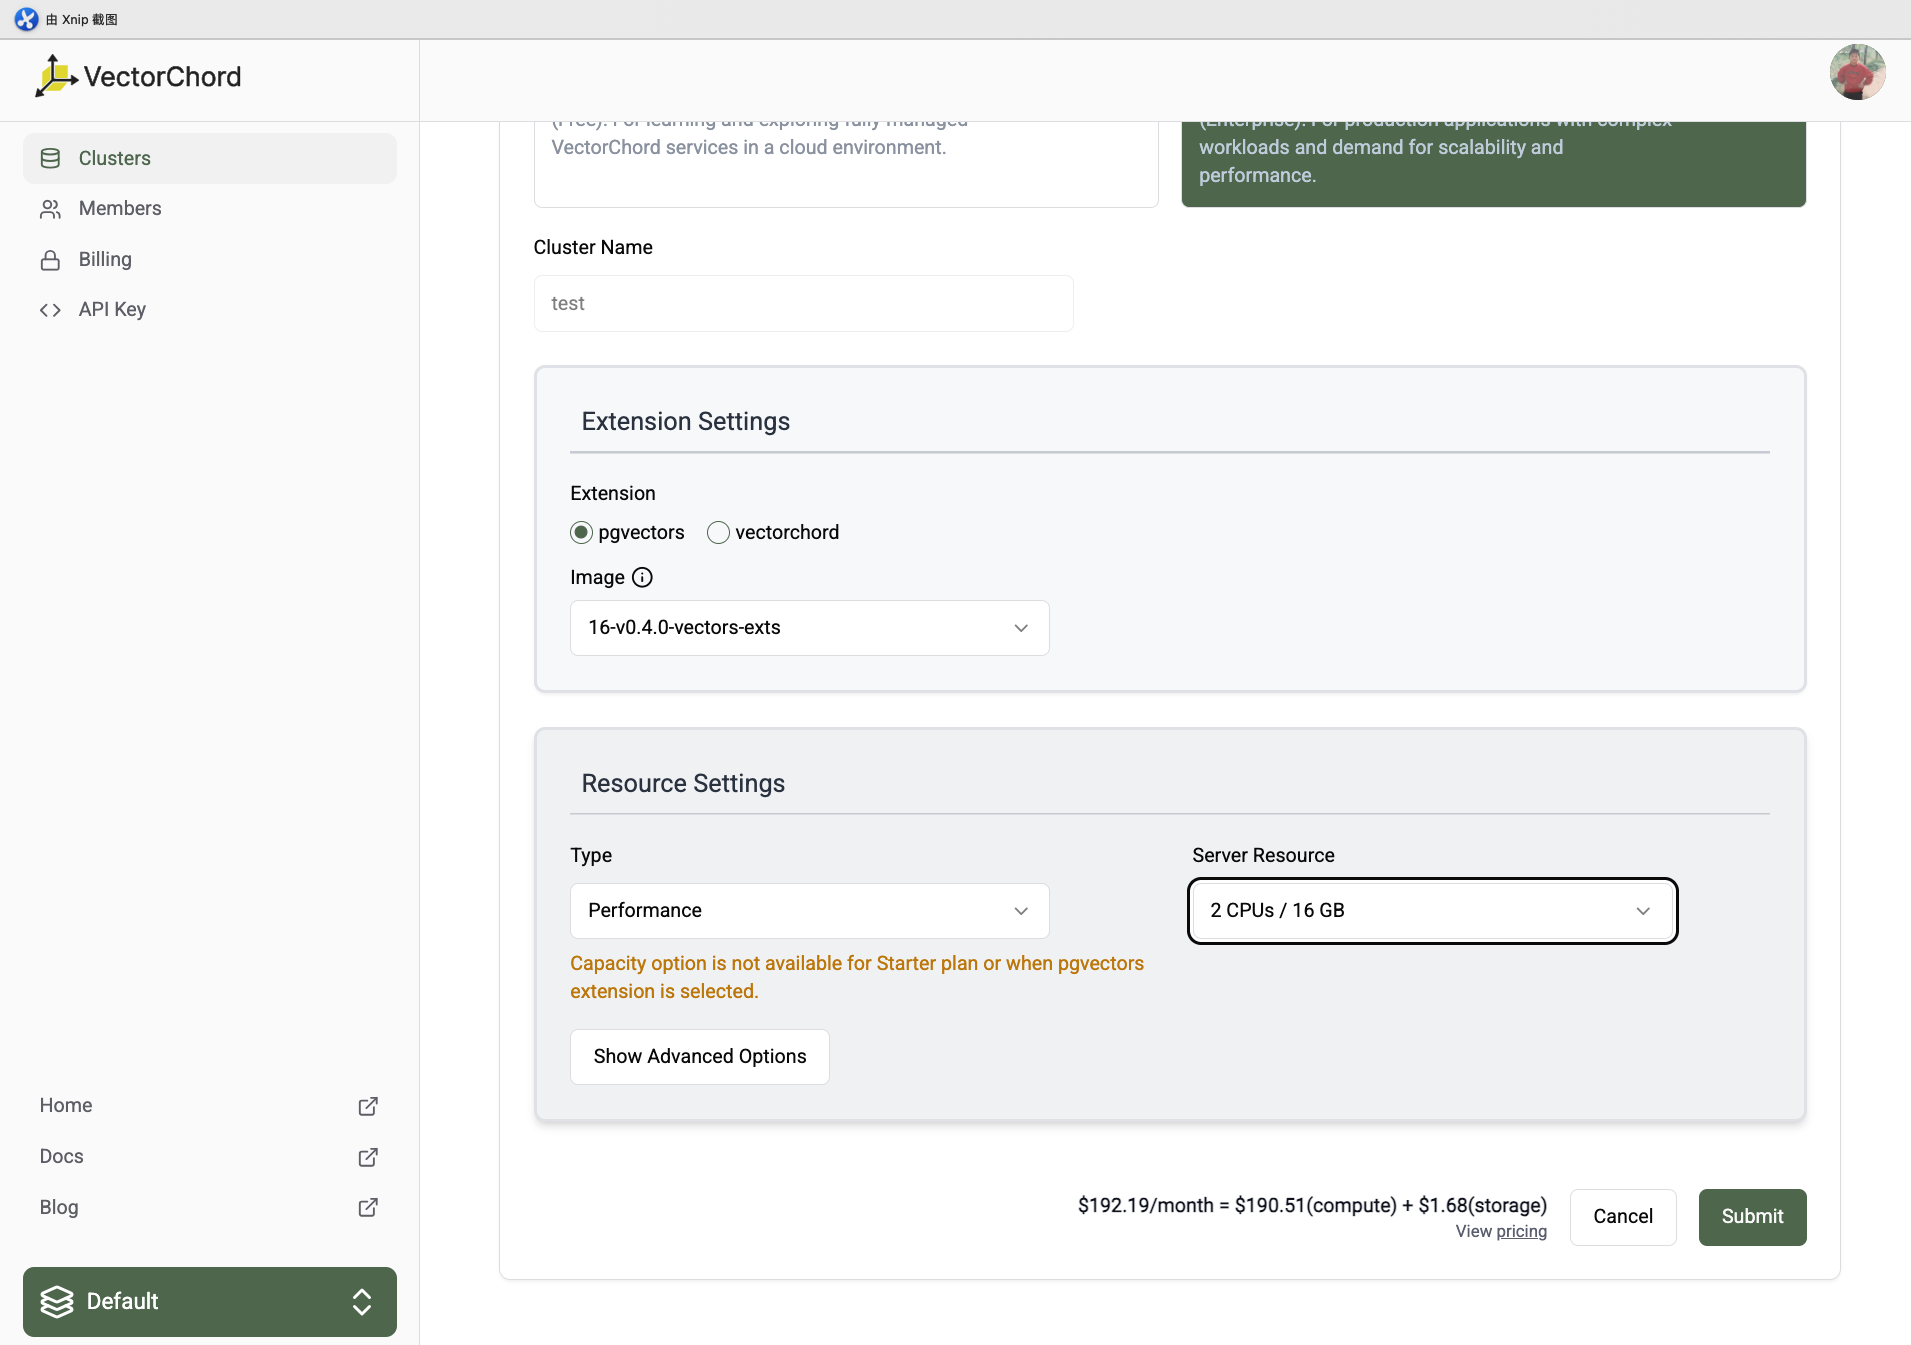
在升级页面中,您可以选择新的套餐和服务器资源规格。价格将根据新的服务器资源规格进行计算。点击 Submit 按钮提交集群升级。
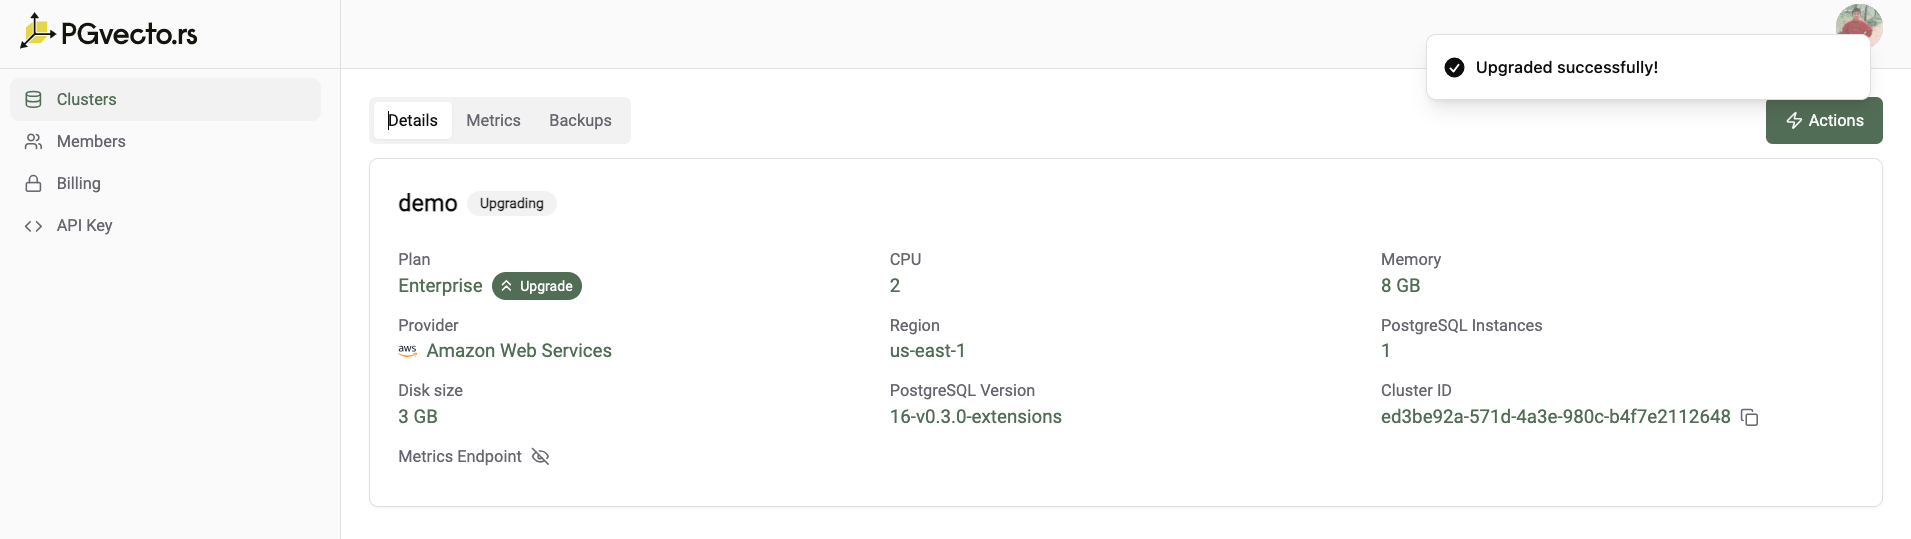
提交升级请求后,集群将进入 Upgrading 状态。在升级过程中集群将暂时不可用,升级过程可能需要几分钟才能完成。升级完成后,集群将恢复为 Ready 状态,CPU 和内存将更新为新的服务器资源规格,而存储空间保持不变。
仅扩容存储空间

如果您只想增加存储空间,集群状态必须处于 Ready。在集群详情页面点击 Upgrade 按钮。

在升级页面中,您可以在高级选项(Advanced Options)中输入新的磁盘大小。价格将根据新的存储空间大小进行计算。点击 Submit 按钮提交集群升级。
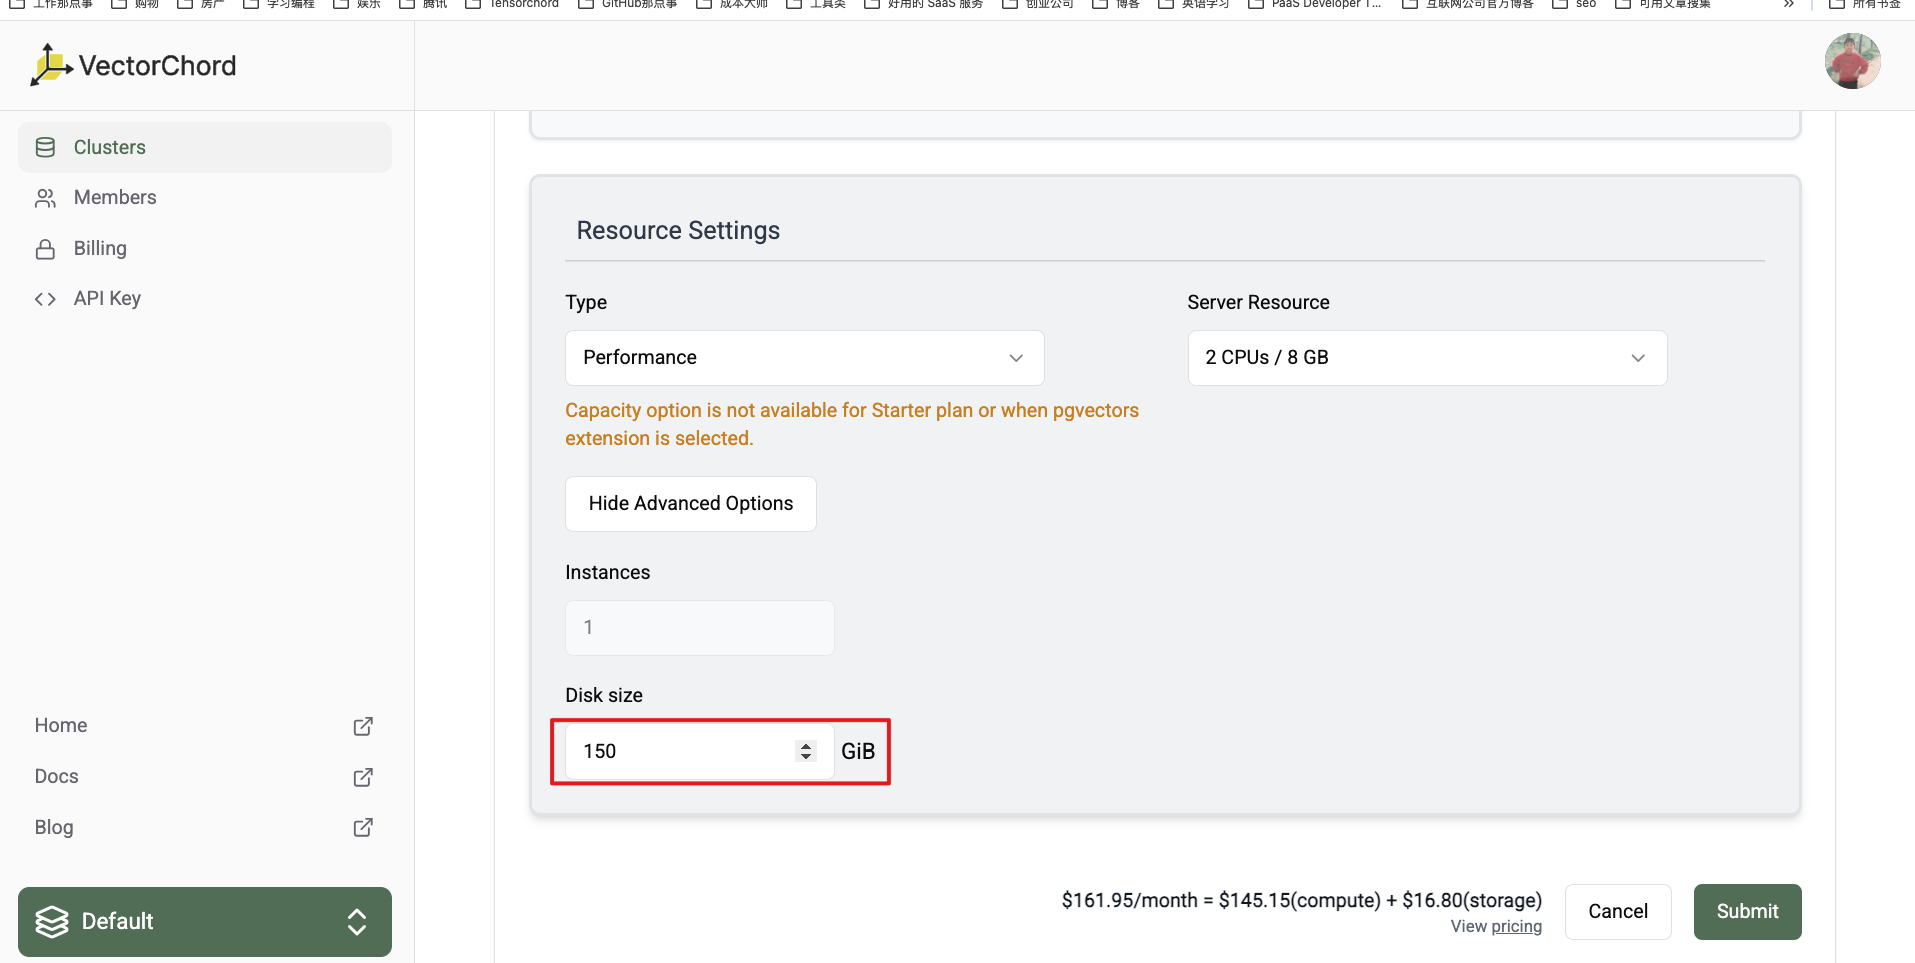
几分钟后,集群状态将从 Upgrading 变为 Ready。存储空间将更新为新的容量大小,而 CPU 和内存保持不变。
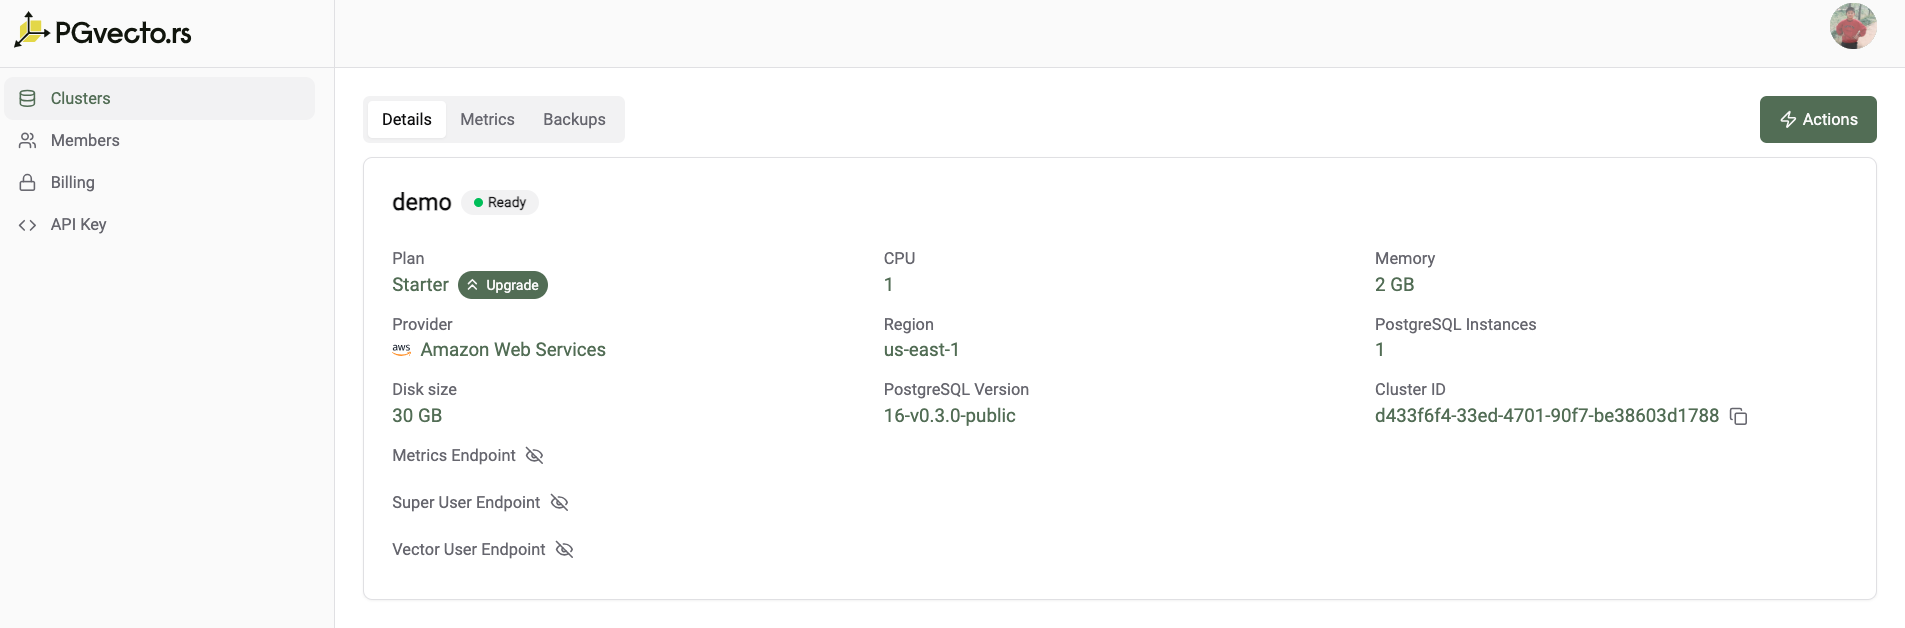
如果您希望同时升级服务器资源规格和存储空间,可以直接在升级页面中同时选择新的服务器资源规格并填写磁盘大小,价格将根据新的服务器资源规格和存储容量进行计算。目前我们不支持降配服务器资源规格或缩减存储空间。如果您需要降配服务器资源规格或存储大小,请联系我们获取协助。

4.7 - API 密钥

在 VectorChord Cloud 中,每个项目都提供一组 API 密钥。这些密钥是发起 Terraform 操作所必需的身份认证令牌。

在 VectorChord Cloud 中,每个项目都提供一组 API 密钥(API Key)。这些密钥是发起 Terraform 操作所必需的身份认证令牌。

基于角色的访问控制(RBAC)

基于角色的访问控制(RBAC)是 VectorChord Cloud 中一项至关重要的安全机制,适用于管理 API 调用。该系统通过为项目内的用户分配具有特定权限的角色,实现对资源的细粒度访问控制。

有关各个角色访问权限级别的更多信息,请参阅权限与授权。

创建 API 密钥

要创建 API 密钥,请按以下步骤操作:

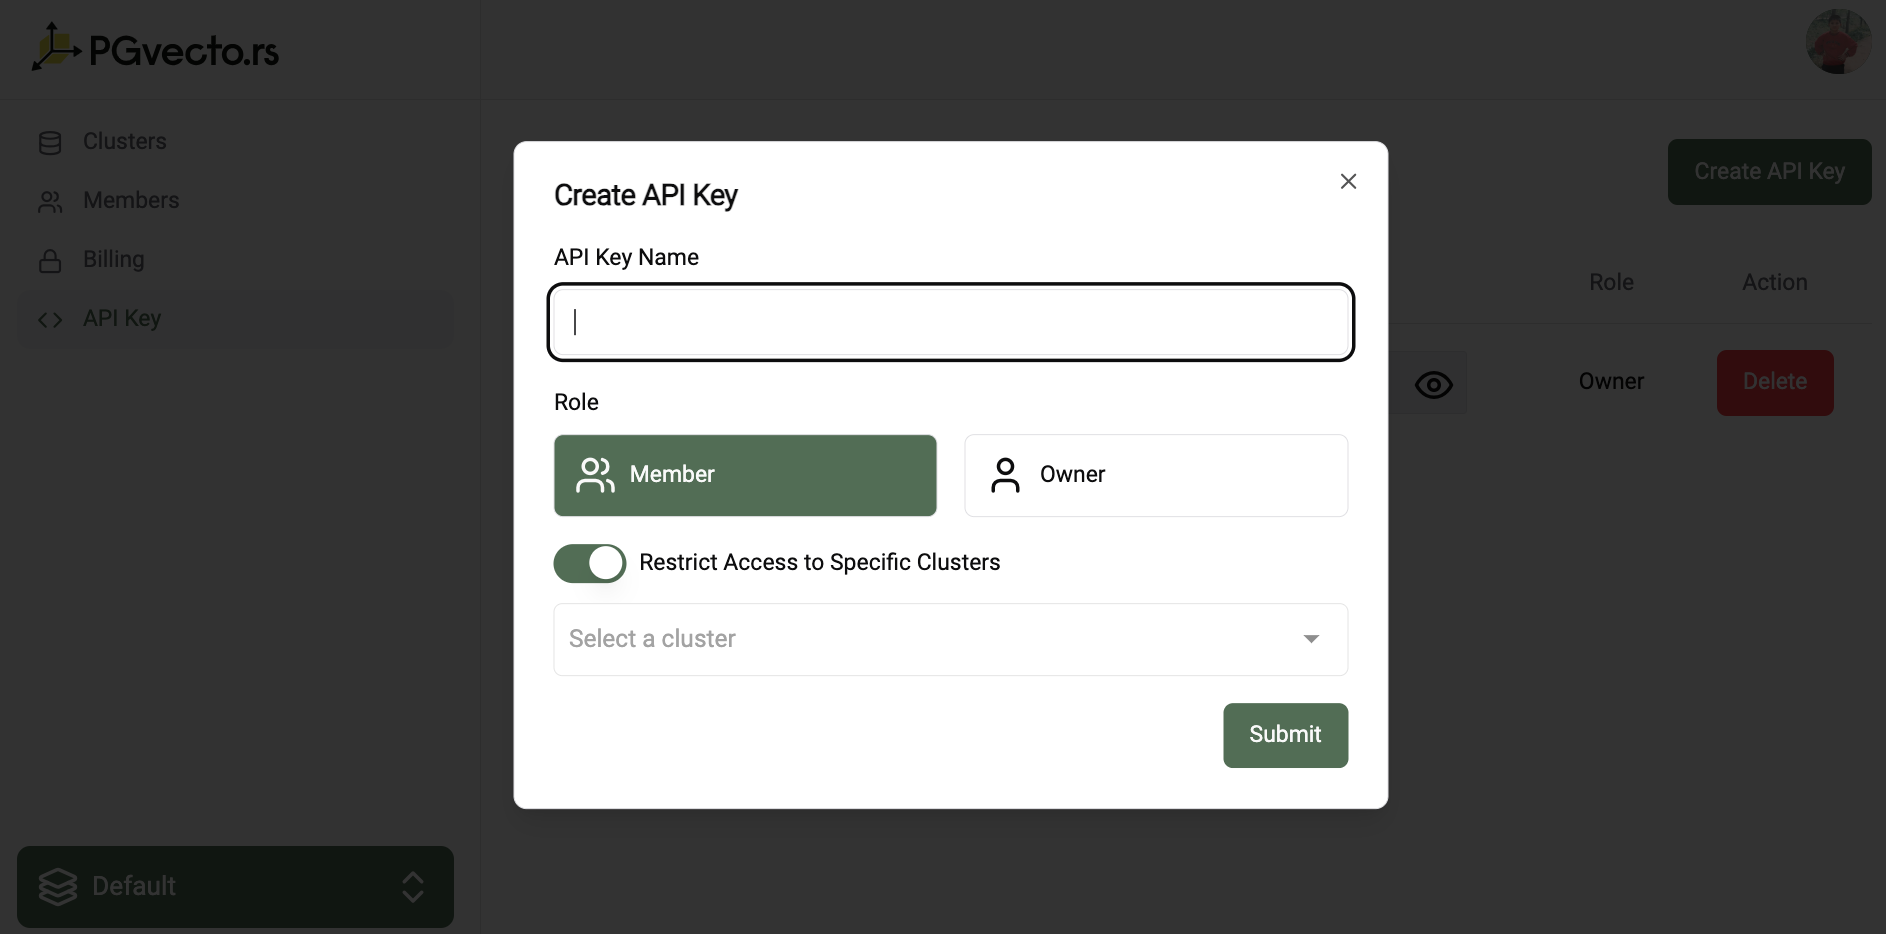
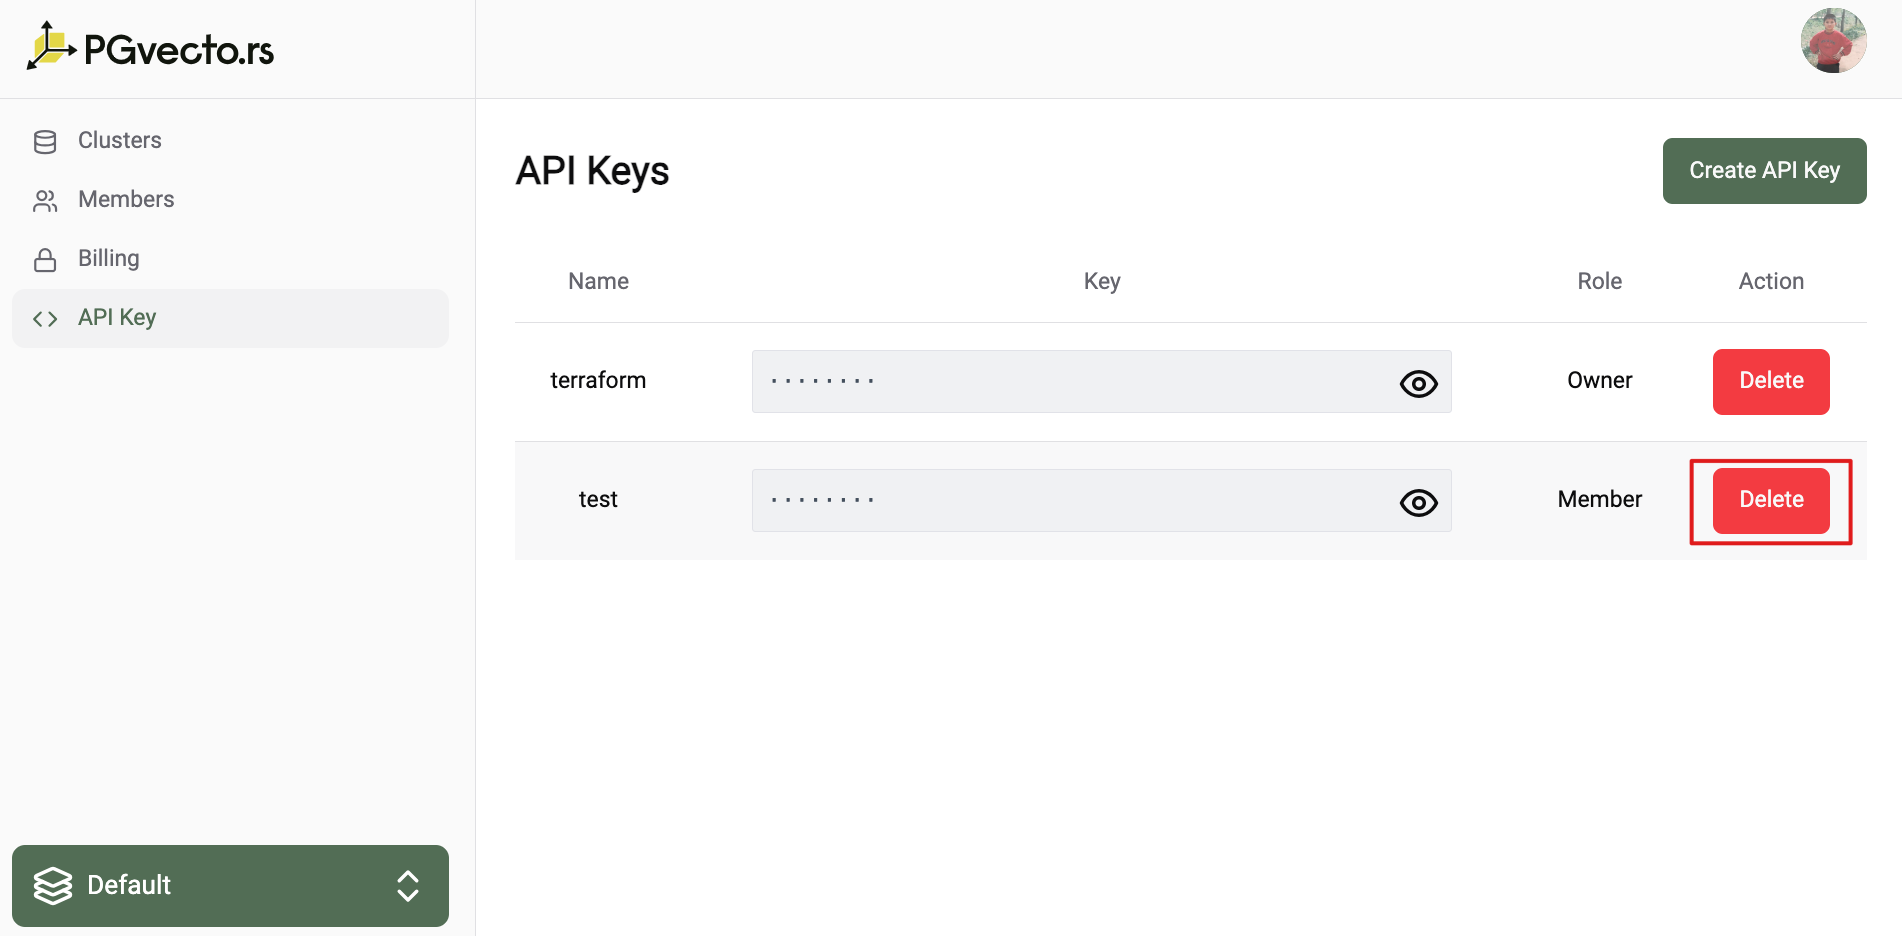
  • 在左侧菜单中进入 API Key 页面。
  • 点击 Create API Key 按钮。
  • 输入 API 密钥的名称。
  • 为 API 密钥选择角色:
    • Owner(所有者):对项目集群拥有完全访问权限。
    • Member(成员):对项目集群拥有只读访问权限;但您可以指定该成员拥有完全访问权限的特定集群。
  • 点击 Create 按钮。

删除 API 密钥

要删除 API 密钥,请按以下步骤操作:

  • 在左侧菜单中进入 API Key 页面。
  • 点击您想要删除的 API 密钥旁边的 Delete 按钮。
警告

请注意,API 密钥一旦删除便无法恢复。

查看 API 密钥列表

要查看 API 密钥列表,请按以下步骤操作:

  • 在左侧菜单中进入 API Key 页面。
  • 您可以查看所有 API 密钥及其对应的角色。
警告

如果您不是项目所有者(Owner),您将无权查看 API 密钥列表。

4.8 - VectorChord Cloud 的 Terraform 集成概览

本指南将带您逐步完成 PGVecto.rs Cloud Provider 的安装与配置。

本指南将带您逐步完成 PGVecto.rs Cloud Provider 的安装与配置。

1. 前置准备

在开始之前,请确保您已准备好以下内容:

  1. 已安装 Terraform:请访问此处并按照说明下载和安装 Terraform。

  2. VectorChord Cloud 账户:您需要拥有 VectorChord Cloud 的访问权限以及 API 密钥。请前往 VectorChord Cloud 控制台并创建 API 密钥。该 API 密钥必须具有 ProjectOwner 权限。有关更多信息,请参阅 API 密钥。

2. 下载 VectorChord Cloud Terraform Provider

首先,在您的 Terraform 配置文件(main.tf)中配置 VectorChord Cloud Provider:

terraform {
  required_providers {
    pgvecto-rs-cloud = {
      source = "tensorchord/pgvecto-rs-cloud"
    }
  }
}

3. 初始化 Terraform 配置

运行以下命令初始化 Terraform 配置:

$ terraform init

Initializing the backend...

Initializing provider plugins...
- Reusing previous version of tensorchord/pgvecto-rs-cloud from the dependency lock file
- Using previously-installed tensorchord/pgvecto-rs-cloud v0.0.2

Terraform has been successfully initialized!

You may now begin working with Terraform. Try running "terraform plan" to see
any changes that are required for your infrastructure. All Terraform commands
should now work.

If you ever set or change modules or backend configuration for Terraform,
rerun this command to reinitialize your working directory. If you forget, other
commands will detect it and remind you to do so if necessary.

Terraform 将下载 pgvecto-rs-cloud Provider,并将其安装在当前工作目录下名为 .terraform 的隐藏子目录中。

4. 认证 VectorChord Cloud Terraform Provider

使用该 Terraform Provider 需要提供您的 VectorChord Cloud API 密钥。您可以通过以下两种方式进行配置。

方式 1:在 Provider 块中指定 API 密钥

将以下代码追加到您的 main.tf 文件中:

provider "pgvecto-rs-cloud" {
  api_key = "<your-api-key>"
}

将 <your-api-key> 替换为您的 VectorChord Cloud API 密钥。

方式 2:使用环境变量

将 API 密钥设置为环境变量:

export PGVECTORS_CLOUD_API_KEY="<your-api-key>"

此时,您的 main.tf 文件中的 Provider 声明只需写为:

provider "pgvecto-rs-cloud" {
}

完成上述步骤后,VectorChord Cloud Terraform Provider 即已配置完毕,可以继续执行后续操作。

4. 管理 VectorChord Cloud 集群

创建企业版套餐集群

以下示例展示了如何创建企业版(Enterprise)套餐的 PostgreSQL 集群。有关配置选项的更多信息,请参阅 Resource Schema。

resource "pgvecto-rs-cloud_cluster" "enterprise_plan_cluster" {
  account_id        = "8364ded2-5580-45c4-a394-edfa582e35a0"
  cluster_name      = "enterprise-plan-cluster"
  plan              = "Enterprise"
  image             = "15-v0.3.0-public"
  server_resource   = "aws-m7i-large-2c-8g"
  region            = "eu-west-1"
  cluster_provider  = "aws"
  database_name     = "test"
  pg_data_disk_size = "10"
}

output "psql_endpoint_enterprise" {
  description = "Endpoint for the VectorChord Cloud Enterprise PostgreSQL database"
  value       = pgvecto-rs-cloud_cluster.enterprise_plan_cluster.connect_endpoint
}
$ terraform validate && terraform plan  && terraform output  
Success! The configuration is valid.


Terraform used the selected providers to generate the following execution plan. Resource actions are
indicated with the following symbols:
  + create

Terraform will perform the following actions:

  # pgvecto-rs-cloud_cluster.enterprise_plan_cluster will be created
  + resource "pgvecto-rs-cloud_cluster" "enterprise_plan_cluster" {
      + account_id                 = "8364ded2-5580-45c4-a394-edfa582e35a0"
      + cluster_name               = "enterprise-plan-cluster"
      + cluster_provider           = "aws"
      + connect_endpoint           = (known after apply)
      + database_name              = "test"
      + first_recoverability_point = (known after apply)
      + id                         = (known after apply)
      + image                      = "15-v0.3.0-public"
      + last_archived_wal_time     = (known after apply)
      + last_updated               = (known after apply)
      + pg_data_disk_size          = "10"
      + plan                       = "Enterprise"
      + region                     = "eu-west-1"
      + server_resource            = "aws-m7i-large-2c-8g"
      + status                     = (known after apply)
    }

Plan: 1 to add, 0 to change, 0 to destroy.

Changes to Outputs:
  + psql_endpoint_enterprise = (known after apply)

─────────────────────────────────────────────────────────────────────────────────────────────────────────

Note: You didn't use the -out option to save this plan, so Terraform can't guarantee to take exactly
these actions if you run "terraform apply" now.
╷
│ Warning: No outputs found
│ 
│ The state file either has no outputs defined, or all the defined outputs are empty. Please define an
│ output in your configuration with the `output` keyword and run `terraform refresh` for it to become
│ available. If you are using interpolation, please verify the interpolated value is not empty. You can
│ use the `terraform console` command to assist.
$ terraform apply   

Terraform used the selected providers to generate the following execution plan. Resource actions are
indicated with the following symbols:
  + create

Terraform will perform the following actions:

  # pgvecto-rs-cloud_cluster.enterprise_plan_cluster will be created
  + resource "pgvecto-rs-cloud_cluster" "enterprise_plan_cluster" {
      + account_id                 = "8364ded2-5580-45c4-a394-edfa582e35a0"
      + cluster_name               = "enterprise-plan-cluster"
      + cluster_provider           = "aws"
      + connect_endpoint           = (known after apply)
      + database_name              = "test"
      + first_recoverability_point = (known after apply)
      + id                         = (known after apply)
      + image                      = "15-v0.3.0-public"
      + last_archived_wal_time     = (known after apply)
      + last_updated               = (known after apply)
      + pg_data_disk_size          = "10"
      + plan                       = "Enterprise"
      + region                     = "eu-west-1"
      + server_resource            = "aws-m7i-large-2c-8g"
      + status                     = (known after apply)
    }

Plan: 1 to add, 0 to change, 0 to destroy.

Changes to Outputs:
  + psql_endpoint_enterprise = (known after apply)

Do you want to perform these actions?
  Terraform will perform the actions described above.
  Only 'yes' will be accepted to approve.

  Enter a value: yes

pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Creating...
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still creating... [10s elapsed]
...[snip]...
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still creating... [2m0s elapsed]
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Creation complete after 2m9s [id=9986cfff-9758-4cbc-9433-084fe6e7936f]

Apply complete! Resources: 1 added, 0 changed, 0 destroyed.

Outputs:

psql_endpoint_enterprise = "postgres://test_user:plvpx1YvXmBu@enterprise-plan-cluster-hp2goemtvtd5q0ew.eu-west-1-dev.aws.vectorchord.com:5432/test?sslmode=require"

连接到集群

$ psql "postgres://test_user:plvpx1YvXmBu@enterprise-plan-cluster-hp2goemtvtd5q0ew.eu-west-1-dev.aws.vectorchord.com:5432/test?sslmode=require"
psql (15.3, server 15.8 (Debian 15.8-1.pgdg120+1))
SSL connection (protocol: TLSv1.3, cipher: TLS_AES_256_GCM_SHA384, compression: off)
Type "help" for help.

test=> \dx
                                                 List of installed extensions
  Name   | Version |   Schema   |                                         Description
---------+---------+------------+----------------------------------------------------------------------------------------------
 pgaudit | 1.7     | public     | provides auditing functionality
 plpgsql | 1.0     | pg_catalog | PL/pgSQL procedural language
 vectors | 0.3.0   | public     | vectors: Vector database plugin for Postgres, written in Rust, specifically designed for LLM
(3 rows)

test=> CREATE TABLE test (id integer PRIMARY KEY, embedding vector(3) NOT NULL);
CREATE TABLE
test=> INSERT INTO test SELECT i, ARRAY[random(), random(), random()]::real[] FROM generate_series(1, 100) i;
INSERT 0 100
test=> CREATE INDEX ON test USING vectors (embedding vector_l2_ops) WITH (options = "[indexing.hnsw]");
CREATE INDEX
test=> SELECT * FROM test ORDER BY embedding <-> '[0.40671515, 0.24202824, 0.37059402]' LIMIT 10;
 id |               embedding
----+---------------------------------------
 10 | [0.3603687, 0.2597973, 0.48529512]
 68 | [0.341106, 0.36290976, 0.4206507]
 46 | [0.29137495, 0.10839028, 0.2966823]
 56 | [0.5840259, 0.3336522, 0.33045283]
 54 | [0.2123173, 0.21955383, 0.2764878]
 97 | [0.37704793, 0.45084634, 0.3079026]
 64 | [0.33564404, 0.46575224, 0.33372045]
  8 | [0.5397384, 0.41881782, 0.26093292]
 66 | [0.42560518, 0.0136409905, 0.2709207]
 26 | [0.37973955, 0.24594037, 0.61934566]
(10 rows)

升级集群

目前,我们仅支持升级服务器资源规格、套餐类型和磁盘大小。升级操作存在一些限制:新服务器资源规格的 CPU 和内存必须大于或等于原有规格,新磁盘大小必须大于或等于原有大小,且套餐升级必须是从 Starter 升级到 Enterprise。

+ server_resource   = "aws-r7i-large-2c-16g"
- server_resource   = "aws-m7i-large-2c-8g"
+ pg_data_disk_size = "20"
- pg_data_disk_size = "10" 
$ terraform apply   
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Refreshing state... [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b]

Terraform used the selected providers to generate the following execution plan. Resource actions are
indicated with the following symbols:
  ~ update in-place

Terraform will perform the following actions:

  # pgvecto-rs-cloud_cluster.enterprise_plan_cluster will be updated in-place
  ~ resource "pgvecto-rs-cloud_cluster" "enterprise_plan_cluster" {
      ~ connect_endpoint           = "postgres://test_user:q7SdfHYVqkGB@enterprise-plan-cluster-tiqmlrllv36fmh4h.eu-west-1-dev.aws.vectorchord.com:5432/test?sslmode=require" -> (known after apply)
      ~ first_recoverability_point = "2024-09-20T03:53:04Z" -> (known after apply)
        id                         = "bbfb4ed2-b434-4e20-994f-6627e8f3785b"
      ~ last_archived_wal_time     = "2024-09-20T03:53:07Z" -> (known after apply)
      ~ last_updated               = "2024-09-20T03:52:38Z" -> (known after apply)
      ~ pg_data_disk_size          = "10" -> "20"
      ~ server_resource            = "aws-m7i-large-2c-8g" -> "aws-r7i-large-2c-16g"
      ~ status                     = "Ready" -> (known after apply)
        # (7 unchanged attributes hidden)
    }

Plan: 0 to add, 1 to change, 0 to destroy.

Changes to Outputs:
  ~ psql_endpoint_enterprise = "postgres://test_user:q7SdfHYVqkGB@enterprise-plan-cluster-tiqmlrllv36fmh4h.eu-west-1-dev.aws.vectorchord.com:5432/test?sslmode=require" -> (known after apply)

Do you want to perform these actions?
  Terraform will perform the actions described above.
  Only 'yes' will be accepted to approve.

  Enter a value: yes

pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Modifying... [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b]
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still modifying... [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b, 10s elapsed]
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still modifying... [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b, 20s elapsed]
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still modifying... [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b, 30s elapsed]
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still modifying... [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b, 40s elapsed]
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still modifying... [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b, 50s elapsed]
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Modifications complete after 53s [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b]

Apply complete! Resources: 0 added, 1 changed, 0 destroyed.

Outputs:

psql_endpoint_enterprise = "postgres://test_user:q7SdfHYVqkGB@enterprise-plan-cluster-tiqmlrllv36fmh4h.eu-west-1-dev.aws.vectorchord.com:5432/test?sslmode=require"

销毁集群

$ terraform destroy
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Refreshing state... [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b]

Terraform used the selected providers to generate the following execution plan. Resource actions are
indicated with the following symbols:
  - destroy

Terraform will perform the following actions:

  # pgvecto-rs-cloud_cluster.enterprise_plan_cluster will be destroyed
  - resource "pgvecto-rs-cloud_cluster" "enterprise_plan_cluster" {
      - account_id                 = "8364ded2-5580-45c4-a394-edfa582e35a0" -> null
      - cluster_name               = "enterprise-plan-cluster" -> null
      - cluster_provider           = "aws" -> null
      - connect_endpoint           = "postgres://test_user:q7SdfHYVqkGB@enterprise-plan-cluster-tiqmlrllv36fmh4h.eu-west-1-dev.aws.vectorchord.com:5432/test?sslmode=require" -> null
      - database_name              = "test" -> null
      - first_recoverability_point = "2024-09-20T03:53:04Z" -> null
      - id                         = "bbfb4ed2-b434-4e20-994f-6627e8f3785b" -> null
      - image                      = "15-v0.3.0-public" -> null
      - last_archived_wal_time     = "2024-09-20T03:53:07Z" -> null
      - last_updated               = "2024-09-20T03:55:04Z" -> null
      - pg_data_disk_size          = "20" -> null
      - plan                       = "Enterprise" -> null
      - region                     = "eu-west-1" -> null
      - server_resource            = "aws-r7i-large-2c-16g" -> null
      - status                     = "Ready" -> null
    }

Plan: 0 to add, 0 to change, 1 to destroy.

Changes to Outputs:
  - psql_endpoint_enterprise = "postgres://test_user:q7SdfHYVqkGB@enterprise-plan-cluster-tiqmlrllv36fmh4h.eu-west-1-dev.aws.vectorchord.com:5432/test?sslmode=require" -> null

Do you really want to destroy all resources?
  Terraform will destroy all your managed infrastructure, as shown above.
  There is no undo. Only 'yes' will be accepted to confirm.

  Enter a value: yes

pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Destroying... [id=bbfb4ed2-b434-4e20-994f-6627e8f3785b]
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Destruction complete after 1s

Destroy complete! Resources: 1 destroyed.

5. 恢复

在本节中,我们将演示如何从现有备份或按时间点恢复(PITR)来恢复您的 PostgreSQL 数据库。

从备份恢复

警告

您要恢复到的目标集群必须与备份具有相同的镜像(Image)、数据库名称(Database Name)和区域(Region)。

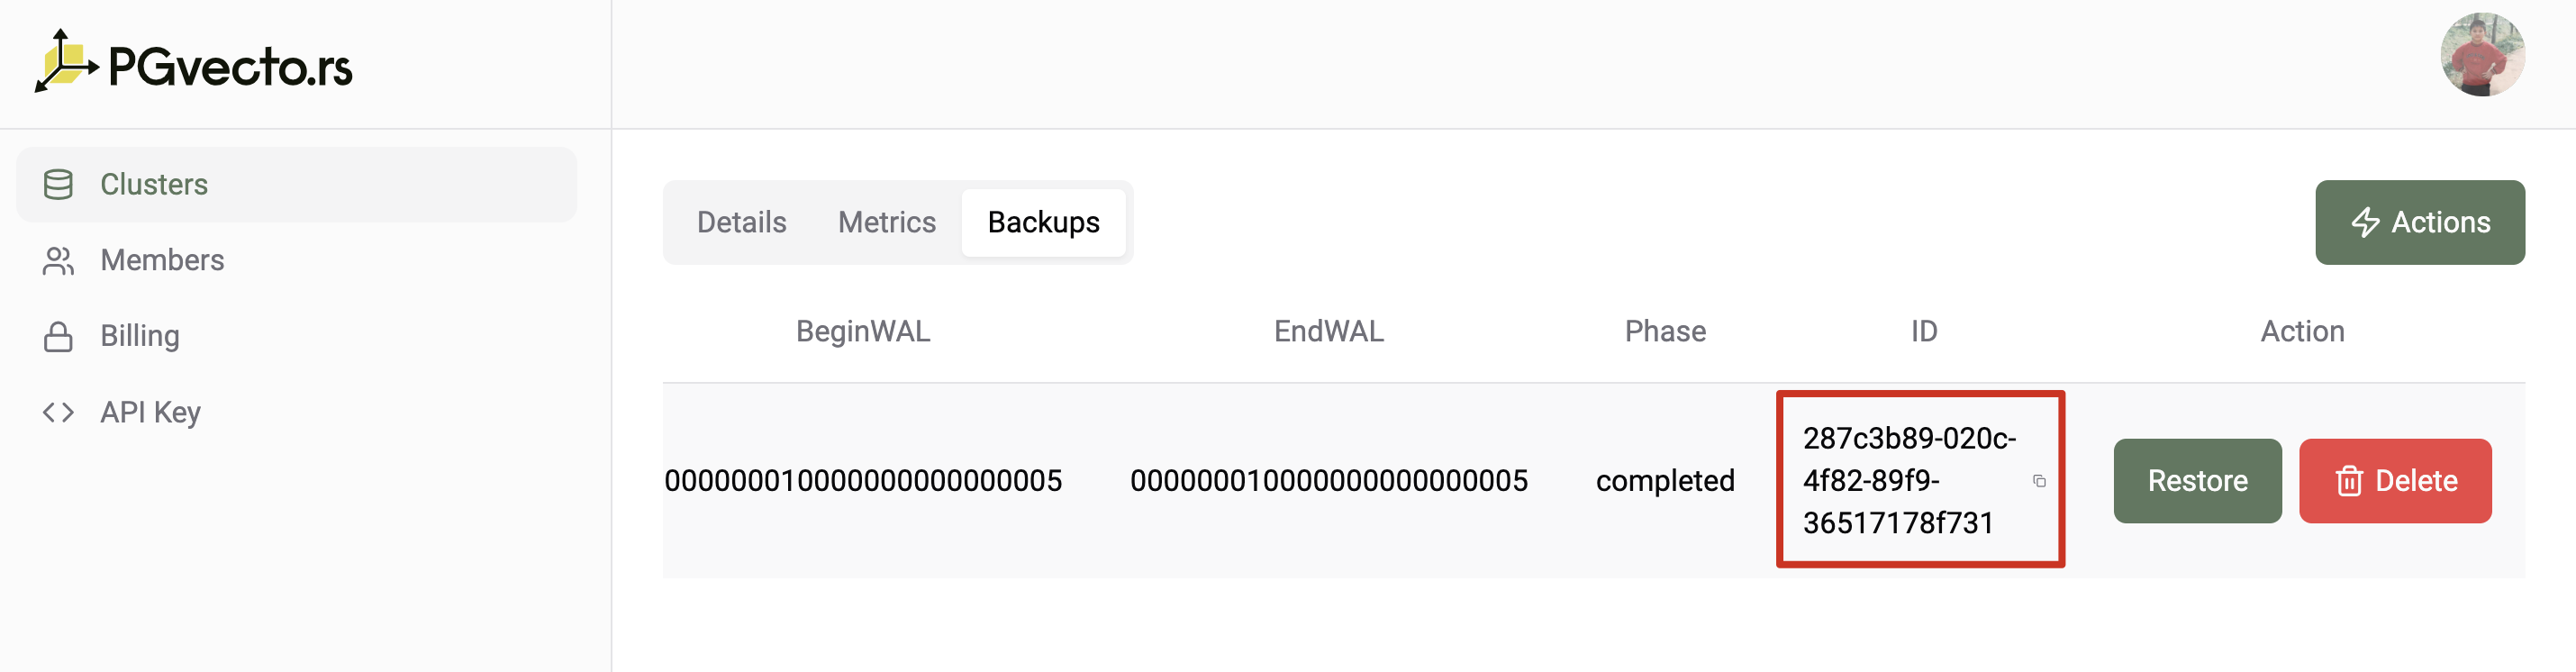
  1. 从控制台获取备份 ID(Backup ID)

  2. 使用该备份 ID 创建新集群

terraform {
  required_providers {
    pgvecto-rs-cloud = {
      source = "tensorchord/pgvecto-rs-cloud"
    }
  }
}

provider "pgvecto-rs-cloud" {
  api_key = "pgrs-57cc0d484e7e1d00444201ee846455b5"
  api_url = "https://cloud-dev.vectorchord.ai/api/v1"
}

resource "pgvecto-rs-cloud_cluster" "enterprise_plan_cluster" {
  account_id        = "8364ded2-5580-45c4-a394-edfa582e35a0"
  cluster_name      = "enterprise-plan-cluster"
  plan              = "Enterprise"
  image             = "15-v0.3.0-public"
  server_resource   = "aws-r7i-large-2c-16g"
  region            = "eu-west-1"
  cluster_provider  = "aws"
  database_name     = "test"
  pg_data_disk_size = "20"
  enable_restore    = "true"
  backup_id         = "4f53b451-8e19-443c-bcd7-43420d105696"
}

output "psql_endpoint_enterprise" {
  description = "Endpoint for the VectorChord Cloud Enterprise PostgreSQL database"
  value       = pgvecto-rs-cloud_cluster.enterprise_plan_cluster.connect_endpoint
}
$ terraform apply   

Terraform used the selected providers to generate the following execution plan. Resource actions are
indicated with the following symbols:
  + create

Terraform will perform the following actions:

  # pgvecto-rs-cloud_cluster.enterprise_plan_cluster will be created
  + resource "pgvecto-rs-cloud_cluster" "enterprise_plan_cluster" {
      + account_id                 = "8364ded2-5580-45c4-a394-edfa582e35a0"
      + backup_id                  = "4f53b451-8e19-443c-bcd7-43420d105696"
      + cluster_name               = "enterprise-plan-cluster"
      + cluster_provider           = "aws"
      + connect_endpoint           = (known after apply)
      + database_name              = "test"
      + enable_restore             = true
      + first_recoverability_point = (known after apply)
      + id                         = (known after apply)
      + image                      = "15-v0.3.0-public"
      + last_archived_wal_time     = (known after apply)
      + last_updated               = (known after apply)
      + pg_data_disk_size          = "20"
      + plan                       = "Enterprise"
      + region                     = "us-east-1"
      + server_resource            = "aws-r7i-large-2c-16g"
      + status                     = (known after apply)
    }

Plan: 1 to add, 0 to change, 0 to destroy.

Changes to Outputs:
  + psql_endpoint_enterprise = (known after apply)

Do you want to perform these actions?
  Terraform will perform the actions described above.
  Only 'yes' will be accepted to approve.

  Enter a value: yes

pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Creating...
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still creating... [10s elapsed]
...[snip]...
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still creating... [2m10s elapsed]
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Creation complete after 2m19s [id=8ba9e5b4-f06c-4ef0-8e10-b6663237a532]

Apply complete! Resources: 1 added, 0 changed, 0 destroyed.

Outputs:

psql_endpoint_enterprise = "postgres://test_user:j4Xu6TIstD1F@enterprise-plan-cluster-kxy2lovbc4crarmn.modelz.tech:5432/test?sslmode=require"
# 您可以检查表和索引
$ psql "postgres://test_user:j4Xu6TIstD1F@enterprise-plan-cluster-kxy2lovbc4crarmn.modelz.tech:5432/test?sslmode=require"
psql (15.3, server 15.8 (Debian 15.8-1.pgdg120+1))
SSL connection (protocol: TLSv1.3, cipher: TLS_AES_256_GCM_SHA384, compression: off)
Type "help" for help.

test=> \dt
         List of relations
 Schema | Name | Type  |   Owner
--------+------+-------+-----------
 public | test | table | test_user
(1 row)

test=> SELECT * FROM test ORDER BY embedding <-> '[0.40671515, 0.24202824, 0.37059402]' LIMIT 10;
 id |              embedding
----+--------------------------------------
 34 | [0.4047166, 0.2152912, 0.30516902]
 56 | [0.39068437, 0.3153389, 0.40011033]
 42 | [0.43917453, 0.22915891, 0.44726416]
 45 | [0.47589824, 0.33998397, 0.39237767]
 43 | [0.46702152, 0.09506769, 0.4343289]
 95 | [0.4987348, 0.08346876, 0.28716254]
 60 | [0.5421089, 0.3585022, 0.25259662]
 80 | [0.61970145, 0.2186208, 0.36950335]
 53 | [0.3399207, 0.3417044, 0.55435336]
 54 | [0.3198571, 0.445044, 0.36041933]
(10 rows)

PITR

警告

您要恢复到的目标集群必须与原集群具有相同的镜像(Image)和数据库名称(Database Name)。

  1. 从控制台获取集群 ID(Cluster ID)

  2. 使用该集群 ID 和目标时间创建新集群

terraform {
  required_providers {
    pgvecto-rs-cloud = {
      source = "tensorchord/pgvecto-rs-cloud"
    }
  }
}

provider "pgvecto-rs-cloud" {
  api_key = "pgrs-57cc0d484e7e1d00444201ee846455b5"
  api_url = "https://cloud-dev.vectorchord.ai/api/v1"
}

resource "pgvecto-rs-cloud_cluster" "enterprise_plan_cluster" {
  account_id        = "8364ded2-5580-45c4-a394-edfa582e35a0"
  cluster_name      = "enterprise-plan-cluster"
  plan              = "Enterprise"
  image             = "15-v0.3.0-public"
  server_resource   = "aws-r7i-large-2c-16g"
  region            = "eu-west-1"
  cluster_provider  = "aws"
  database_name     = "test"
  pg_data_disk_size = "20"
  enable_restore    = "true"
  target_cluster_id = "43f17a52-0d07-43d5-91b6-9fbe4641578c"
  target_time       = "2024-09-20T12:00:00+08:00"
}

output "psql_endpoint_enterprise" {
  description = "Endpoint for the VectorChord Cloud Enterprise PostgreSQL database"
  value       = pgvecto-rs-cloud_cluster.enterprise_plan_cluster.connect_endpoint
}
$ terraform apply   

Terraform used the selected providers to generate the following execution plan. Resource actions are
indicated with the following symbols:
  + create

Terraform will perform the following actions:

  # pgvecto-rs-cloud_cluster.enterprise_plan_cluster will be created
  + resource "pgvecto-rs-cloud_cluster" "enterprise_plan_cluster" {
      + account_id                 = "8364ded2-5580-45c4-a394-edfa582e35a0"
      + cluster_name               = "enterprise-plan-cluster"
      + cluster_provider           = "aws"
      + connect_endpoint           = (known after apply)
      + database_name              = "test"
      + enable_restore             = true
      + first_recoverability_point = (known after apply)
      + id                         = (known after apply)
      + image                      = "15-v0.3.0-public"
      + last_archived_wal_time     = (known after apply)
      + last_updated               = (known after apply)
      + pg_data_disk_size          = "20"
      + plan                       = "Enterprise"
      + region                     = "eu-west-1"
      + server_resource            = "aws-r7i-large-2c-16g"
      + status                     = (known after apply)
      + target_cluster_id          = "43f17a52-0d07-43d5-91b6-9fbe4641578c"
      + target_time                = "2024-09-20T12:00:00+08:00"
    }

Plan: 1 to add, 0 to change, 0 to destroy.

Changes to Outputs:
  + psql_endpoint_enterprise = (known after apply)

Do you want to perform these actions?
  Terraform will perform the actions described above.
  Only 'yes' will be accepted to approve.

  Enter a value: yes

pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Creating...
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still creating... [10s elapsed]
...[snip]...
pgvecto-rs-cloud_cluster.enterprise_plan_cluster: Still creating... [5m20s elapsed]

# 您可以检查表和索引
$ psql 'postgres://test_user:RKC4wr7MRcwm@enterprise-plan-cluster-4paxqvbzwxudmvja.eu-west-1-dev.aws.vectorchord.com:5432/test?sslmode=require'
psql (15.3, server 15.8 (Debian 15.8-1.pgdg120+1))
SSL connection (protocol: TLSv1.3, cipher: TLS_AES_256_GCM_SHA384, compression: off)
Type "help" for help.

test=> \dt
         List of relations
 Schema | Name | Type  |   Owner   
--------+------+-------+-----------
 public | test | table | test_user
(1 row)

test=> SELECT * FROM test ORDER BY embedding <-> '[0.40671515, 0.24202824, 0.37059402]' LIMIT 10;
 id |              embedding               
----+--------------------------------------
 34 | [0.4047166, 0.2152912, 0.30516902]
 56 | [0.39068437, 0.3153389, 0.40011033]
 42 | [0.43917453, 0.22915891, 0.44726416]
 45 | [0.47589824, 0.33998397, 0.39237767]
 43 | [0.46702152, 0.09506769, 0.4343289]
 95 | [0.4987348, 0.08346876, 0.28716254]
 60 | [0.5421089, 0.3585022, 0.25259662]
 80 | [0.61970145, 0.2186208, 0.36950335]
 53 | [0.3399207, 0.3417044, 0.55435336]
 54 | [0.3198571, 0.445044, 0.36041933]
(10 rows)

4.9 - 可用区域

在 VectorChord Cloud 中,您可以将集群部署到不同的区域。创建集群时,使用下拉选择器挑选区域即可。

部署到指定区域

在 VectorChord Cloud 中,您可以将集群部署到不同的区域(Region)。创建集群时,使用下拉选择器选择目标区域即可。
提示

没有看到您需要的区域或云厂商?请通过 Discord 联系我们,我们很乐意为您提供帮助。

4.10 - 工作流

工作流(Workflow)是一项允许您使用预定义函数完成特定任务的功能,例如使用 ExternalBuildIndex 工作流在外部构建索引。

概览

工作流(Workflow)是一项允许您使用预定义函数完成特定任务的功能。例如,您可以使用 ExternalBuildIndex 工作流在集群外部为您的 Postgres 集群构建索引。使用工作流具有以下优势:

  • 开箱即用(Out Of Box):无需编写任何代码即可使用预定义函数完成特定任务。
  • 加速任务执行(Accelerate Tasks):可以使用比 PostgreSQL 集群更高资源配置的服务器来加速任务处理。
  • 保障集群稳定性(Cluster Stability):工作流在独立的服务器上执行,不会影响 PostgreSQL 集群自身的稳定性。
  • 低成本(Low Cost):对于短期任务,您无需像维护数据库那样持续为高配资源付费。

支持的工作流

目前支持的工作流如下:

ExternalBuildIndex

ExternalBuildIndex 工作流用于在集群外部为您的 Postgres 集群构建 vchord 索引,详细原理可参阅外部构建索引。
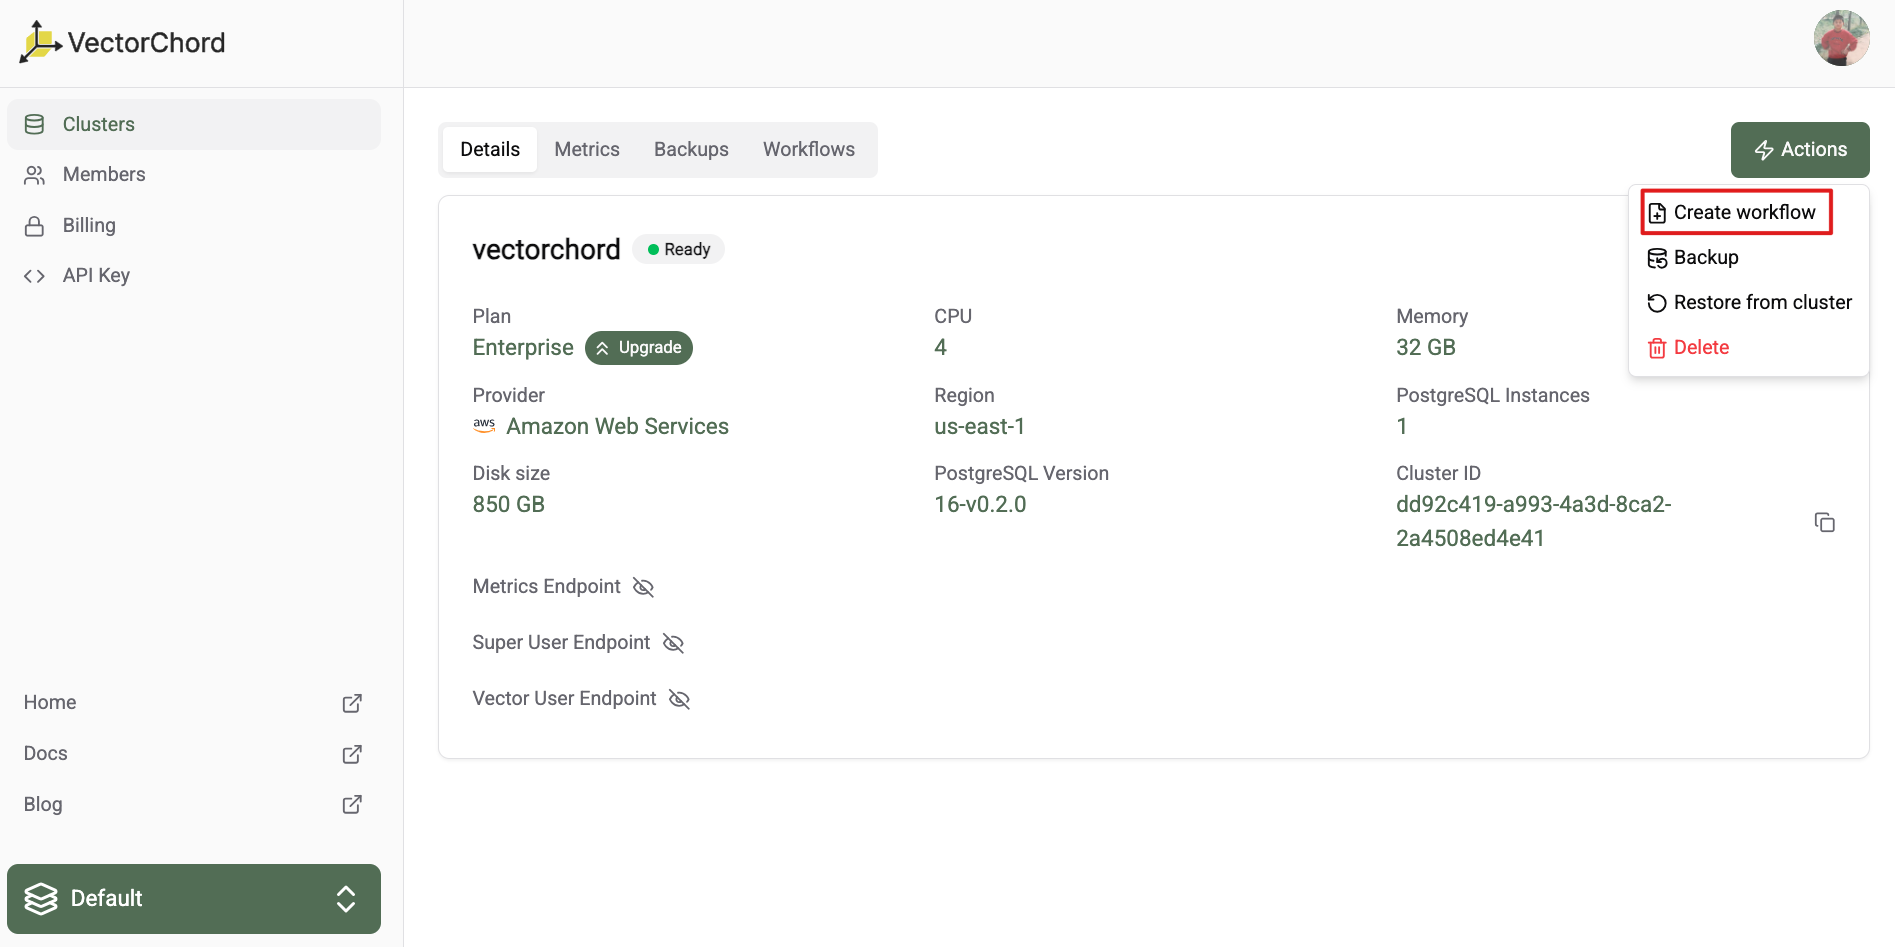
在控制台中,您可以点击 Create Workflow 按钮创建一个新工作流。
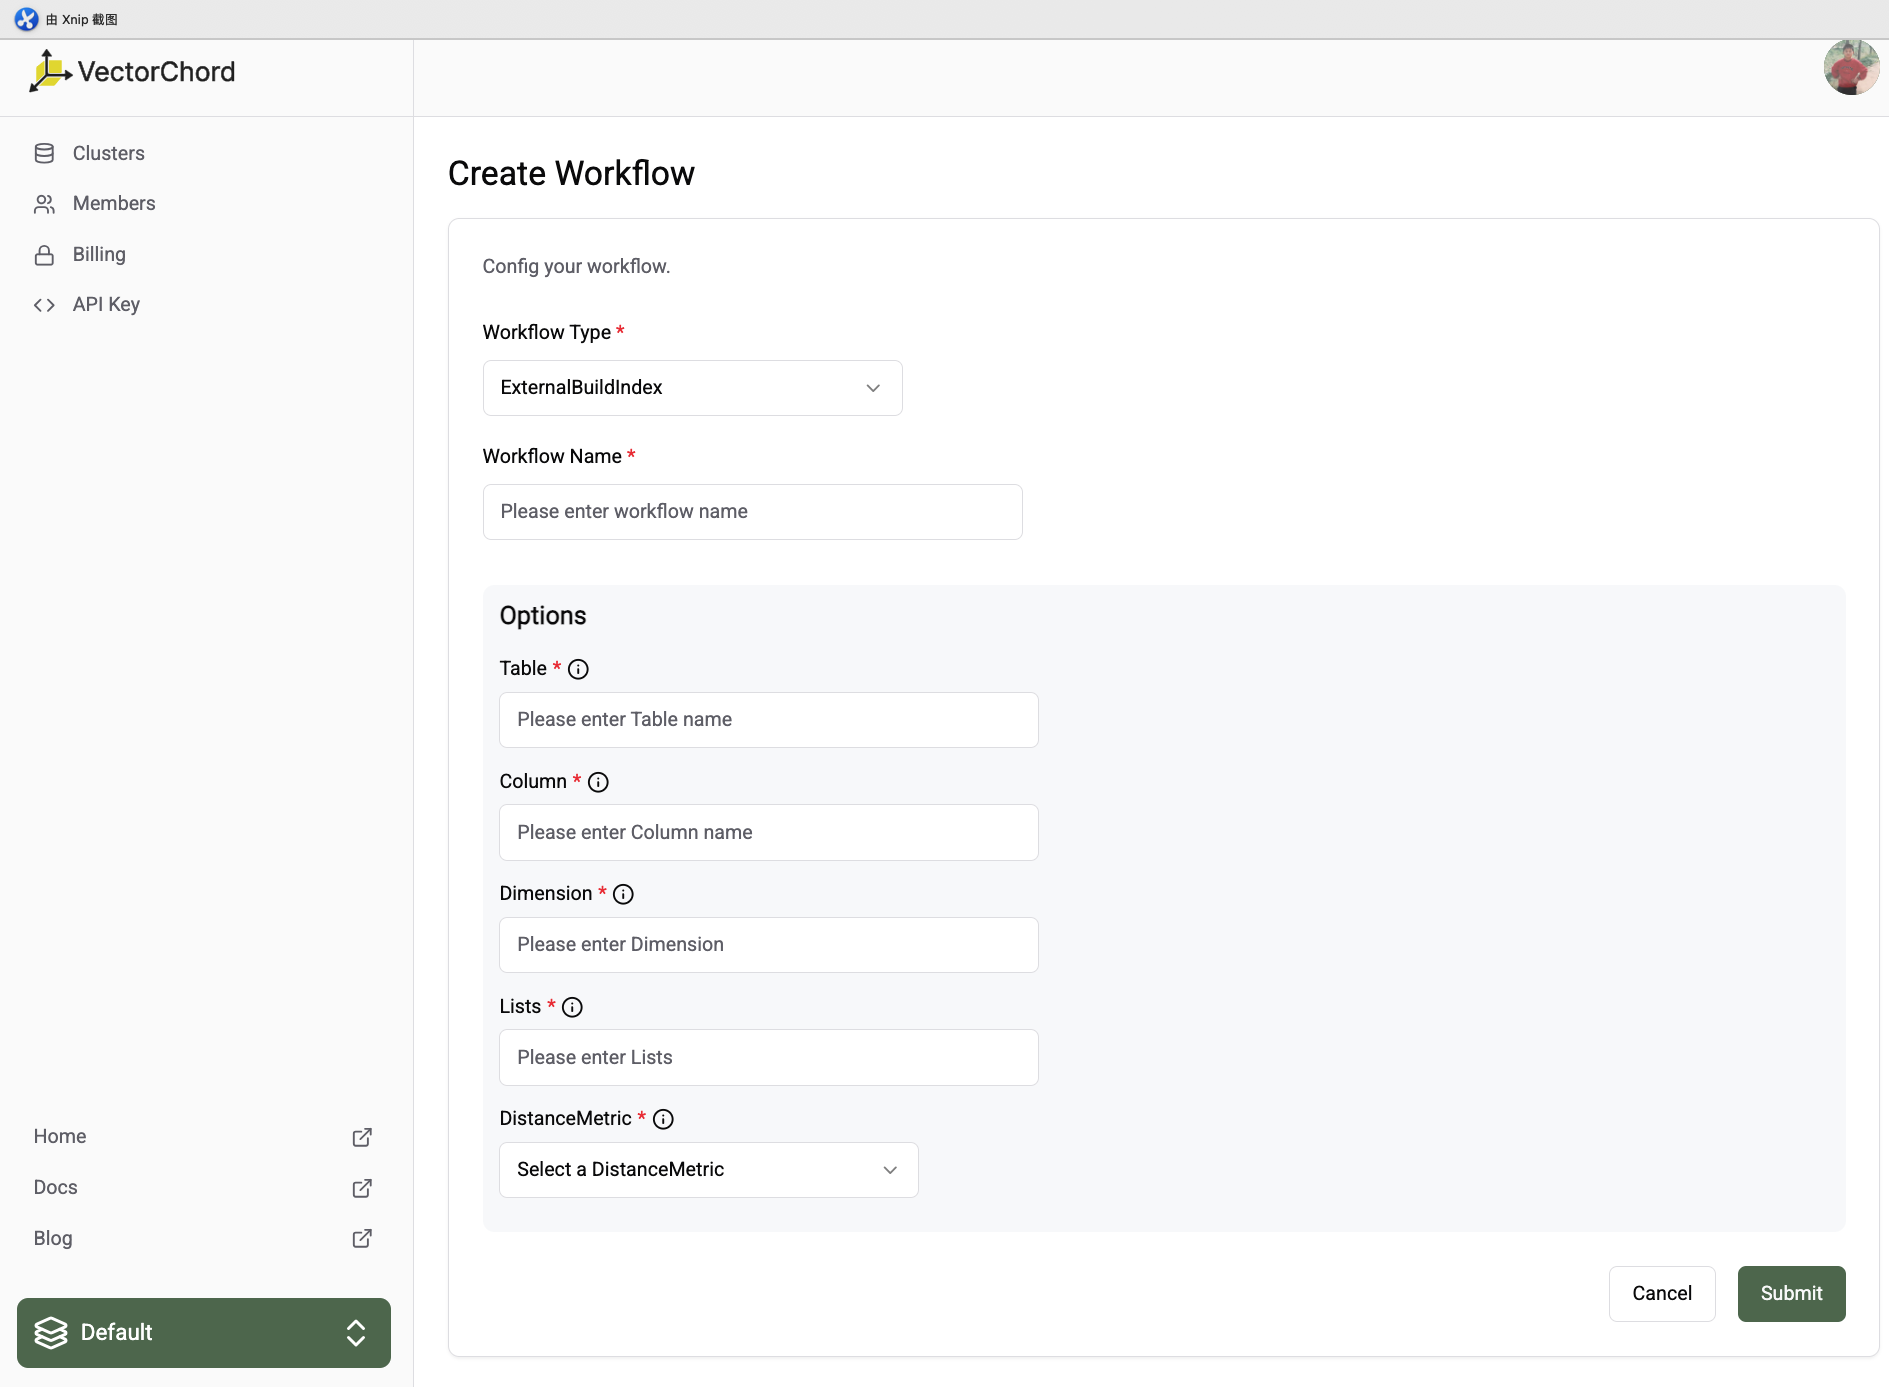
您需要指定以下信息:

  • Workflow Name(工作流名称):工作流的唯一名称。
  • Option(选项):ExternalBuildIndex 工作流的参数选项
    • Table(表名):向量所在的表名
    • Column(列名):向量列名称
    • Dimension(维度):向量的维度
    • Lists(聚类中心数):KMeans 的列表数量(n list)
    • DistanceMetric(距离度量):向量的距离度量方式
      • DistanceMetricCosine:余弦距离(Cosine distance)
      • DistanceMetricL2:欧氏距离(Euclidean distance)
      • DistanceMetricDot:点积距离(Dot product distance)

提交工作流后,工作流将进入 Running 状态。在运行过程中工作流不可操作,整个运行过程可能需要几分钟时间。运行完成后,工作流状态将变为 Succeeded。您可以在控制台中列出所有工作流。
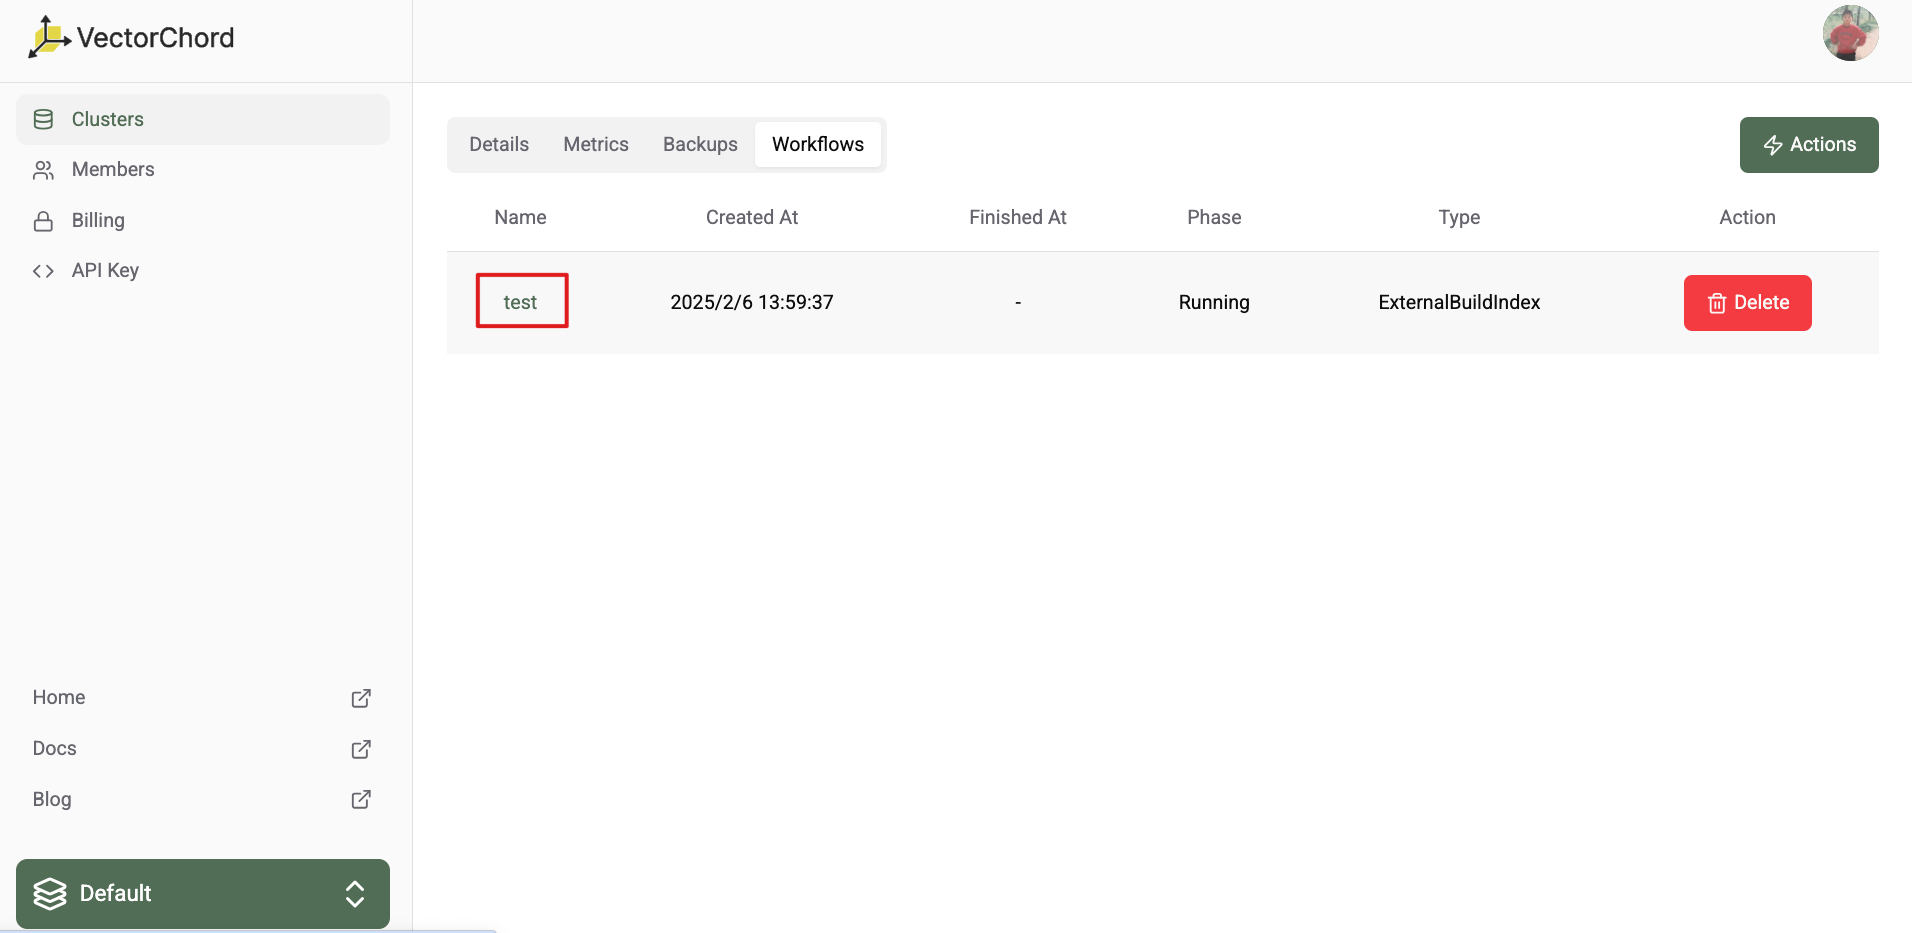
您可以在工作流详情页面查看每个步骤的执行详情。
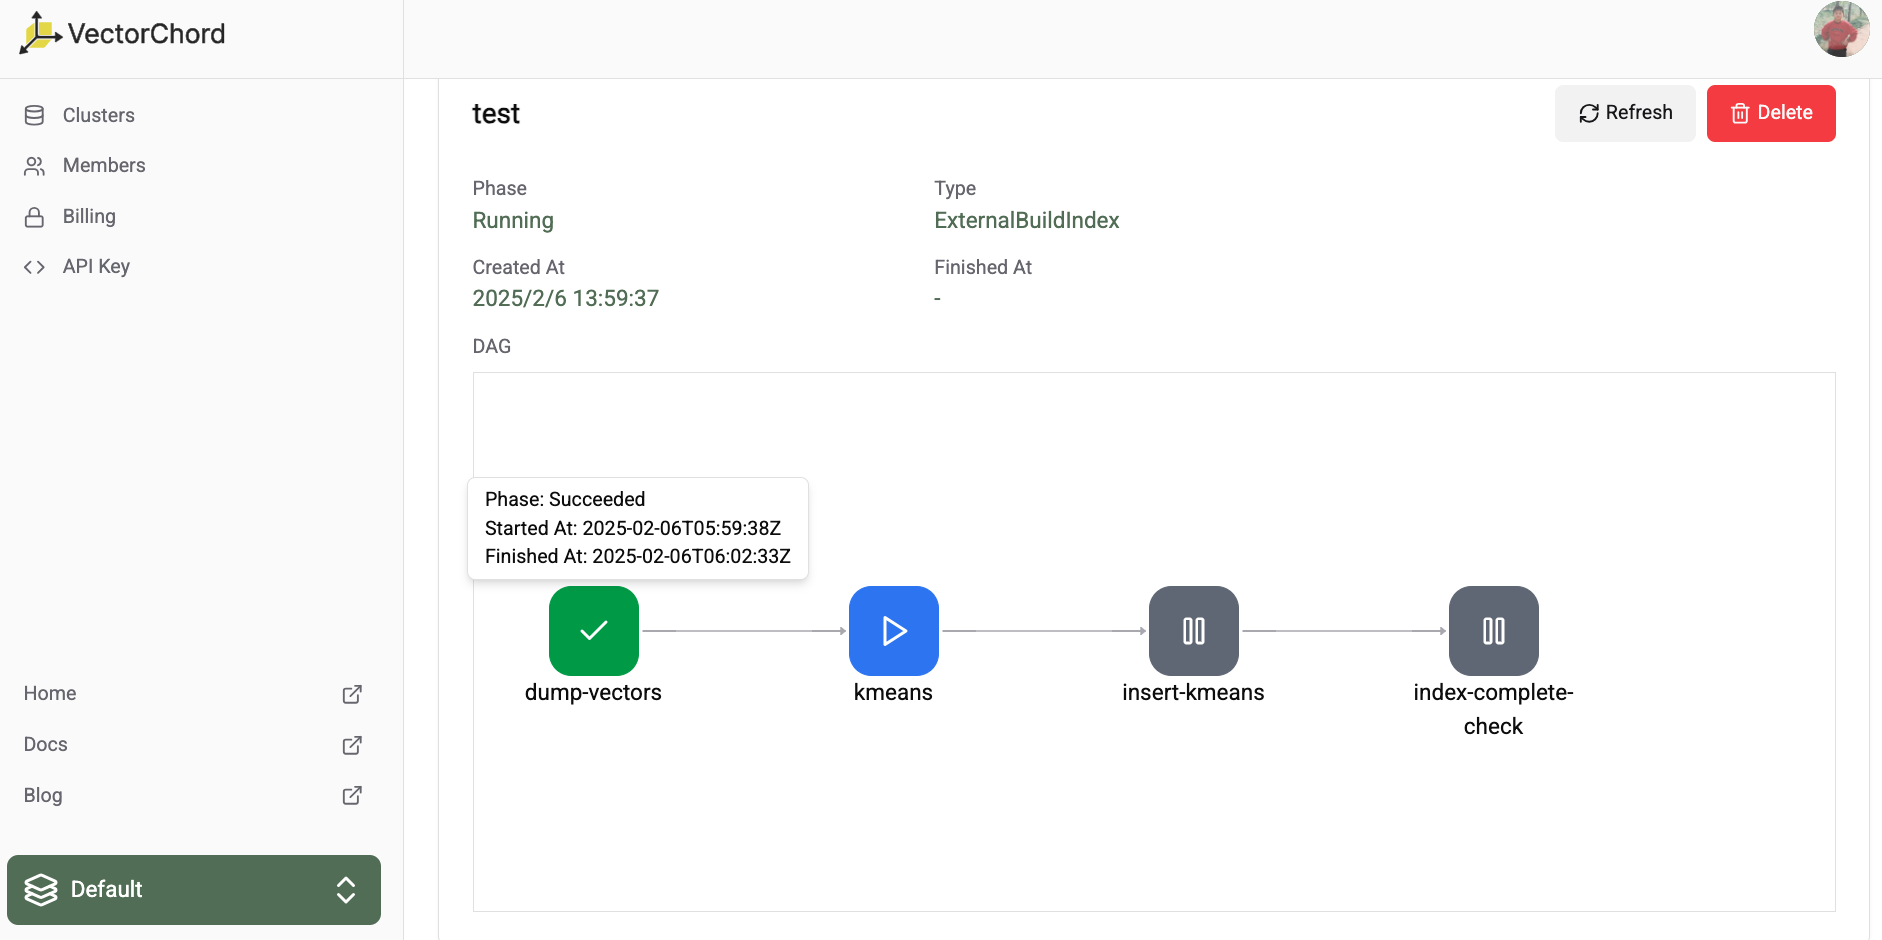
当工作流处于 Succeeded 状态时,您可以验证索引是否已就绪可用。
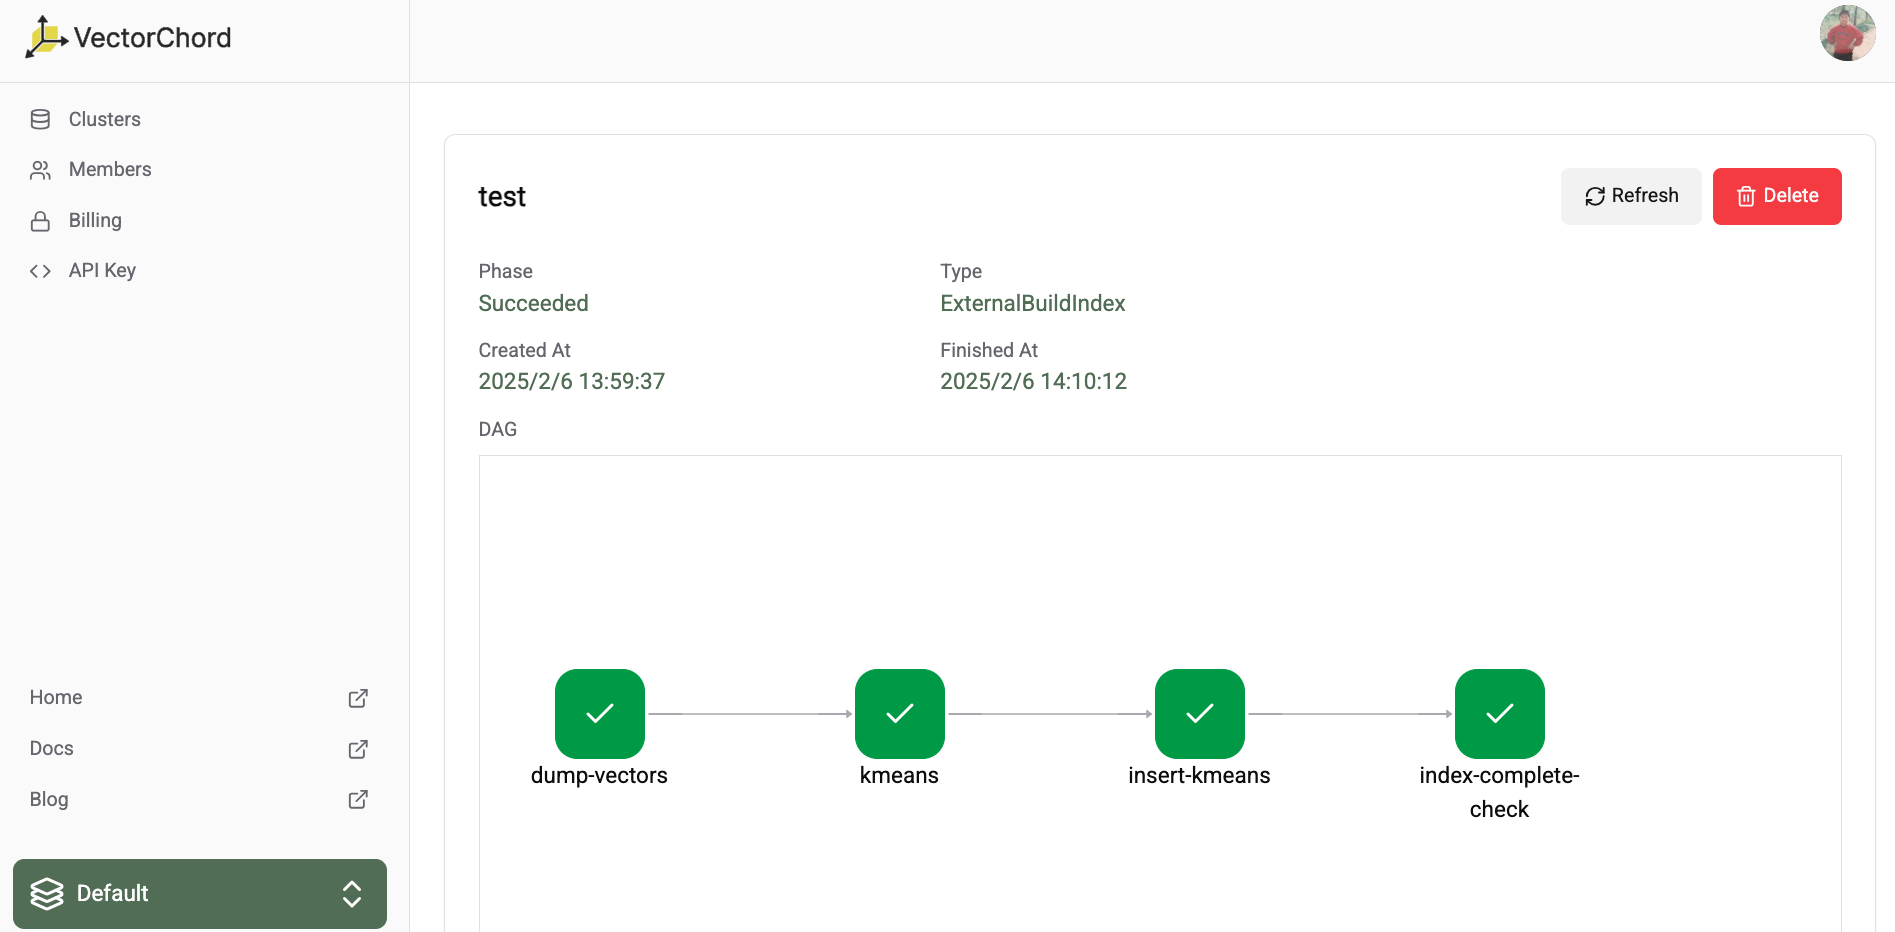
$ psql 'postgres://vectorchord_user:C8bTXXFi2vxA@vectorchord-oews3hvirnsq3vi7.us-east-1-dev.aws.vectorchord.com:5432/vectorchord?sslmode=require'
psql (15.3, server 16.5)
WARNING: psql major version 15, server major version 16.
         Some psql features might not work.
SSL connection (protocol: TLSv1.3, cipher: TLS_AES_256_GCM_SHA384, compression: off)
Type "help" for help.
vectorchord=# EXPLAIN ANALYZE SELECT * FROM sift ORDER BY embedding <-> '[12,47,14,25,2,3,4,7,14,122,90,7,0,0,6,14,0,24,122,22,2,4,6,0,0,10,93,10,6,6,0,0,122,31,9,23,19,9,8,56,122,100,29,19,3,0,0,25,3,9,43,59,76,32,0,0,8,6,10,7,24,58,1,1,81,23,32,68,14,19,10,23,122,13,2,1,4,9,86,122,3,0,0,8,122,95,68,30,9,2,0,2,26,50,44,13,0,0,0,3,12,82,18,7,6,0,0,0,2,20,112,122,6,5,1,0,3,69,122,43,15,1,0,0,0,27,29,21]' LIMIT 5;
------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
 Limit  (cost=0.00..1.85 rows=5 width=532) (actual time=0.644..0.683 rows=5 loops=1)
   ->  Index Scan using sift_embedding_idx on sift  (cost=0.00..73962.25 rows=200012 width=532) (actual time=0.643..0.681 rows=5 loops=1)
         Order By: (embedding <-> '[12,47,14,25,2,3,4,7,14,122,90,7,0,0,6,14,0,24,122,22,2,4,6,0,0,10,93,10,6,6,0,0,122,31,9,23,19,9,8,56,122,100,29,19,3,0,0,25,3,9,43,59,76,32,0,0,8,6,10,7,24,58,1,1,81,23,32,68,14,19,10,23,122,13,2,1,4,9,86,122,3,0,0,8,122,95,68,30,9,2,0,2,26,50,44,13,0,0,0,3,12,82,18,7,6,0,0,0,2,20,112,122,6,5,1,0,3,69,122,43,15,1,0,0,0,27,29,21]'::vector)
 Planning Time: 0.069 ms
 Execution Time: 0.710 ms
(5 rows)

5 - 价格

VectorChord Cloud 免费套餐与企业版计算/存储价格方案。

5.1 - Cloud 价格方案

在 VectorChord Cloud 中,我们提供免费套餐,方便您在云端环境中学习和体验全托管的 VectorChord 服务。

免费套餐

在 VectorChord Cloud 中,我们提供免费套餐(Free Tier),方便您在云端环境中学习和探索全托管的 VectorChord 服务。每位用户可以使用免费套餐创建仅一个集群并在其中存储向量数据。免费套餐包含以下限制:

  • 共享计算资源
  • 受限的 WAL(预写式日志)和 PGData 存储空间(5Gi)
  • 仅支持 AWS T3 XLarge 实例类型
  • 预估可容纳约 10 万条 1024 维向量,或者插入约 2.5 万条 4096 维向量。

企业版

在企业版(Enterprise)套餐中,您可以拥有独享集群,并获得以下特性:

  • 独享计算资源
  • 更大的 WAL 和 PGData 存储空间
  • 支持更多实例类型
  • 多种容量配置选项

服务器资源规格

免费套餐

企业版

性能型(Performance):针对查询性能进行优化。
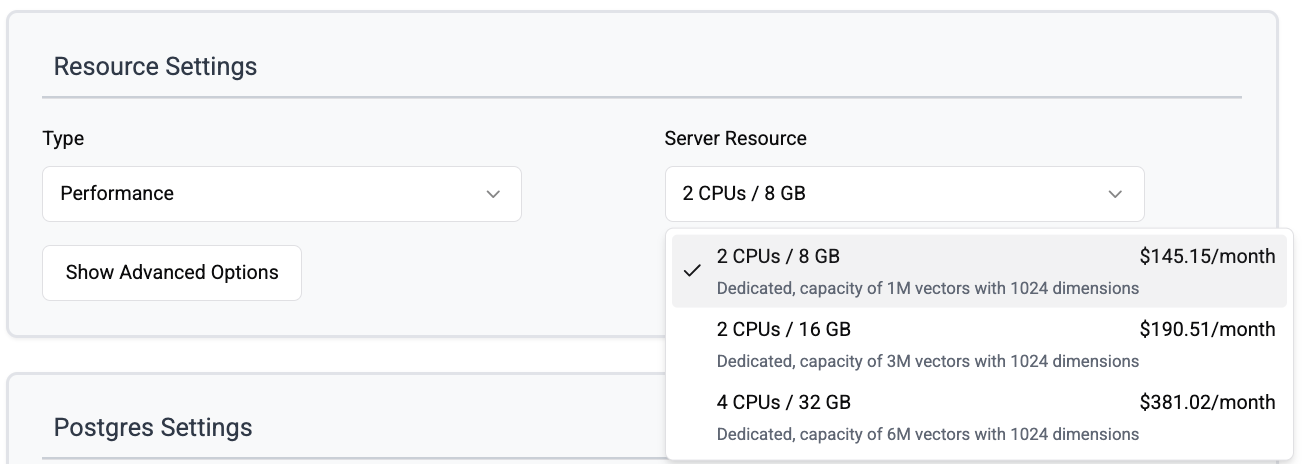
容量型(Capacity):针对存储容量进行优化。
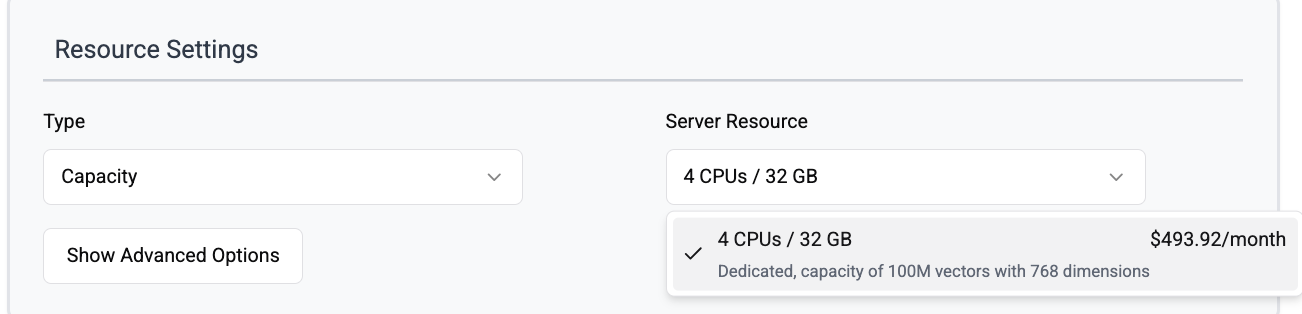
6 - 计费与支付

管理信用卡支付方式和账单发票。

6.1 - 绑定信用卡订阅

VectorChord Cloud 支持信用卡支付。您可以添加多张信用卡,或点击 Delete 移除已有信用卡。已添加的信用卡将显示在计费页面上。
提示

计费以项目(Project)为单位,而非按用户计费。每个项目都有独立的账单发票,您必须为每个项目分别添加支付方式。

VectorChord Cloud 支持信用卡支付。您可以添加多张信用卡,也可以点击 Delete 移除其中部分信用卡。已添加的信用卡将显示在计费页面上。
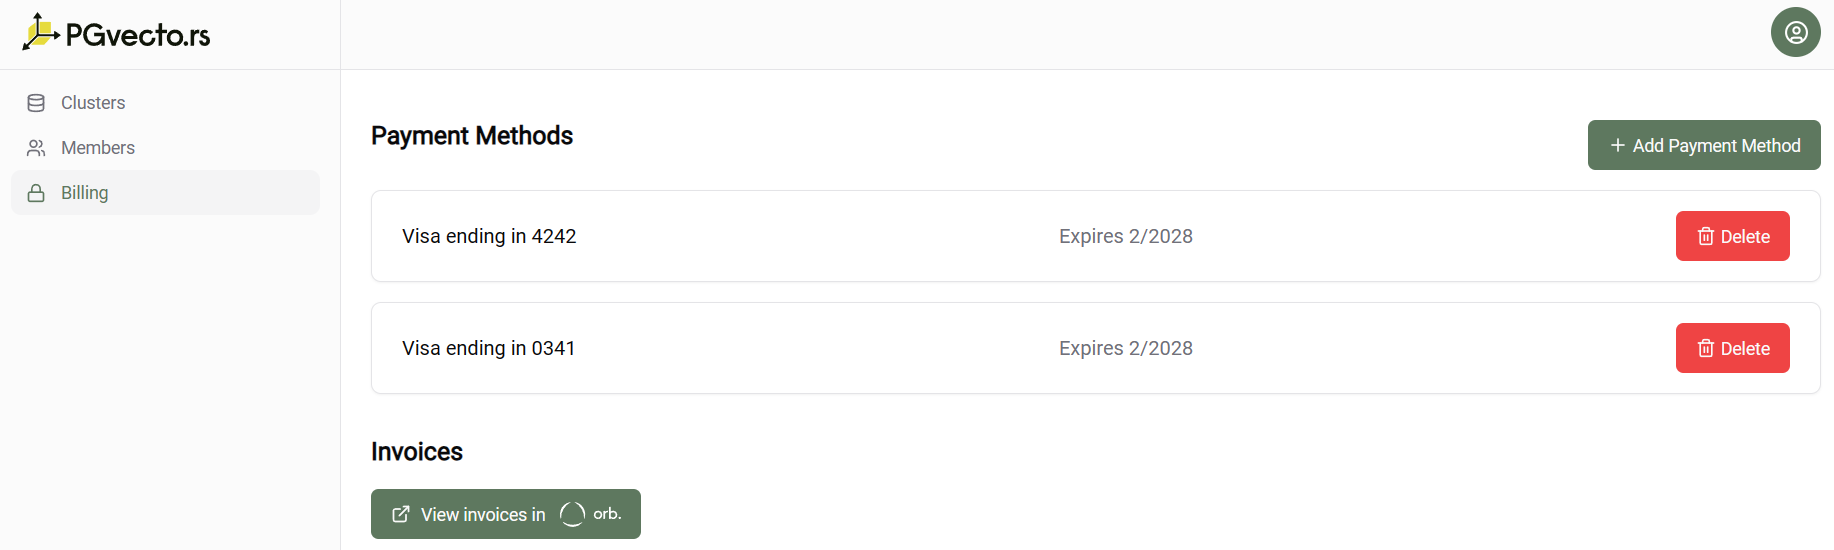
点击 Add Payment Method 按钮将跳转至 Stripe 的添加信用卡页面(Add Credit Card page),我们将在该页面发起信用卡预授权请求。此请求不会产生任何实际扣费。添加请求完成后,新信用卡即可使用并显示在 Billing 页面上。
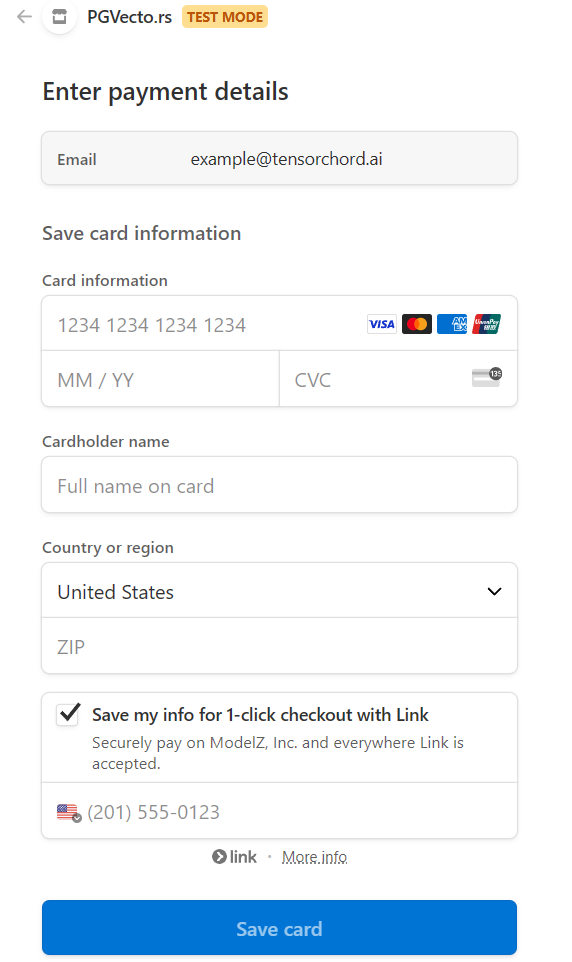
警告

每个项目的最后一张信用卡无法删除。

6.2 - 查看账单发票

目前 VectorChord Cloud 使用 Orb 作为计费服务商。在 Billing 页面中,您可以点击 View invoices in Orb 前往 Orb 客户门户。

目前 VectorChord Cloud 使用 Orb 作为计费服务商。在计费(Billing)页面中,您可以点击 View invoices in Orb 前往 Orb 的客户门户(Customer Portal)。在该外部页面上,您可以执行以下操作:

  • 查看计算资源和存储空间用量
  • 查看已支付、已开具以及草稿状态的账单发票
  • 支付自动扣款失败的账单发票

查看资源用量

在 Customer Portal 的 Overview 页面上,您可以通过 Current Billing Period(当前计费周期)区域查看近期用量:
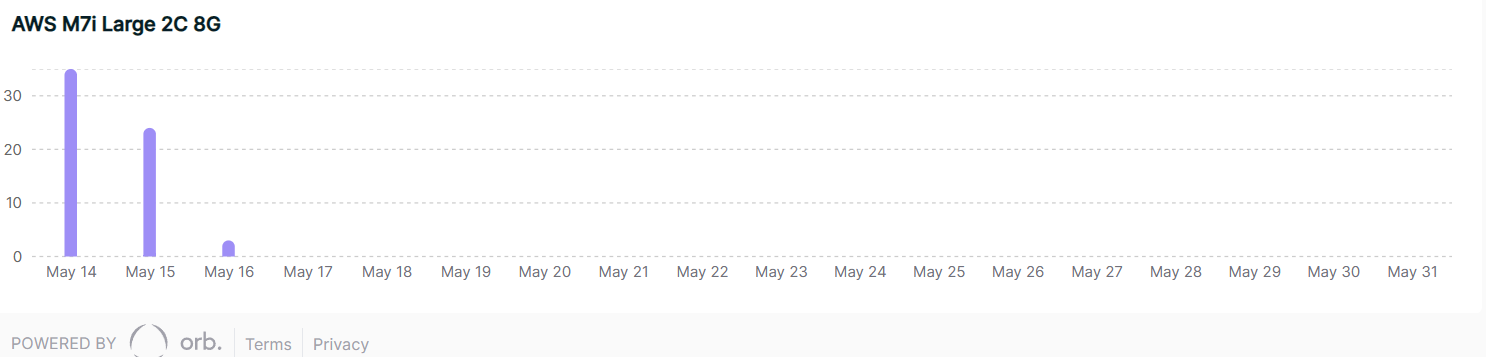
  • 标题以 AWS 开头的柱状图表示计算资源用量,单位为小时(h)。
  • 标题以 EBS 开头的柱状图表示磁盘空间用量,单位为吉字节·小时(Gi*h)。

查看历史账单发票

在 Customer Portal 的 Invoice History(账单历史)页面上,您可以查看所有历史账单发票及其随时间变化的资源用量。
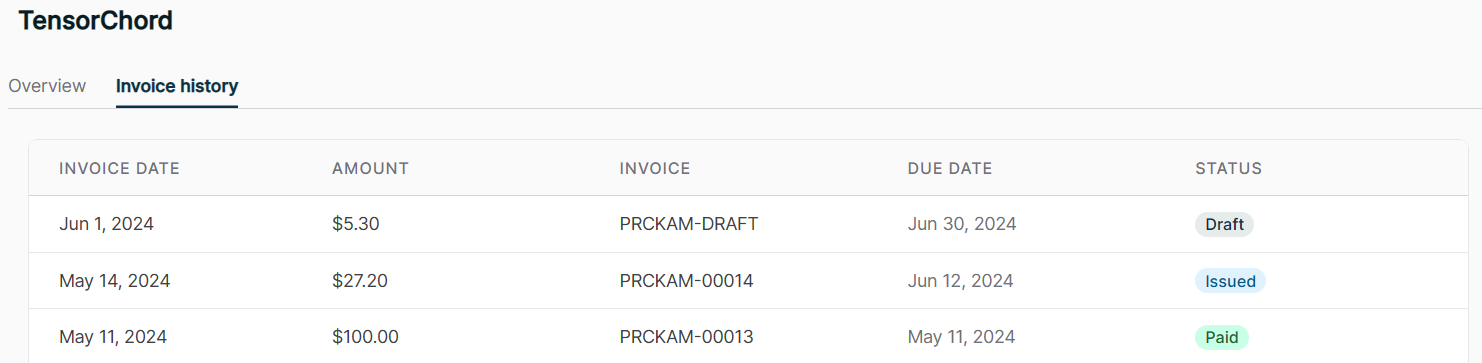
点击任意一行即可查看该账单发票的详细明细。
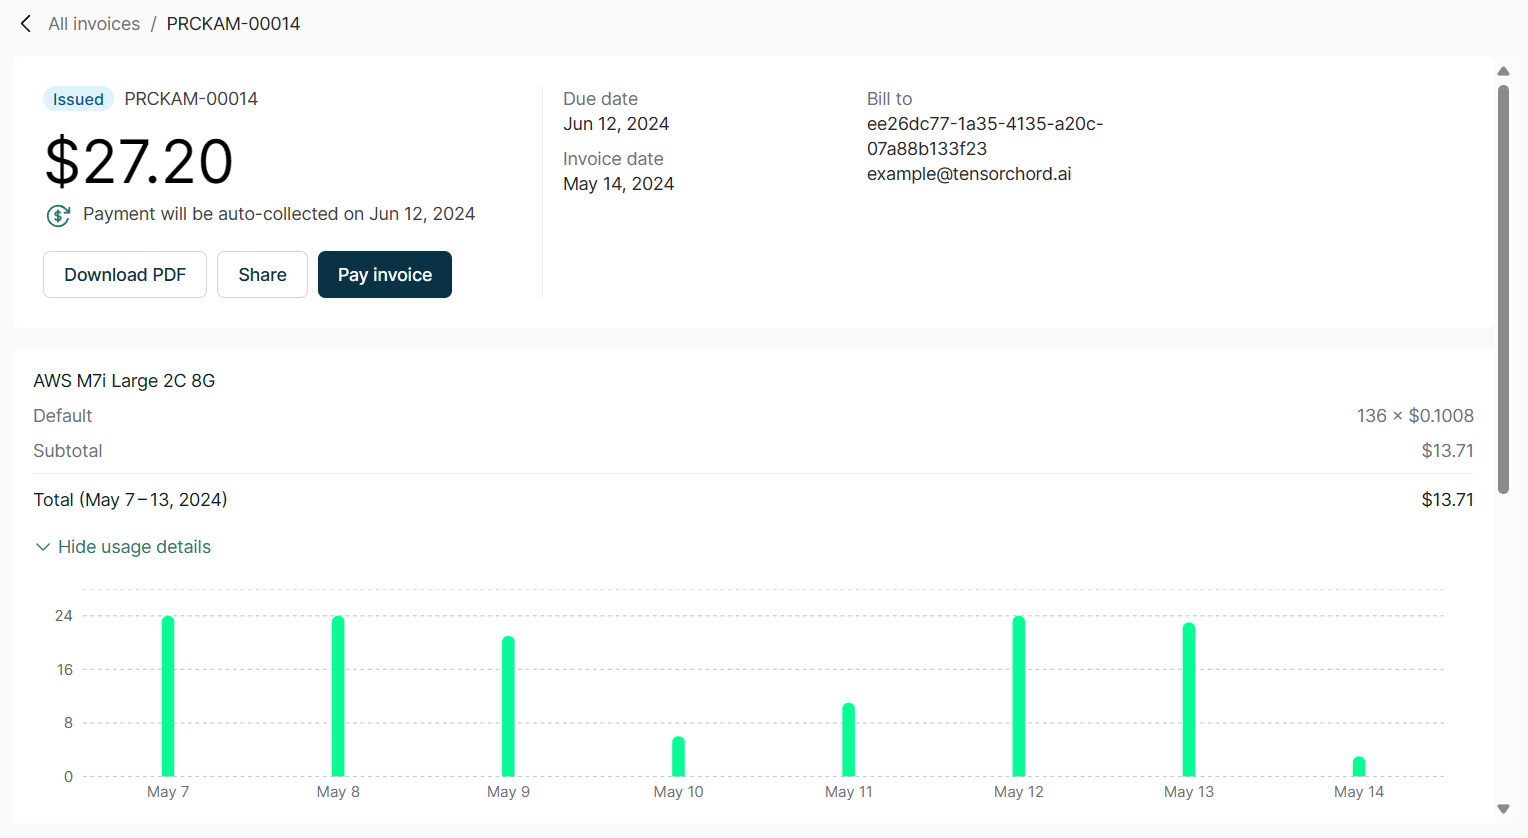
手动支付未扣款成功的账单

对于每张到期的账单发票,VectorChord Cloud 会在一周内自动尝试扣款 3 次。如果所有尝试均失败,您的项目将被暂停(Suspended):

  • 您将收到一封电子邮件,通知您该项目已被暂停
  • 您将无法在该项目下创建新集群
  • 该项目下现有的集群将被暂停运行
  • 被暂停集群中的数据将保留 7 天

这些账单发票会显示在 Overview 页面的 Unpaid Invoices(未付账单)区域中,状态为 failed 或 issued,您可以手动完成支付。

7 - 配额与限制

VectorChord Cloud 上的资源配额与操作限制。

7.1 - Cloud 限制说明

了解在 VectorChord Cloud 上进行操作时需要知晓的配额与限制。

了解在 VectorChord Cloud 上进行操作时需要知晓的配额与限制:

  • 免费套餐:每个账户最多只能创建 1 个免费套餐集群。
  • 项目:每个账户最多只能归属于 5 个项目。
  • 目前暂不支持高可用(HA,High Availability)模式。

8 - 故障排查

诊断并解决 VectorChord Cloud 的常见运维问题。

8.1 - 故障排查

如果集群状态变为 NotReady,您可以检查集群的监控指标,查看 PGData 是否仍有可用空间。

连接问题

1. 集群无法访问,请检查以下内容:

如果集群的状态显示为 NotReady,您可以检查集群的监控指标,查看 PGData 是否仍有剩余可用空间。

警告

请勿删除您的集群,否则将导致数据丢失。

解决方案:

  • 您可以将集群扩容到更大的存储规格以解决该问题,具体操作请参阅仅扩容集群存储空间。升级完成后,集群状态将恢复为 Ready,并可正常访问。

如果上述方案未能解决问题,请通过 Discord 联系我们,我们很乐意为您提供帮助。